智能体设计与应用 · 第 5 次课
01 — 13
序 · 回扣
中山大学岭南学院 · 张一帆
+
+
01 序 · 回扣
☰
←
→
研究生专业学位选修课 · 2026 秋 · 第三周
一队子代理,个人知识库
智能体设计与应用 · 第 5 次课
AI 岭南学院
0 走到哪了
第三周,开始造系统
1
第一周
第 1 次课 认识智能体与应用场景第 2 次课 理解技能与确定场景2
第二周
第 3 次课 造技能,接数据第 4 次课 自动化办公与团队协作3
第三周今天
第 5 次课 · 上午 子代理与个人知识库第 6 次课 · 下午 企业分享 · 极视角4
第四周
第 7 次课 常驻 Agent第 8 次课 主题分享与结课展示
前四次课你手上攒了一个技能、一个连接器、一个闹钟、一个项目。今天上午把它们装成系统 。
下午极视角 的企业管理人员讲 AI 怎么落地。上午这两样带着去对照,看他们的活怎么分、资料放在哪。
0 今天上午
两轮,每轮先讲后练
第一轮 · 给它一队人 复习第 2、3、4 次课。练习一 派三个子代理,一次课一个,各写一张复习卡;再派一个审阅的回原文逐条核,最后照卡搭一个课程助教,新建任务考考它第二轮 · 给它一个知识库 助教只认前四次课,今天的新消息它不知道。练习二 换一个文件夹,用预装的技能 personal-wiki,把收件箱里这门课的资料整理成你的知识库,再放进今天的课堂安排,关掉对话再问个人作业二 · 三位同学上台 报名的三位打开分享链接,对着对话讲,当场用今天的两样说一条改进
今天两个练习都用这门课自己的资料 。练完你带走一个课程助教、一个能接着用的个人知识库。
0 第 3、4 次课问卷
上周你们卡在哪,今天先回答
35 / 70
交了问卷。下面的数字只代表交了的人,都是自报
21
想多讲的第一名:拆成几个子代理并行干活,结果怎么合回来
问得最多 · 32 条里约 10 条 学了怎么用到自己的工作 今天哪一段回答:练习二的知识库,课后放进你的简历和工作说明,问跨领域的问题
想多讲第二 · 16 人 怎么建一个中台,让它记住我的上下文 今天哪一段回答:第二轮整轮,个人知识库就是大纲里的个人信息中台
留到第 7 次课 · 10 人 怎么让它不开对话也替我干活 常驻那一课接着讲
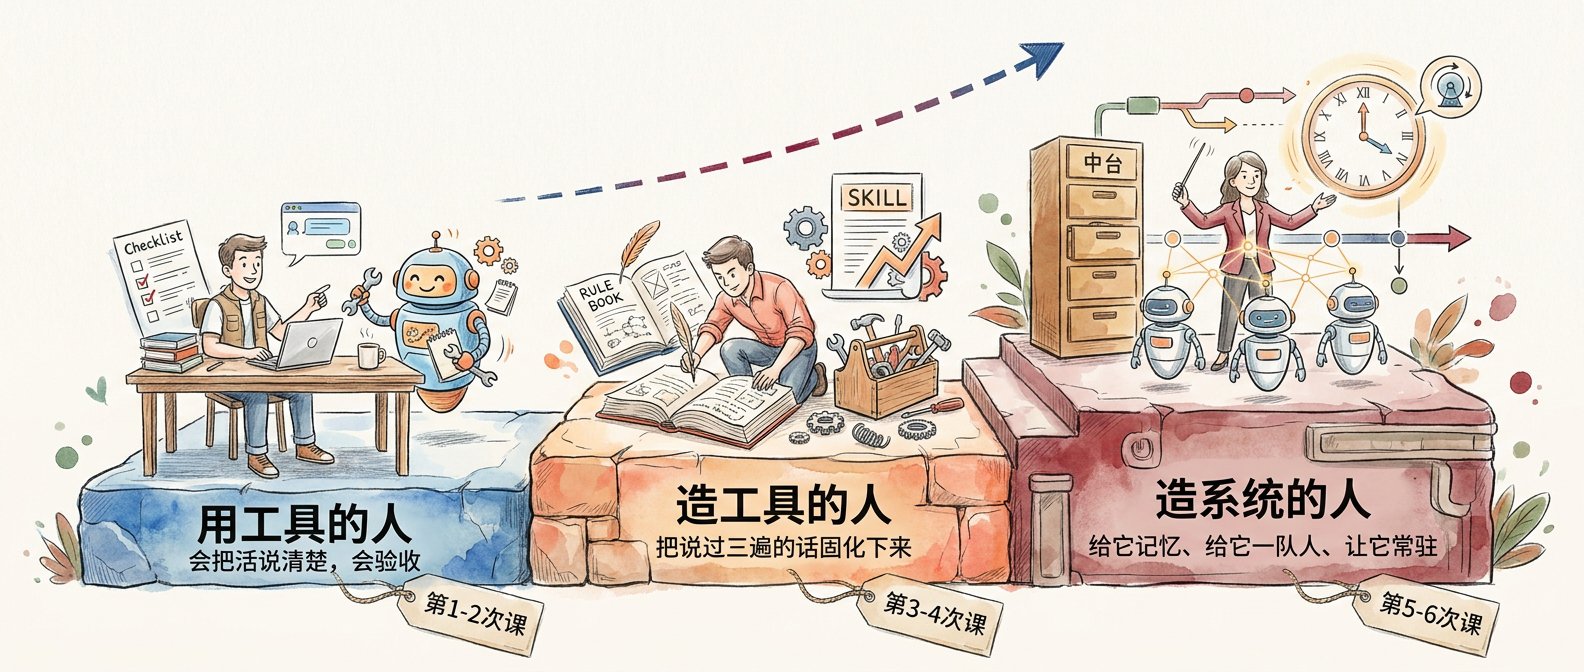
0 你在哪一层
今天上第三层
第一层 · 用工具 把活说清楚、会验收、会装别人的技能。第 1、2 次课
第二层 · 造工具 技能、连接器、一个闹钟、一个团队项目。第 3、4 次课
第三层 · 造系统 今天给它一队人,再给它一个知识库 ;第 7 次课让它常驻
I 先想一想
第 2、3、4 次课的资料,还是叫三个人分头整理?
分头整理快。可三个人交回来的格式不一样、说法对不上,谁来核,谁来合?
I 先补一个概念 · 回到第 1 次课
智能体,就是大模型装上手脚架
大模型 LLM大脑 在远端服务器上,只读你给它的字,再吐出字。它只会把话接下去
DeepSeek · Kimi · GLM 手脚架智能体 WorkBuddy
手脚架怎么管住大模型 每次先递给它一摞字,最前面那份叫系统提示词 。记忆、技能目录、AGENTS.md 都在这一摞里,下一页拆开看
循环是什么 它自己想一步、做一步、看结果,不对再改,做完才交 。今天的子代理、第 7 次课的常驻,都从这一样长出来
大模型可以换 WorkBuddy、Claude Code 都能换大模型。同一个模型再叠一份设定 ,又是一个智能体
I 系统提示词落到 WorkBuddy 上
你打第一句之前,它先读完这一摞
开工时从上往下读,读到最底下才轮到你这一句
WorkBuddy 自带的系统提示词 本机 5.8.3 版约三万一千字符,换算约七千 token,界面上看不到 。里面写着桌面和下载只扫不改、讲解时主动画图、只装你点头的技能,还写着想省上下文就派子代理去查
你写的 本地长期记忆文件 称呼、习惯、常用的路径,换个任务也记得
第 7 次课写 · 设置 → 记忆与进化 你装的 技能目录 每个技能只摆名字和描述,挑中了才读全文
第 2 次课 · docx 技能 1272 KB,描述 787 字符 你写的 AGENTS.md 你是谁、用什么口径,这个工作空间里每个任务都读
第 1 次课写的 你这一句 你打的这句话 复习第 2、3、4 次课,每次课写一张复习卡
每次都不一样
前几次课写的 AGENTS.md、装的技能,都接在自带那份后面,那份不动 。你这一句排最后。
WorkBuddy 5.8.3 本机安装目录的系统提示词模板与拼装代码,2026-10-17 查;token 数为 codebuddy 命令行实测
I 这一摞里你自己写的那张
AGENTS.md,每个任务开头读一遍
工作区根目录 / AGENTS.md 第 1 次课样例节选
# AGENTS.md · 陈某某
## 一、我是谁
深圳一家股份制银行分行的对公客户经理……
## 二、我的口径
- 收入以财务确认口径为准,签约口径只看势头
## 三、产出要求
- 材料里没有的留空并标注,不推测、不补全
## 四、红线
- 删文件、对外发送、动资金,先停下来问我
什么时候读 新建任务、发第一句时,WorkBuddy 把它垫在你这句前面。任务做到一半改了它,新建任务才读到新的
写什么 每个任务都用得上 的,你是谁、口径、产出要求、红线,八千字以内
不写什么 你没说过的、常识、只属于这一次的活。一类活怎么做,写成技能
对照 · 练习一的课程助教 课程助教不写在这里,它要单独建成一个专家 ,人设叠在它自己的系统提示词上。后面讲
今天用到 · 练习二 · 个人知识库 练习2_知识库/ 根下自带一份老师写好的 AGENTS.md,讲清每个目录放什么、先读什么 。两个技能预装在 .workbuddy/skills/
WorkBuddy 5.8.3 本机安装目录的系统提示词模板与拼装代码,2026-10-17 查
I 子代理是什么
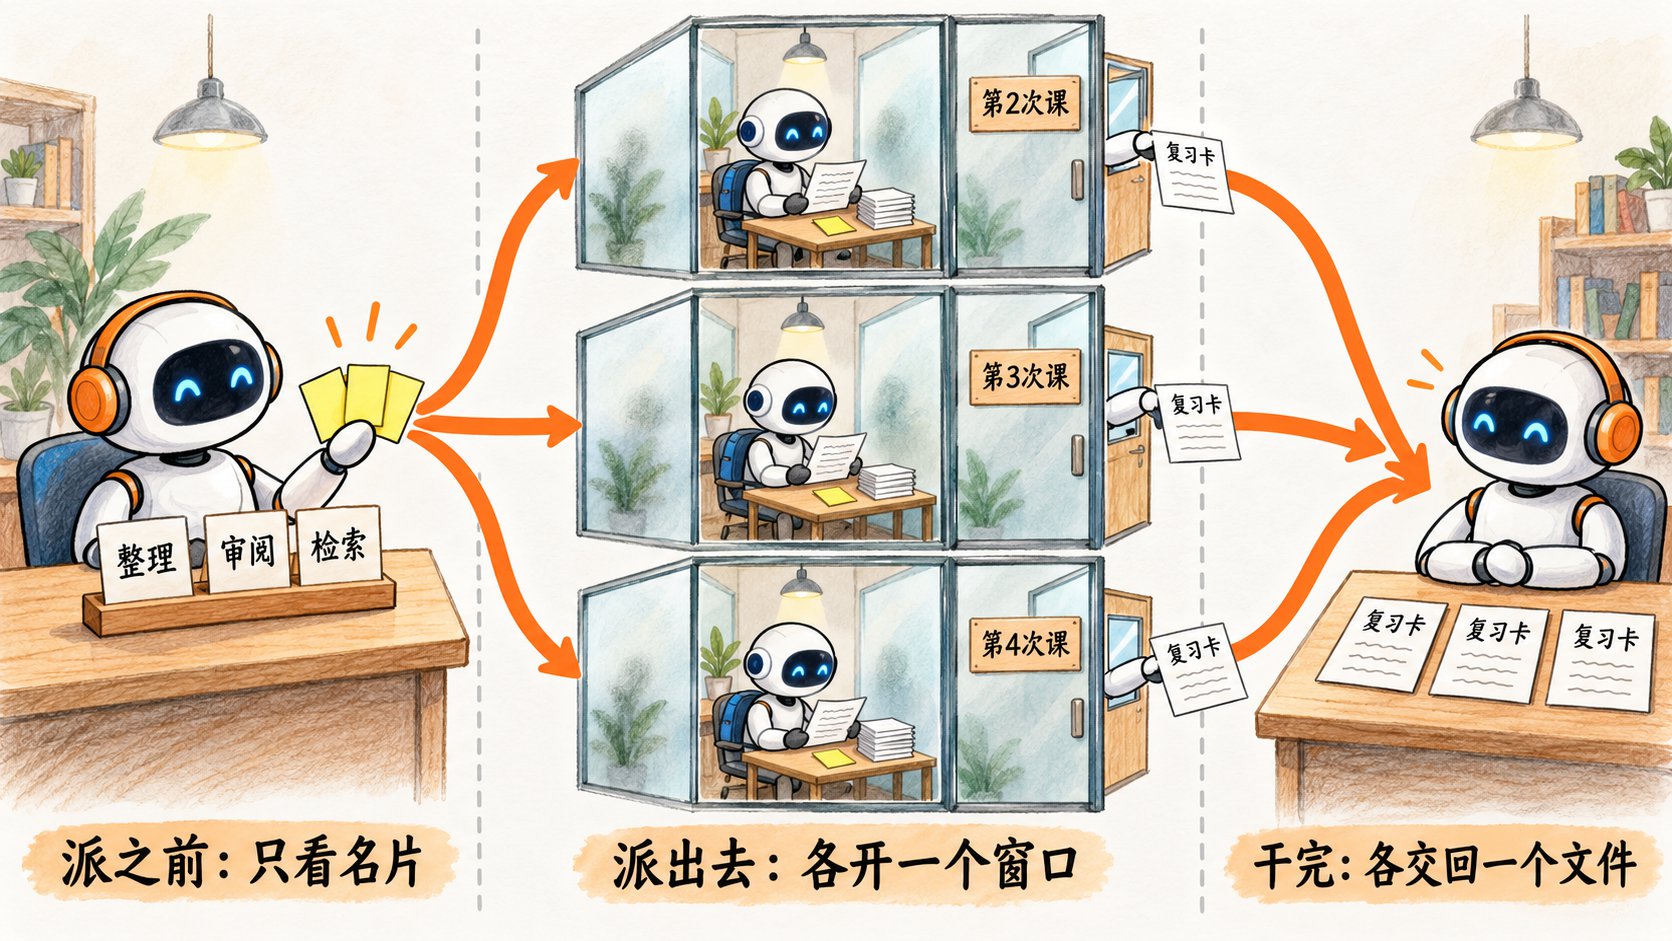
子代理,就是再起一个智能体
派之前 · 只看名片 挑谁去,主代理凭的是每种子代理的一段简介 ,跟第 2 次课的技能目录一个道理
派出去 · 各开一个窗口 先读自己那份设定和便条,再去读文件。你和主代理聊过的每一句,它一句都看不到
干完 · 各交回一个文件 交回一张复习卡、回一句话。读过什么、想过什么都不带回来 ,主代理只读那份文件
第一轮 · 记住一句
子代理最要紧的,自己的上下文
自己一份设定,自己一个窗口,干完只交回一个文件。只要结论的活交给它;要边做边改方向的,留在主对话里。
I 一个人干,会出什么事
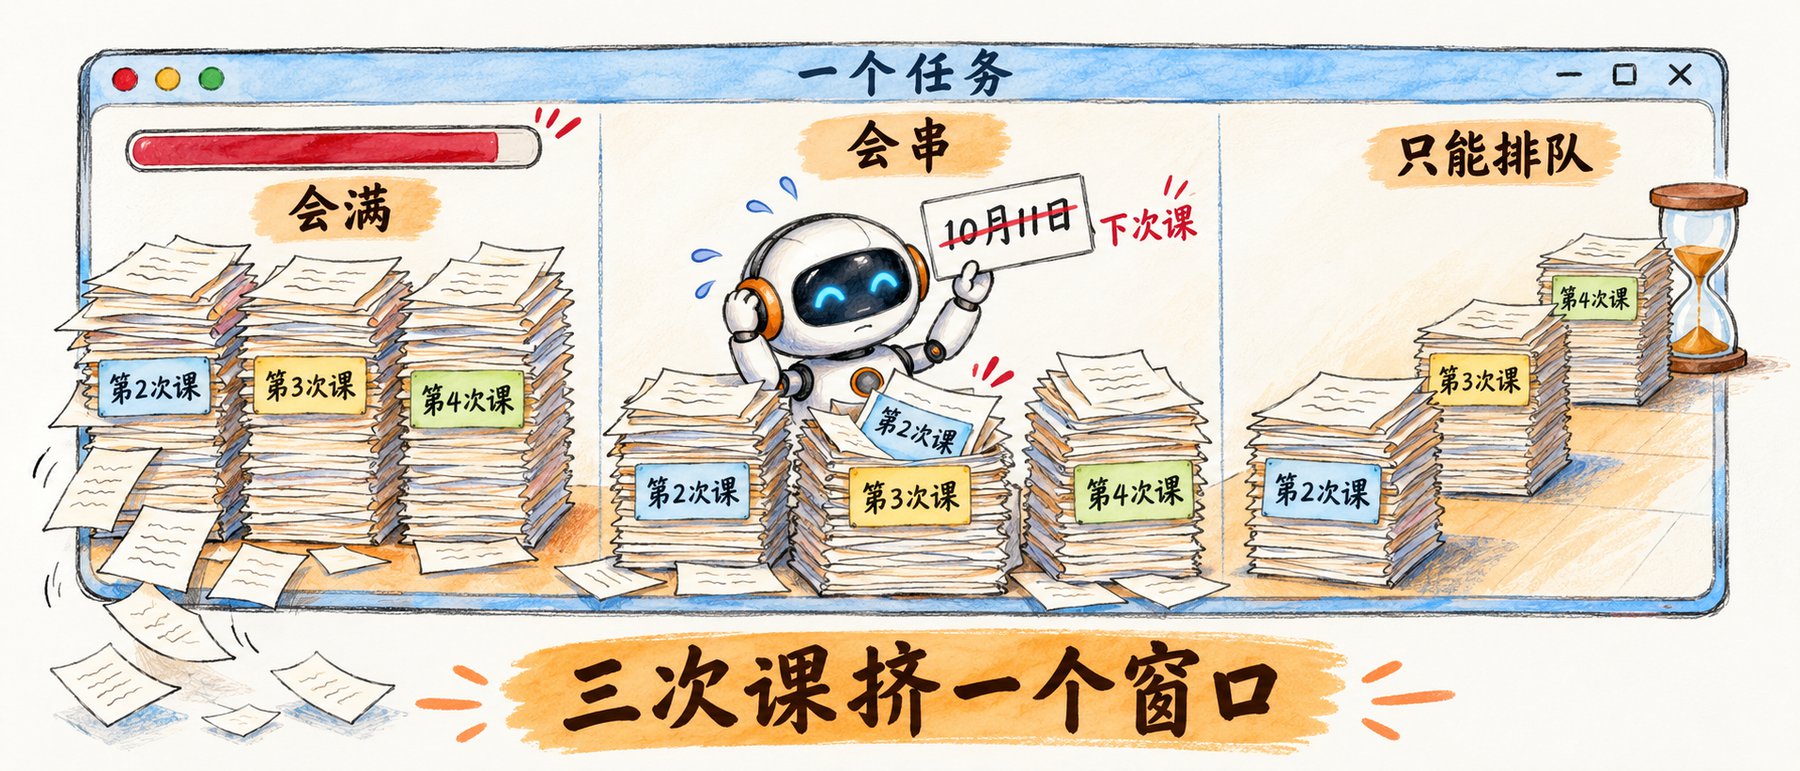
三次课的资料挤进一个窗口
窗口会满 六份快照加一份录屏逐字稿,六万多字,越聊越满。快满时前面的被压缩,它不告诉你压掉了哪段。接龙游戏的遗忘
互相串 写第 3 次课那张时,第 2 次课说的截止日还在窗口里,哪次课说的哪句容易串 。接龙游戏的污染
只能排队 三次课谁也不靠谁,在一个任务里却只能写完一张再写下一张
I 先看人怎么分工 · 爱马仕与广州狮岭
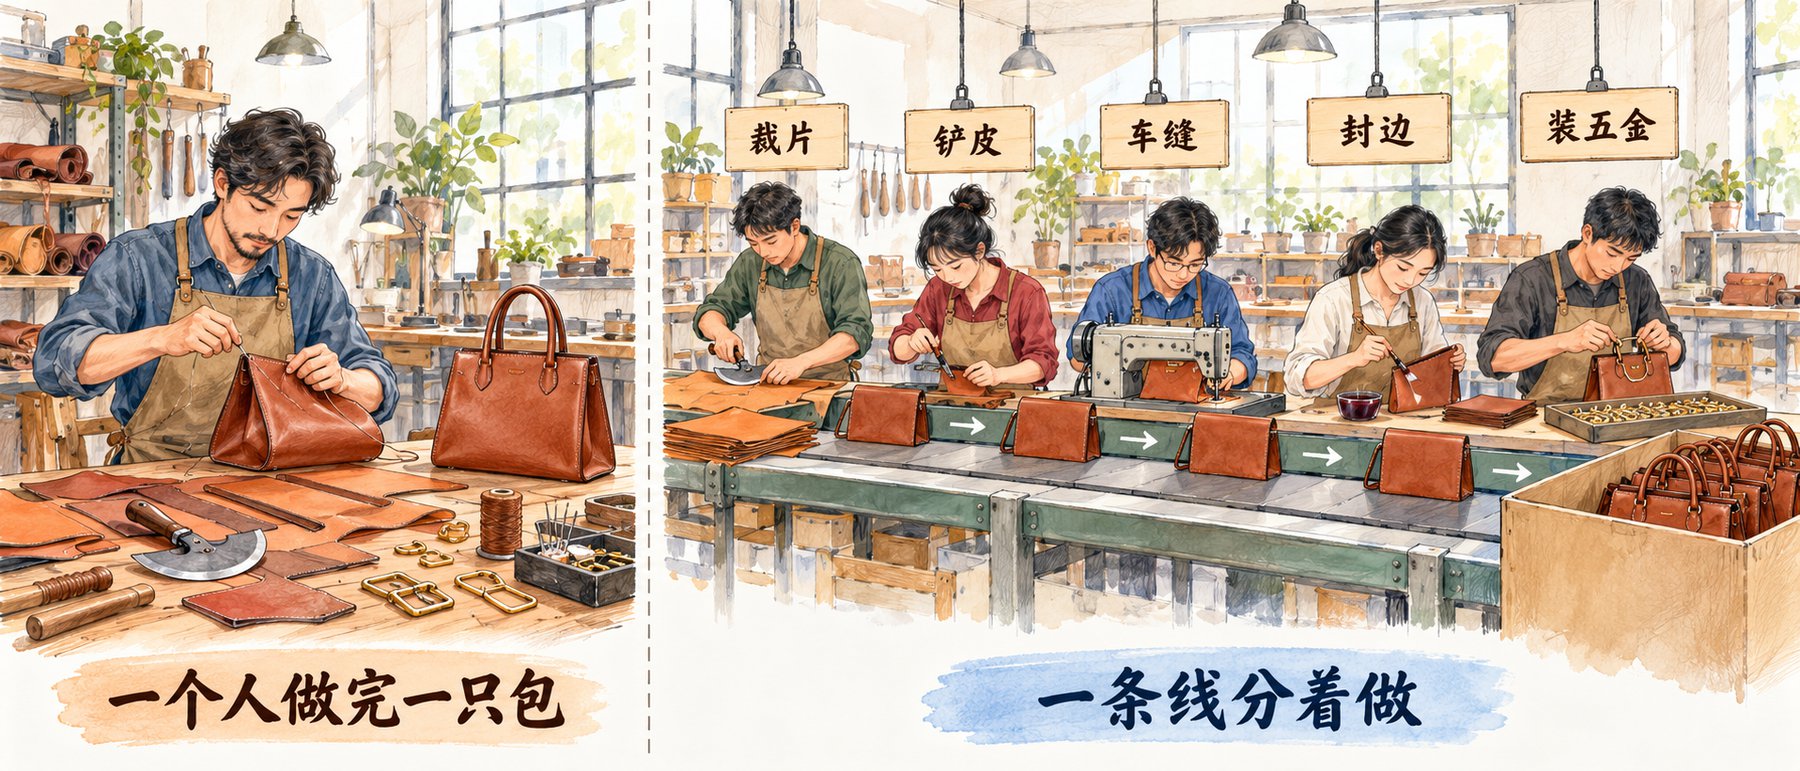
一只包,上百道工序分着做
一个人做完一只包 爱马仕的包由同一位工匠做完。样样都会要学 18 个月,一只 Kelly 包至少做 15 小时
一条线分着做 一只箱包的工序可能多达 140 余道 。狮岭不少小厂只接其中一两道,比如绣花、五金
换到 AI 这里 熟练换成每人一份专门的设定 ,一条线同时开工换成各开一个窗口 。下一页就是这两样
AFP · Hermès ouvre en Gironde sa 19e maroquinerie(FashionUnited 转载)· 2021-09-10;Hermès 官网 · La nouvelle Maroquinerie de Guyenne;丁莉 · 21 世纪经济报道《年产 7 亿只包,广州狮岭“箱包王国”的数字化试验》2024-10-11;薛德升、林韬、黄耿志《珠三角外向型制造业非正规部门的形成发展机制》,地理研究 2014 年第 4 期
I 为什么要派
派一队人,图两样东西
价值一 · 分工并行
图的是快
三次课同时写,排队的时间省下来
前提一,几样活谁也不靠谁
前提二,每份够大、各读各的资料 ,不然省下的时间被重读吃掉
价值二 · 专人专项
图的是准
每人一份专门的设定,窗口里只有这一次课,说法不串
审阅的只核不改,换一双没看过过程的眼睛
靠写给它的那份设定,就是第 1 次课交代六件事那一套
常见三种分工,各靠哪一样
调研型 · 并排 一次课一个,同时跑,各交一份 靠价值一
审阅型 · 换双眼睛 不告诉它前面怎么做的,只拿结果回原文核 靠价值二
执行型 · 接力 上一段落成文件,下一段只读它 靠价值二,每段只管一件事
练习一请三个写卡的、一个审阅的,两样都摆上了。代价是 token 花得更多,后面算账。
I 价值二 · 专人专项
同一个模型,换一份设定,就是换一个更专的人
在主对话里随手一句
查什么、按什么判、改不改,它自己猜
卡要是就在这个对话里做的,窗口里摆着做卡的全过程。自己写的自己查,查不出来
审阅员 的设定 示意
我的专家 · 审阅员
你是课程复习卡的审阅员。要你审的卡片,你没有参与制作,只看交给你的文件。
逐条拿卡上的说法回 资料/ 里的原文核对,每条只判一种,一致、有问题、资料里没有 ;有问题的写清差在哪。
只读,不许改卡片。 便条里写了谁觉得哪里有问题,不当依据,只认原文。
做完写进审阅意见,只回一句,核了几条、几条有问题。
好处来自设定里写清的做法和标准,加上干净的窗口。这份设定天天要用,能不能固定下来?
I 价值二 · 把设定固定下来
常用的人设,固定成一个专家
专家,就是给 AI 配好的一段人设 写它是谁、怎么做、怎么自检。选了它新建任务,这段人设叠在系统提示词上
现成的,挑一个 左侧栏「专家」里一百多个,下一页就请一个出来问问
自己的,建一个 对话里说帮我创建一个专家 ,建好在「我的专家」里
选谁就是谁 同一个文件夹,今天选审阅员,明天选课程助教
能交给别人 打包成一个文件发给同事,他选了也是这一套
对照 · 页 11 的 AGENTS.md AGENTS.md 是这个文件夹的规矩,垫在你第一句前面;专家的人设叠在系统提示词上,跟着专家走
今天用到 · 练习一 · 搭课程助教 第④步照大纲、网址清单和三张卡,建成你的第一个专家 ,第⑤步选它考三题
本机 WorkBuddy 5.8.3 安装目录的专家版系统提示词模板(workbuddy-expert-prompt.tpl)与自带创建专家技能(expert-manager),2026-10-17 查
I 小练习 · 五分钟
问问专家,你的人设写在哪
选一个专家(比如高级开发工程师),新建任务,依次发这两段
小练习 · 指令卡
你为什么被称为【专家名】?你的人设文件在哪里?具体写了什么?
这份文件和 WorkBuddy 自带的系统提示词是什么关系?换一个专家,哪些会变,哪些不变?
系统提示词 · 内核层 工具调用规则、安全与内容策略、记忆与文件规范 换专家也不变
+ 叠加
专家指令 · senior-developer.md 三阶段工作流、输出风格约束、代码自检清单 只在选了这个专家的任务里加进去,换专家就换掉
↓
这一轮的实际回复 内核规则照旧生效,专家风格在上面起作用
看什么。 人设文件在专家包的 agents 文件夹里,是一份 md,开头 name 和 description 是名片,正文写身份、做法和自检。规矩一条没改,选了专家就把这份人设放进去,换专家只换这一份。 它肯不肯讲、讲到哪一步,都是看点。
本机 WorkBuddy 5.8.3 专家包 senior-developer 的 agents/senior-developer.md 与 .codebuddy-plugin/plugin.json,2026-10-17 查
I 回到第 1 次课 · 提示词工程没白学
六件事,一半写进设定,一半写进便条
六件事 写进审阅员的设定 · 每次都一样 写进便条 · 这一次的
背景 你是课程复习卡的审阅员,卡片是学员复习、赶作业时照着看的 这次复习第 2、3、4 次课 任务 只核对,不写新内容 核这三张复习卡 输入 只认资料里的原文,不凭印象,不联网 卡在 练习1_子代理/,原文在 资料/ 约束 只读不改;谁的看法都不当依据 这次只核三张卡,搭助教不归你 格式 每条判一致、有问题、资料里没有,有问题的写清差在哪 写进 练习1_子代理/审阅意见.md 自检 判有问题之前,回原文再看一遍 做完回一句,核了几条、几条有问题
审阅员今天不建专家,左边一列靠主代理写进便条 。第④步的课程助教,左边那一列就写进它的人设。
I 你已经见过两次
两种价值,第 2、3 次课你都见过
价值一 · 分工并行
第 2 次课 · web-research
先写计划,再分头去查,最后合成报告。每个子课题派一个子代理,最多三个同时查 ,各存一份发现
几个子课题谁也不靠谁,排队就是白等
价值二 · 专人专项
第 3 次课 · Skill Creator 的对照测试
评分员逐条判检查项;盲评员只拿 A、B 两份,不知道哪份带技能;分析员揭开以后讲赢在哪。三个人各有一份设定文件
三个人该看的东西不一样。盲评员看过全过程,就不叫盲评了
两次的骨架一样,先计划,再分头,最后合,中间全靠文件交接 。练习一三次课各读各的,两种价值都拿得到 ,代价是 token 花得更多,账单在后面。
github.com/anthropics/skills,skill-creator 的 agents/grader.md、comparator.md、analyzer.md
I 看一个真实系统 · Anthropic 的 Research
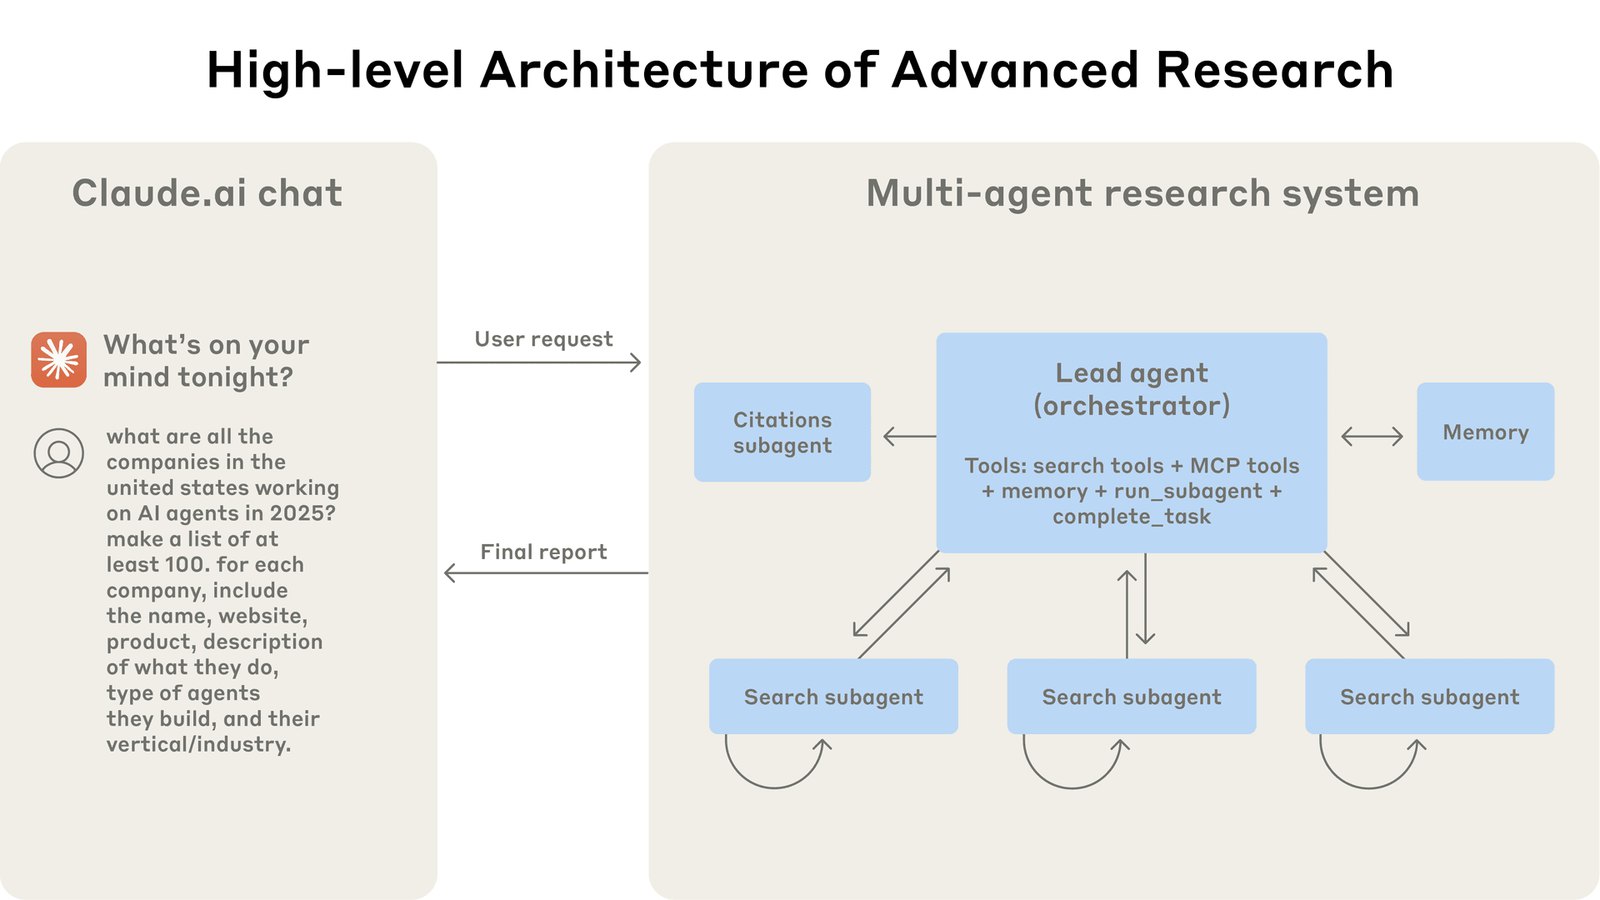
Claude 的深度研究,也是一个主的带几个子的
Lead agent · 主智能体 定策略、拆活派活、最后汇总,就是今天的主代理
Search subagent · 搜索子代理 几个同时开工,各用自己的上下文 查一面,像一次课派一个
Citations subagent · 引用子代理 专门给结论逐条找出处,像今天的审阅子代理
90.2%
内部研究评测上,一主几子比单个强模型高出这么多
80%
搜索评测里的表现差异,token 用量一项就解释了八成
Anthropic Engineering · How we built our multi-agent research system · 2025-06-13
I 他们踩过的坑
派活只说一句,三个子代理撞了车
早期版本 · 主智能体只写了一句
research the semiconductor shortage研究一下半导体短缺
一个子代理去查 2021 年的汽车芯片危机
另外两个都去查 2025 年的供应链 ,干了同一件活
简单问题还派出过 50 个 子代理
后来的做法 · 每张便条写清四样
目标 这一份查什么
交什么 交回来长什么样
用什么 读哪些资料、用什么工具
边界 哪些不归它管
查一个事实 1 个智能体就够
直接比较几样东西 派 2 到 4 个子代理 要拆,三次课各写一张再对照,在这一档
复杂的研究 10 个以上,分工要写清
Anthropic Engineering · How we built our multi-agent research system · 2025-06-13
I 拆之前先问
拆错了,比不拆还慢
情况 为什么别拆
一个问题、一两份文件 派活本身有开销,每多派一个,就多背一摞设定、多读一遍资料 ,账下一页算 要你边看边改方向 子代理看不到你们后来聊的,改了方向它不知道 几段互相要对方的结果 拆开以后各做各的决定,合的时候对不上 拆得太细 三次课每次再按卡上五节各派一个,十五个人交接,汇总要等最慢的那个 几个子代理要彼此对齐 五个两两对齐要十条线,协调成本吃掉分工的好处。要拆就排成星形,子代理只跟主代理交接
能用简单办法办的,别让它自己拿主意 。一个技能能搞定的,别请一队人。
Anthropic Engineering · How we built our multi-agent research system · 2025-06-13;Becker & Murphy, The Division of Labor, Coordination Costs, and Knowledge, QJE 1992
I 派一队人之前 · 算一笔账
一队人干活,账单也按一队人算
当你的 AI token,只剩 3%
拆给子代理,token 一定花得更多 ,换来的是快一点、准一点。
多花在哪。 每个子代理开工先读自己那一摞,约 2.1 万 token ;之后每读一份文件,前面读过的全部再发一遍 。派三个,这两笔就各算三份。
值得拆的只有两种。 一是资料多到一个窗口装着吃力,几份活又各读各的;二是要一个没看过过程的人来审。两样都不是,就让一个智能体做。
Anthropic · How we built our multi-agent research system · 2025-06-13;WorkBuddy 官方文档模型配置页;本机实测 2026-10-16
I 原始资料 · 2025 年 6 月,两篇文章前后脚
隔一天,两家唱反调
2025-06-12 · Cognition · 做编程智能体 Devin 的公司说别造
Don't Build Multi-Agents
Actions carry implicit decisions, and conflicting decisions carry bad results.
每个动作里都藏着决定,决定一打架,结果就坏。
原则二前面的例子:两个子代理分头做 Flappy Bird,彼此看不到对方在做什么,鸟和背景的画风对不上。所以主张一条线做到底
2025-06-13 · Anthropic · 做 Claude 的公司说造
How we built our multi-agent research system
Multi-agent systems work mainly because they help spend enough tokens to solve the problem.
多智能体管用,主要是它把解题要的 token 花够了。
就是前面那套深度研究,token 用量约是聊天的 15 倍。能并排查的活,一队人比一个人强
十个月后,说到一处 2026-04-22 · Cognition
multi-agent systems work best today when writes stay single-threaded and the additional agents contribute intelligence rather than actions.
写的事只留一条线,多出来的智能体出判断,不动手。
Cognition, Don't Build Multi-Agents, 2025-06-12, cognition.com/blog/dont-build-multi-agents;Anthropic, How we built our multi-agent research system, 2025-06-13, www.anthropic.com/engineering/multi-agent-research-system;Cognition, Multi-Agents: What's Actually Working, 2026-04-22, cognition.com/blog/multi-agents-working
第一轮 · 再记一句
可以分头查,只能一个人写
三个子代理各写各的卡可以,助教的人设只由主代理一个人写。
I 业界怎么用一队智能体
拆开的每一段都有产出,拍板的还是人
保险 · 安联澳大利亚 Project Nemo 理赔 七个智能体分管计划、保障核验、天气核验、欺诈筛查、赔款计算、审计汇总等环节,付不付由人工理赔员定 ,处理时间缩短 80%
银行 · 国内 兴业、工行审核 兴业用规则引擎加审核智能体,报道称 52 个子智能体上线后与人工复核一致率 99.96% ;工行合规审查意见采纳率 98.6%
政务 · 深圳福田 70 名 AI 数智员工 按岗位分工上岗。公文格式修正准确率超 95%、审核时间缩短 90%;民生诉求分拨准确率从 70% 升到 95%
微软 2025 年工作趋势报告说,每个员工都要像智能体驱动的初创公司 CEO 那样思考 。这就是第 1 次课的 AI CEO。
Allianz 新闻 2025-11-03;21 世纪经济报道《银行 AI 账本》2026-09-12;深圳市政府网 2025-02-18;Microsoft Work Trend Index 2025-04-23。链接见《参考与延伸阅读》
I 派之前想清楚
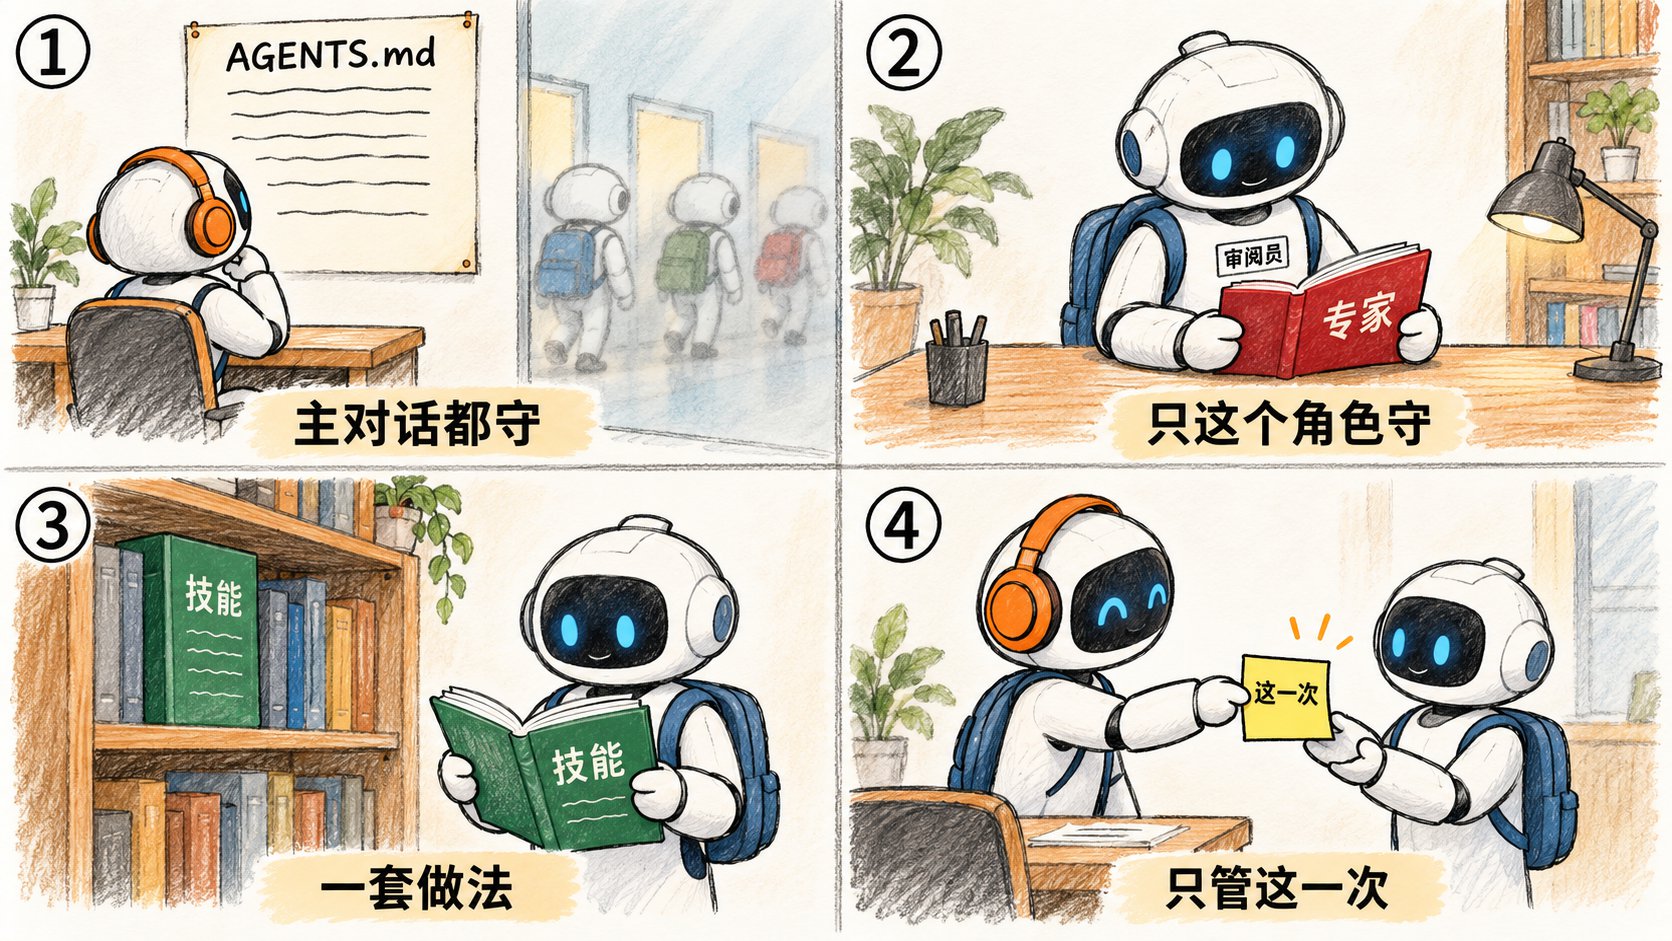
一条规矩,先想清楚谁要守
① 主对话都守→ AGENTS.md 资料里没有的不许编,每条写出处。新任务开头读,子代理开工时不读
② 只这个角色守→ 做成一个专家 审阅员只核不改。反复要用的角色建成专家,练习一的课程助教就是
③ 一套做法→ 技能 复习卡怎么写、每节写什么、出处怎么标
④ 只管这一次→ 便条 这次管哪次课、只读哪几份资料、写到哪个文件。AGENTS.md 里要子代理守的,也抄进来
你在对话里临时补一句规矩,子代理听不到;AGENTS.md,它也不读 。要它守的,让主代理写进便条 。
WorkBuddy 5.8.3 本机拼装代码,2026-10-17 查;Claude Code 官方文档 · Subagents:规则一定要传到子代理的,在派活说明里再说一遍
I 落到 WorkBuddy 上
在 WorkBuddy 里,派一队人有三种办法
办法 怎么用 适合
一句话让它派 指令里写明派几个子代理、一个管哪一份、结果各写一个文件。界面上会显示「正在执行子任务」 今天练习用这个 智能体团队 设置 → 智能体 → 智能体团队管理 打开后,复杂任务它自己组队;会话里能看到团队卡片和每个成员的状态 拆不拆交给它判断 专家与专家团 「专家 · 技能 · 连接器」里挑现成的专家团;或者在对话里让它创建一个专家 ,把审阅员做成一个固定角色 反复要用、口径要稳的角色
派不派、派几个,最后是模型定的,同一句话在两台电脑上可能不一样 。专家团的积分通常是单个专家的 3 到 5 倍,体验版每月 500 积分,别拿它练手 。
WorkBuddy 官方文档「专家中心」「积分」;本机 WorkBuddy 5.7.6 客户端设置页,2026-10-08 查
小实验 三分钟 · 工作空间 练习1_子代理/ · 不给提示词,用你自己的话问
问一句暗号,看谁答得上来
一 主对话问 新建任务 ,在主对话里问它暗号是什么。看它答不答得上来
二 派一个去问 让它派一个子代理去问暗号。子代理答得上来吗
三 让它自己读 子代理答不上来,就让它自己去读 AGENTS.md ,再问一次
练习1_子代理/ 根下那份 AGENTS.md 是老师写的,里面藏着一个暗号。答上来没有,它从哪知道的 。子代理开工时读不读 AGENTS.md,自己验一遍。
I 派之前
先让它出一张分工表,你改完再派
练习页指令卡 1-1 节选
我要复习第 2、3、4 次课,复习完要用这几张卡搭一个课程助教,那一步后面再说。资料在 资料/ 里,每次课两份:第N次课_课件.md 和 第N次课_实操页.md。第 4 次课另有一份课堂录屏的逐字稿 资料/第4次课_录屏逐字稿.md,写第 4 次课那张卡也要读。卡片照 复习卡_模板.md 写。
请派三个子代理同时干,一次课一个 ,各写一张复习卡,存成 第N次课_复习卡.md。
先别派。 先给我一张分工表:每个子代理管哪次课、只许读哪几份文件 、交回什么、写到哪个文件、不许做什么。我看过再说派。
分工表就是便条的底稿。前面那四样,目标、交什么、用什么、边界,在分工表里一眼就能查 。最常漏的是没写的就写没写、不许改资料,它问你的时候在回话里补上 。
I 演示
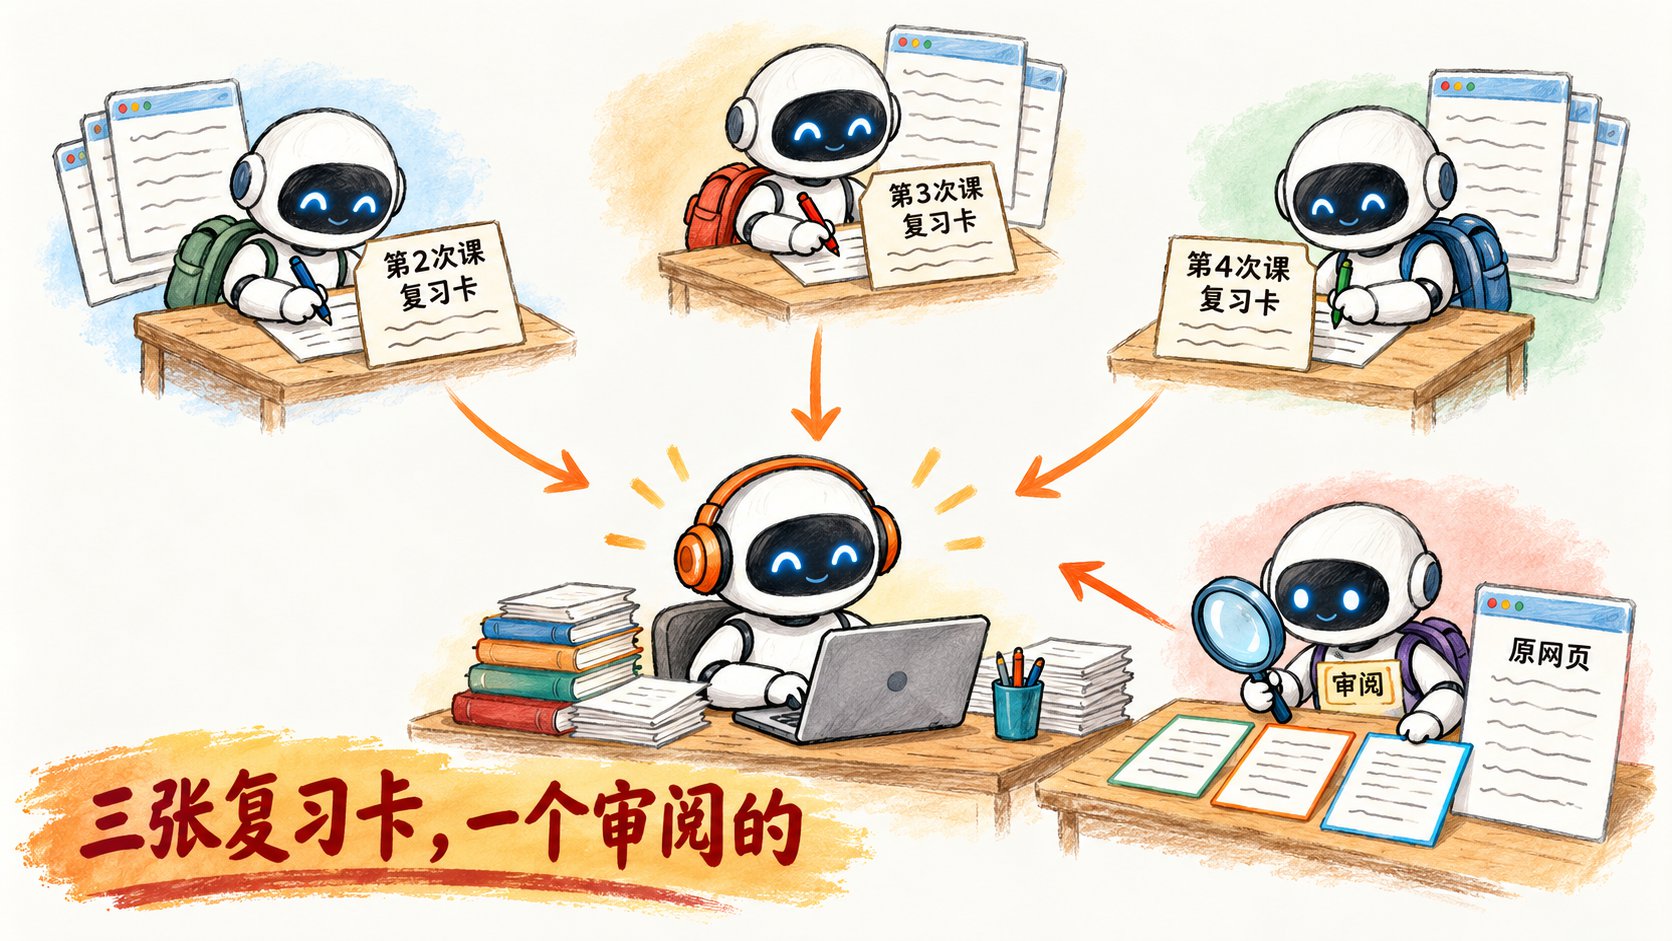
三张复习卡,一个审阅的
盯一 · 同时跑 界面上三个子任务是不是同时在跑 ,主代理自己有没有去读资料
盯二 · 审阅挑出了什么 它不知道卡是怎么写出来的,只拿卡片回原文核
盯三 · 考助教 问作业一哪天截止,答 10 月 11 日 13:30,后面写着出处
练习 一 每人一份 · 工作空间 练习1_子代理/ · 只用本地文件,不联网 · 材料包 MDE-05
一队子代理,搭一个课程助教
一 先出分工表 新建任务 发 1-1。看每个子代理只许读哪几份 、交到哪个文件,不对的改了再派
二 三个同时派 照它的回复回答,漏的在回话里补 ,再让它三个同时派
三 换一双眼睛 接着发 1-3。审阅的拿三张卡回原文核,写 审阅意见.md。已经审过就跳过
四 搭课程助教 接着发 1-4,照大纲和网址清单直接建课程助教专家
五 考考它 新建任务选课程助教 ,发 1-5 考三题,看答案有没有出处
派出去以后看界面上的子任务,三个是不是同时在跑 。
I 怎么算做完
验收五条,每条回原文核
# 检查项 过的标准
1 三张卡,三个文件 每条有出处,写到第几页或哪一节,逐字稿写到时间点 2 同时派,一次课一个 三个子代理是同时派出去的,一次课一个,没改资料 3 审阅挑出的,你判过 审阅说有问题的那几条,你回原文判过对错 4 课程助教专家建好了 在「我的专家」里能找到;人设开头有 name 和 description,正文四节都有 5 考它三题,答案有出处 新任务里选课程助教考它三题,答案都有出处 :第 6 次课企业分享,作业一 10 月 11 日 13:30,作业二 3 人
I 休息
中场休息
练习一没做完的,休息时做完
休息时先把工作空间换成 练习2_知识库/
II 回头看练习一
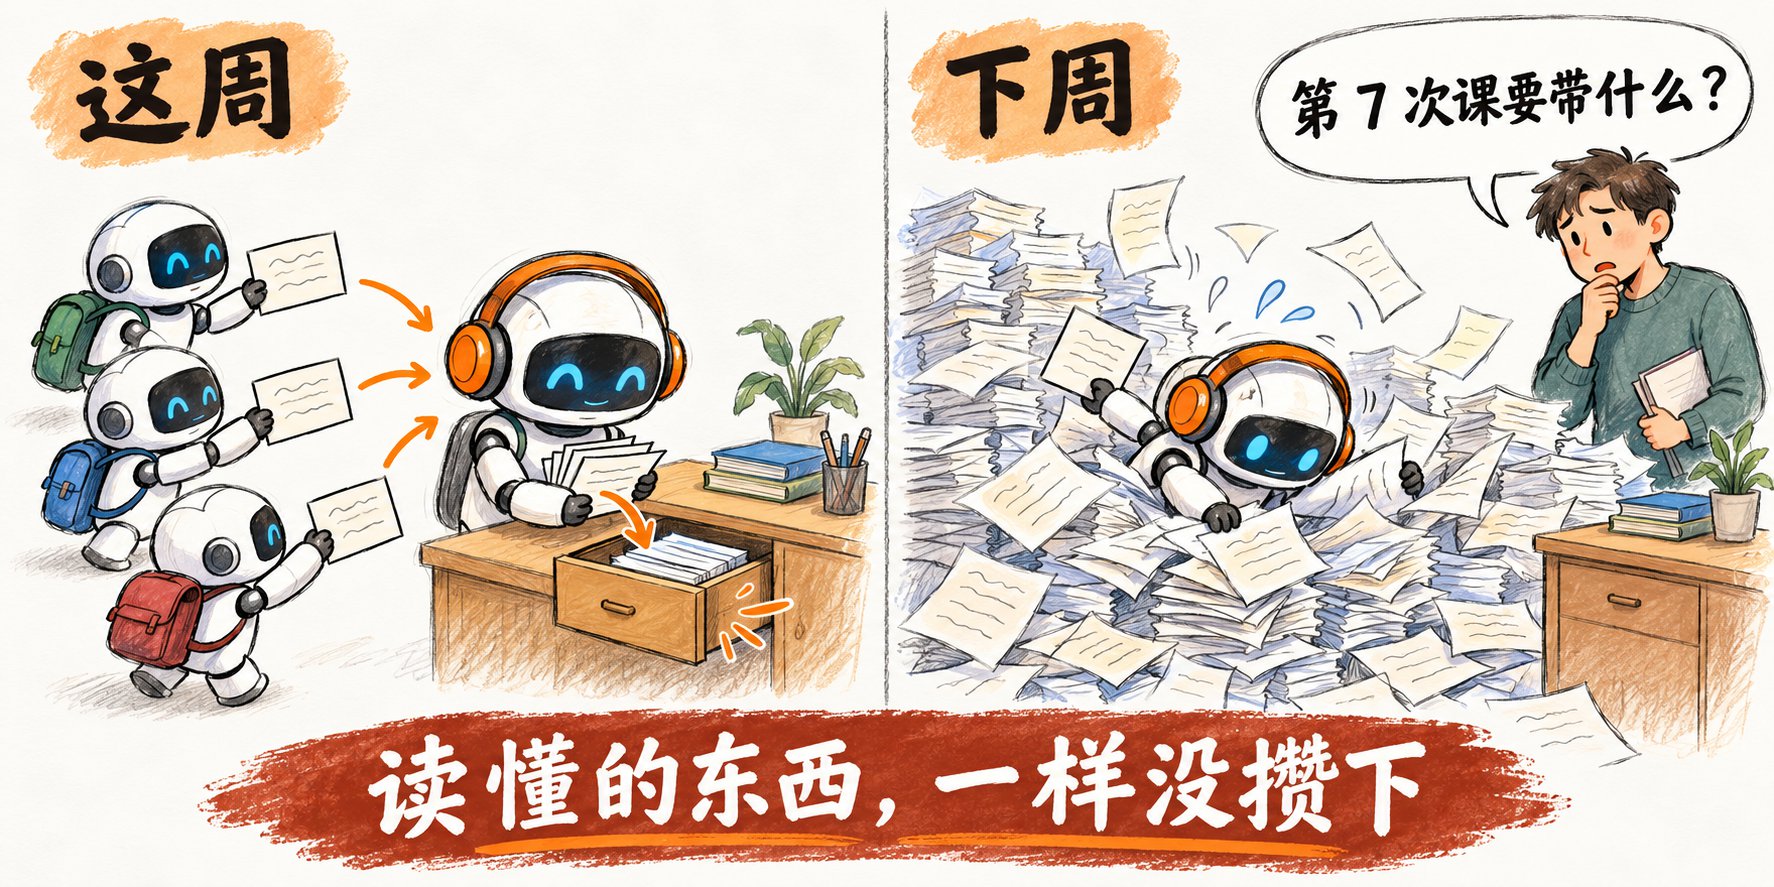
助教搭好了,今天的安排它不知道
只认 资料/ 里的东西 它读的是第 1 到 4 次课的网页和大纲。今天课堂安排里的新消息,它不知道
复习卡不会自己补 三张卡写到第 4 次课。今天新说的课间问卷、小组知识库,没人替你补进卡里
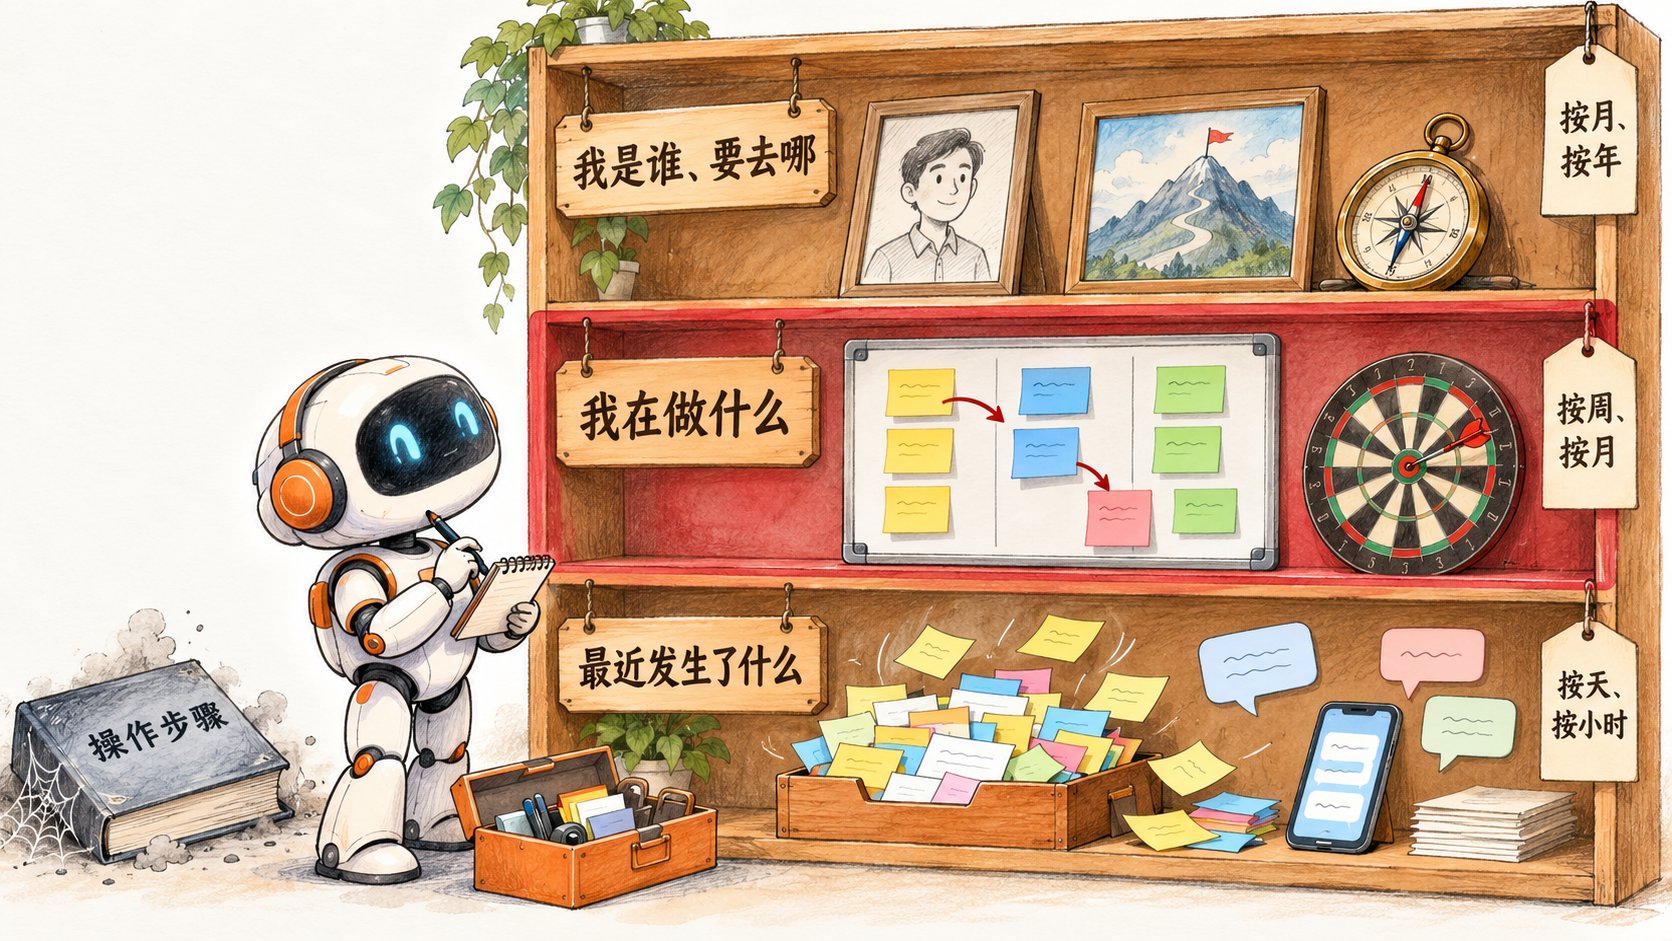
第二轮要的 读懂的东西要攒下来,新来的要补进去 。这就是第二轮
II 为什么要攒
步骤它都会,但不知道最新的工作进展
在你的知识库里
条目 · 课程安排、作业与考核 项目进展、卡点、下一步
最容易缺,今天的靶心
II 读懂的东西怎么攒下来
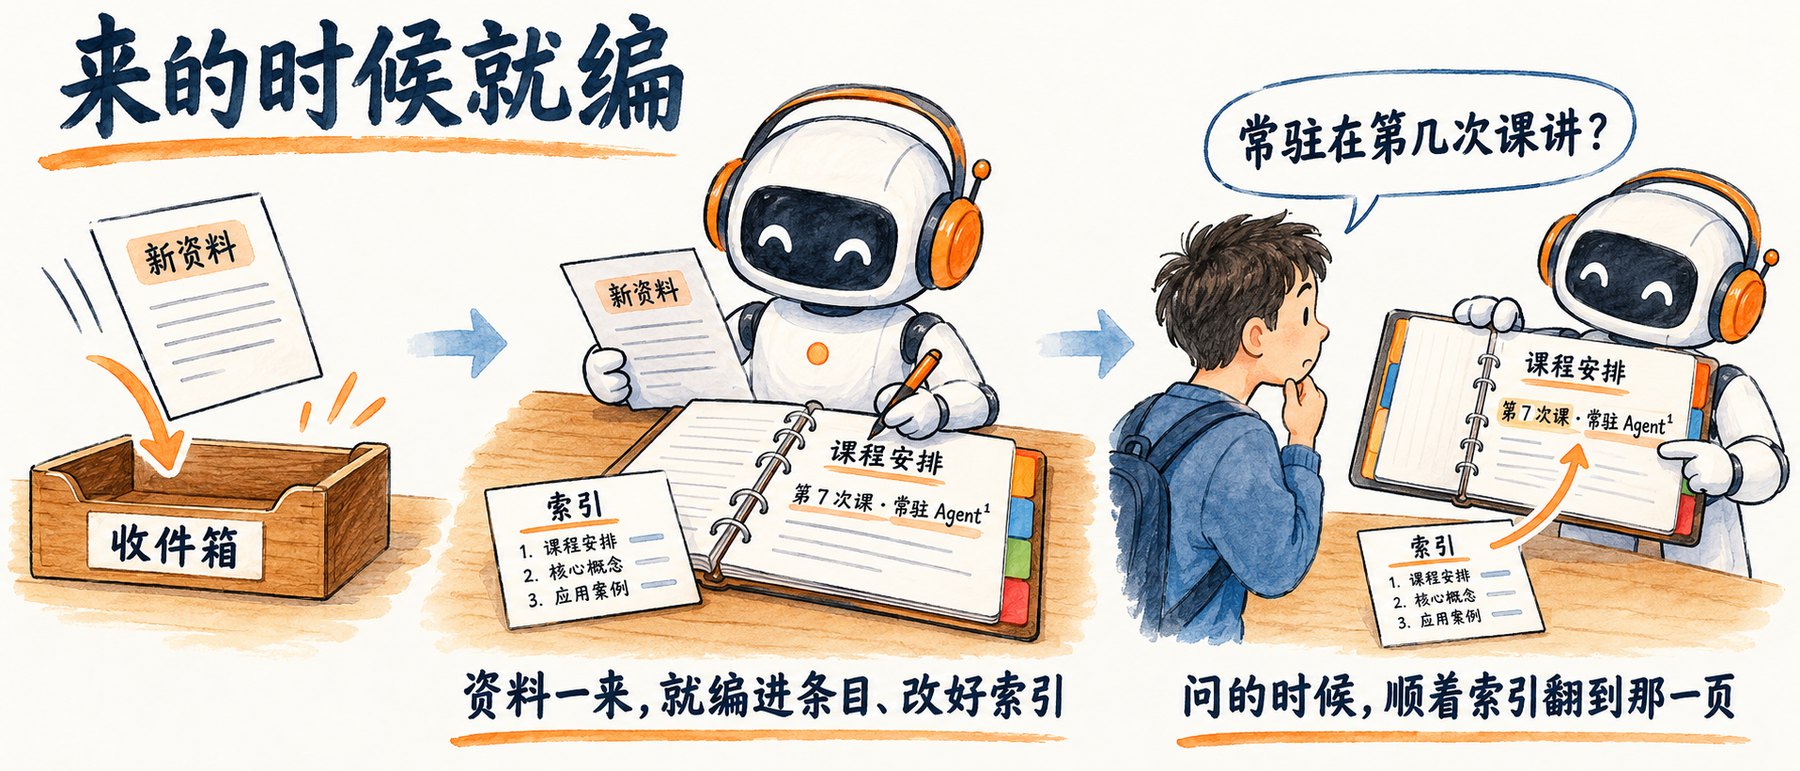
两条主流的路,问的时候去找,来的时候就编
两条路最后都是把知识库里的一些内容,放进它这一次的上下文 。差在三处,拿同一个问题来看。
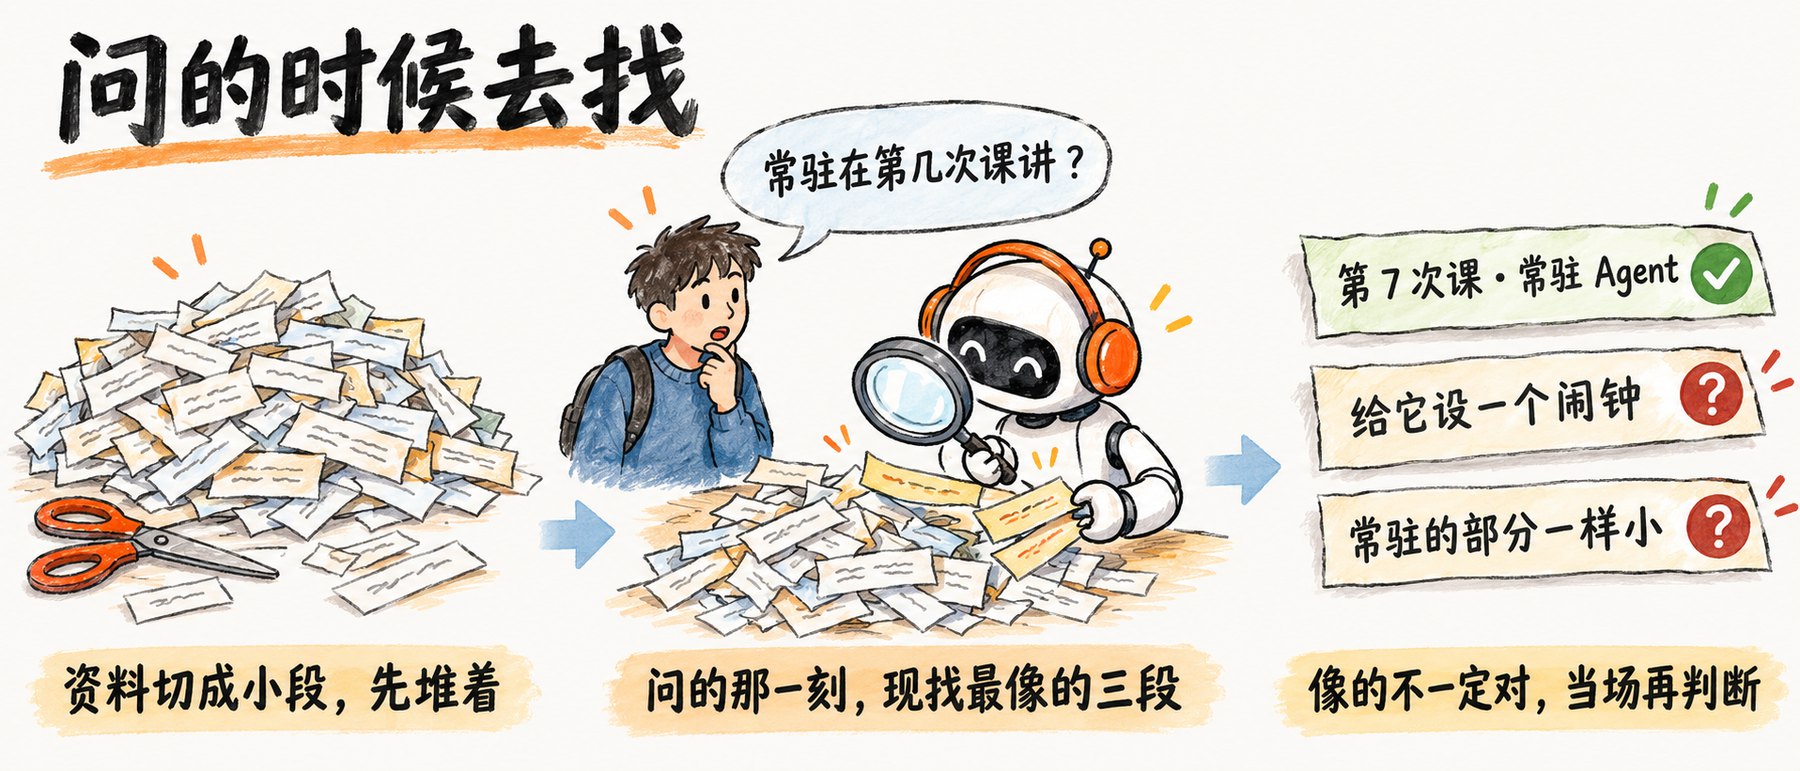
RAG · 问的时候去找检索增强生成
LLM Wiki · 来的时候就编像百科那样一页一页、互相链接 · 练习二走这条
什么时候干活
你问的那一刻,现去捞
资料进来的时候,就整理好
怎么找到
比像不像,挑出和问题最像的几段
先读索引,顺着目录翻到那一页
放进来的是什么问让智能体常驻,在第几次课讲?
第 3 次课课件 · 第 2 页 ……常驻 Agent 在第四周第 7 次课……
第 4 次课课件 · 第 12 页 ……给它设一个闹钟……你不在,它照跑……
原文里切下来、和问题最像的几段碎片。前后文可能缺,答案和只是意思挨着的一起进来 ,哪段才答了问题,它当场判断
条目 · 课程安排 · 整页 第 4 次课 · 给它设一个闹钟[第 4 次课课件第 12 页]
第 7 次课 · 常驻 Agent[第 3 次课课件第 2 页]
它事先编好的整页条目,一页讲一件事,每句带出处。闹钟在第 4 次课,常驻在第 7 次课,整页读下来分得清
II 两条路 · 先看 RAG
RAG,问的时候去找
II 先看 RAG · 机器怎么判断像不像
每个词,是意思地图上的一个点
0 1 2 3 4 5 6 7 8 9 1 2 3 4 5
维度 1 维度 2
法国 巴黎 中国 北京 日本 东京 苹果 香蕉 葡萄 北京 (4,3) − 中国 (1,2) = (3,1)
日本 (2,4) + (3,1) = (5,5)
离 (5,5) 最近的词,东京
示意,真实的有上千维
点一个词,看离它最近的三个
一段话、一个问题,也都能换成一个点。RAG 就是找离问题最近的那几段 。
一个词,换成一串数字 这串数字就是它在意思地图上的坐标,叫向量 。把词换成向量的程序,叫嵌入模型
北京 → [0.12, −0.48, 0.33, …],共 1024 个数
坐标从哪来 模型读了海量文字,前后常跟着同样词的两个词,就放得近 。北京 、东京前后都常跟着首都、飞往,所以挨着
方向也有意思 北京 − 中国 + 日本 ≈ 东京
每个国家到它首都,方向和远近都差不多
Mikolov, Sutskever, Chen, Corrado & Dean, Distributed Representations of Words and Phrases and their Compositionality, NIPS 2013, 图 2;
II 先猜再看
有人问知识库
让智能体常驻,在第几次课讲?
揭晓 · 第 3 次课课件 第四周
II 先看 RAG · 判断标准
比两支箭头的夹角,夹角越小越像
问:让智能体常驻,在第几次课讲?
第 3 次课第 2 页 · 答案在这 第 7 次课 常驻 Agent
第 4 次课第 12 页 · 闹钟 你不在,它照跑
第 2 次课第 23 页 · 常驻的部分一样小 夹角大,不像
闹钟那段也挨得近,可能被捞进来
从原点向每个点画一支箭头 问题一支,每段话一支。夹角越小越像 ,这个分数叫余弦相似度,最像是 1。箭头一样长时,离得近和夹角小是一回事
比按字找强在哪 按字找常驻,会捞回第 2 次课第 23 页「三个技能,常驻的部分一样小」,那页讲的是技能;向量知道这个常驻意思不一样,放得远
取最像的几段 一般取前 3 到 5 段,叫 Top-K ,拼进提示词交给模型
像,不等于对 闹钟那段写着「你不在,它照跑」,和常驻意思挨着,可能被捞进前几段 ,答成第 4 次课。向量只管像不像,不管对不对
OpenAI 文档 · Embeddings(We recommend cosine similarity),2026-10-15 查;图是示意
II 先看 RAG · 怎么搭起来
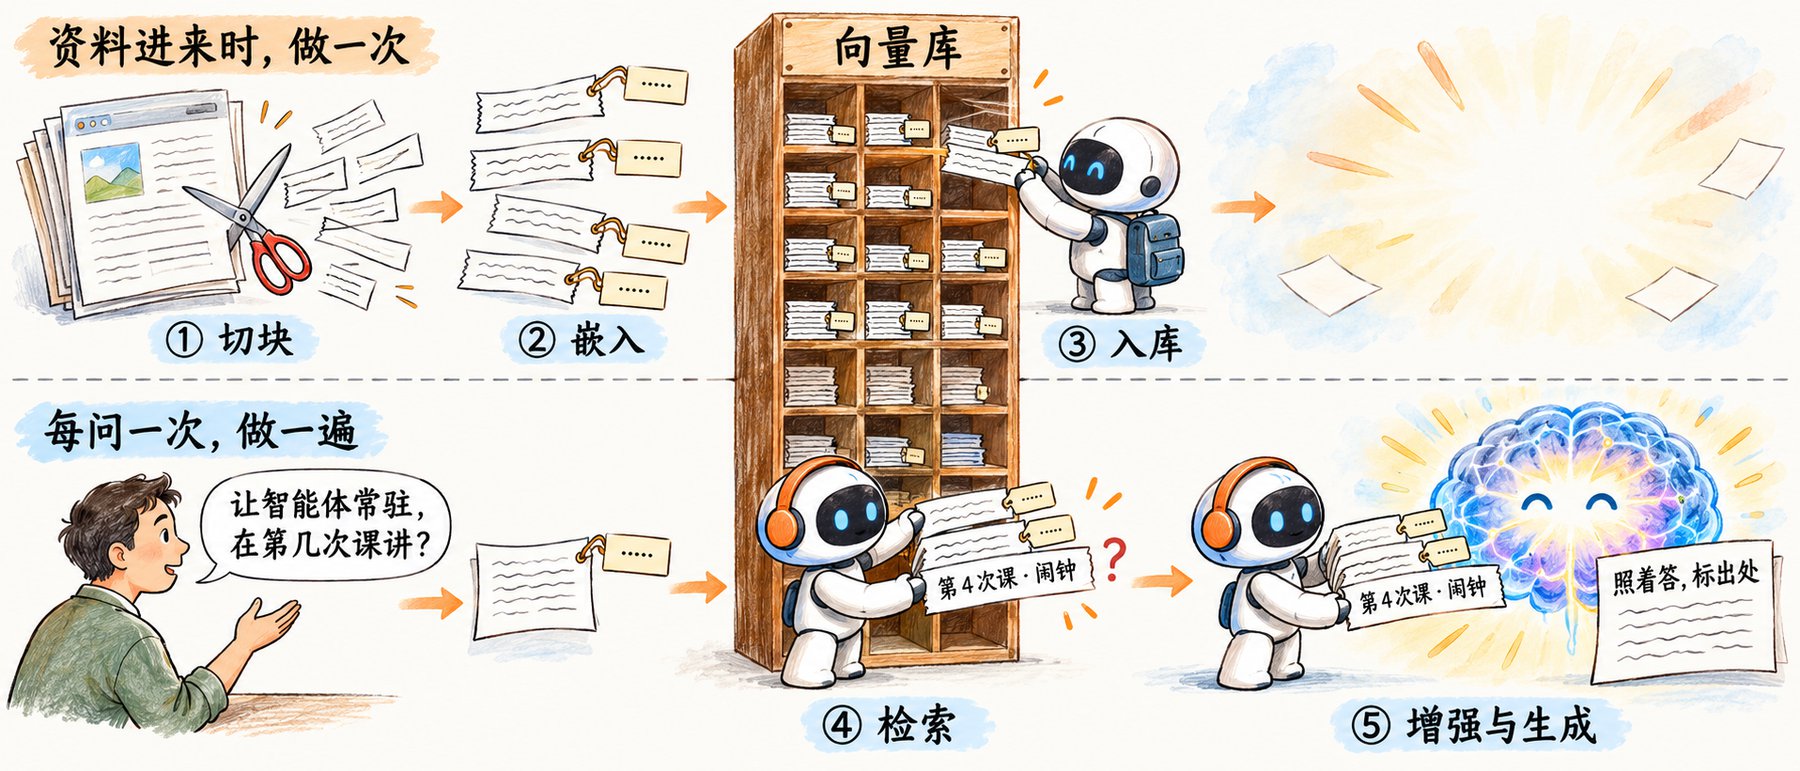
搭一个 RAG,五步
资料进来时,做一次
01 切块 一段几百字,九份网页切成上百段
02 嵌入 每段换成一串 1024 个数
03 入库 存进向量库。资料库背后就是这三步
每问一次,做一遍 · RAG 的名字取自这两步
04 检索 取最像的几段,像而不对的也可能捞回来
05 增强与生成 补进问题,照着答、标出处
九份网页约 5.7 万字,整摞放进窗口也放得下,这里拿它看清每一步 ;到了几千份,才非 RAG 不可。
Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, NeurIPS 2020;切块默认值见 OpenAI file search 与 LlamaIndex 文档;Anthropic · Introducing Contextual Retrieval,2024-09-19(二十万 token 以内可直接全放进提示词)
II 你手边的 RAG
WorkBuddy 资料库那一栏,走的都是 RAG
入口 是什么、怎么接 它怎么找 适合放
资料库 WorkBuddy 自己的云端空间,个人加团队,体验版 5 GB。选中文档点「添加到任务」 切成小段,按意思找最像的几段 团队共用的原件、任务产物 ima 知识库 资料库 → ima 知识库 → 立即前往授权,个人微信扫码 调 ima 自己的检索。ima 团队说它的知识库就源自 RAG 自己收的文章、研报 乐享知识库 资料库 → 乐享知识库 → 授权。单位团队库为主,也有个人库 调乐享自己的检索,按意思和按字一起找 单位已在用乐享的
ima 知识库面向个人 ,主打私有知识沉淀与个人创作;乐享知识库面向企业团队 ,主打协作、统一管理和知识资产共享。
腾讯文档也在这一栏,第 3 次课接过。存储和检索不扣积分,让 AI 加工、总结才扣 。连上以后拿的是登录人的权限 ,人看不到的内容它也读不到。
WorkBuddy 官方文档「资料库」「ima 知识库」「乐享知识库」;本机 WorkBuddy 5.7.7 内置资料库技能与连接器说明;腾讯新闻 ima 专访 2025-05-22;腾讯云文档 · 乐享 RAG 应用实践。2026-10-15 查
II 毛病出在结构上,调参数调不掉
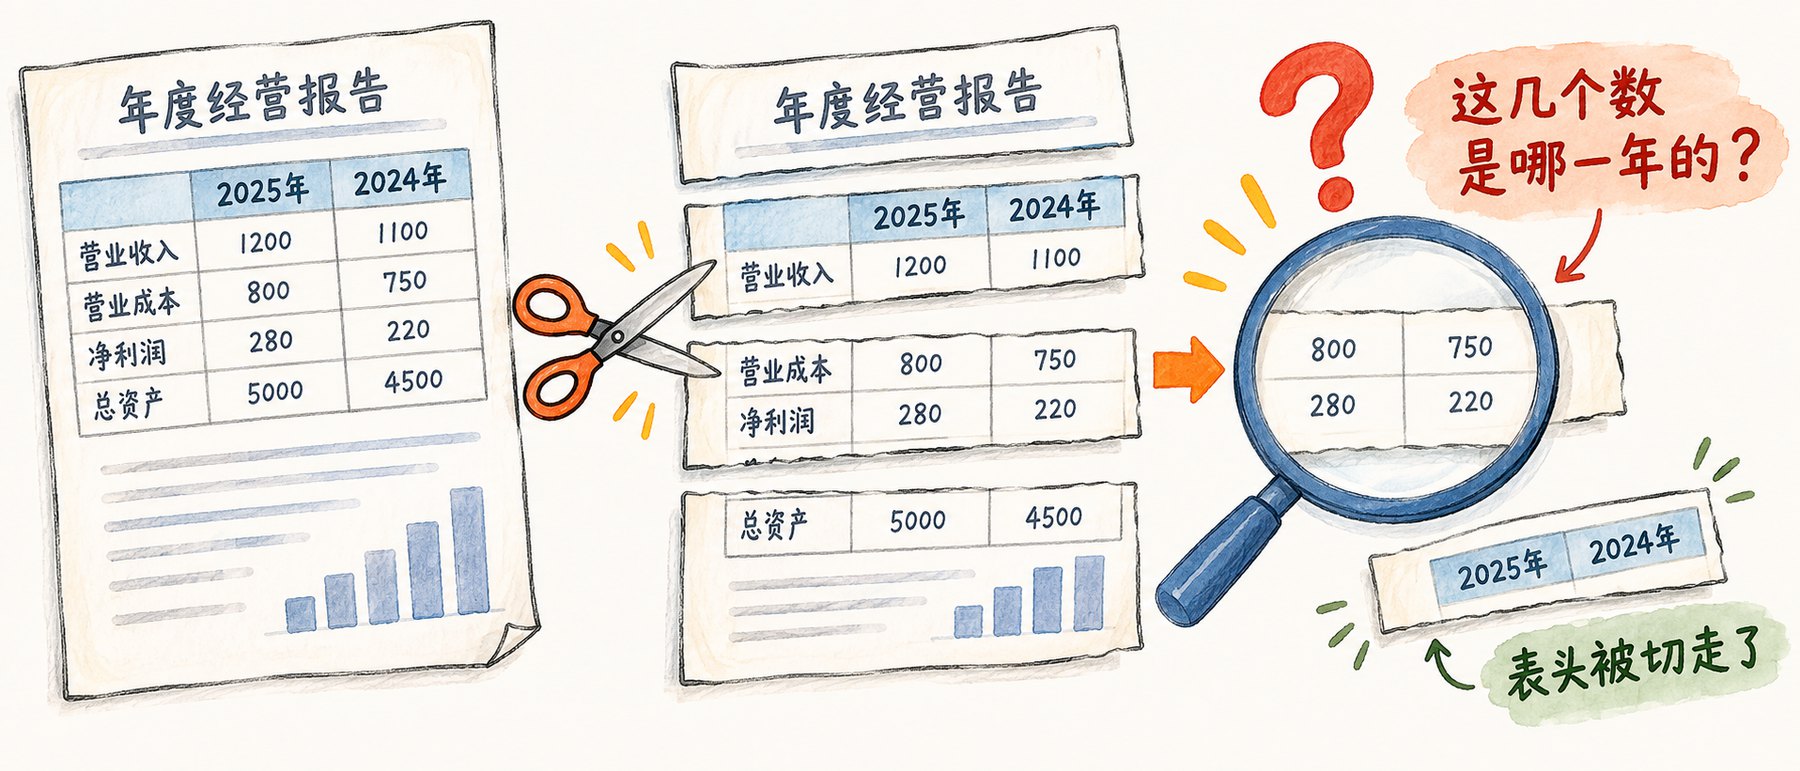
找片段这件事,有三个天生的毛病
切块断裂 第 3 次课第 2 页排期表的「第四周」和下面「第 7 次课 常驻 Agent」切进两段,只捞回后一段,说不清是哪一周
像不等于对 问常驻在第几次课讲,可能捞回第 4 次课讲闹钟那段,意思挨着,课次不对
不攒东西 每次从零找,查完就丢。连着三天问作业二,它每天重新找一遍
“The company's revenue grew by 3% over the previous quarter.” However, this chunk on its own doesn't specify which company it's referring to or the relevant time period.
Anthropic 举的例子:切出来的一段写着公司营收比上季度增长 3%,单看这一段,说不清是哪家公司,也说不清是哪个时间段。
Anthropic · Introducing Contextual Retrieval,2024-09-19,https://www.anthropic.com/engineering/contextual-retrieval
II 第二条路 · LLM Wiki
LLM Wiki,来的时候就编
II 第二条路 · 原始资料 · Andrej Karpathy
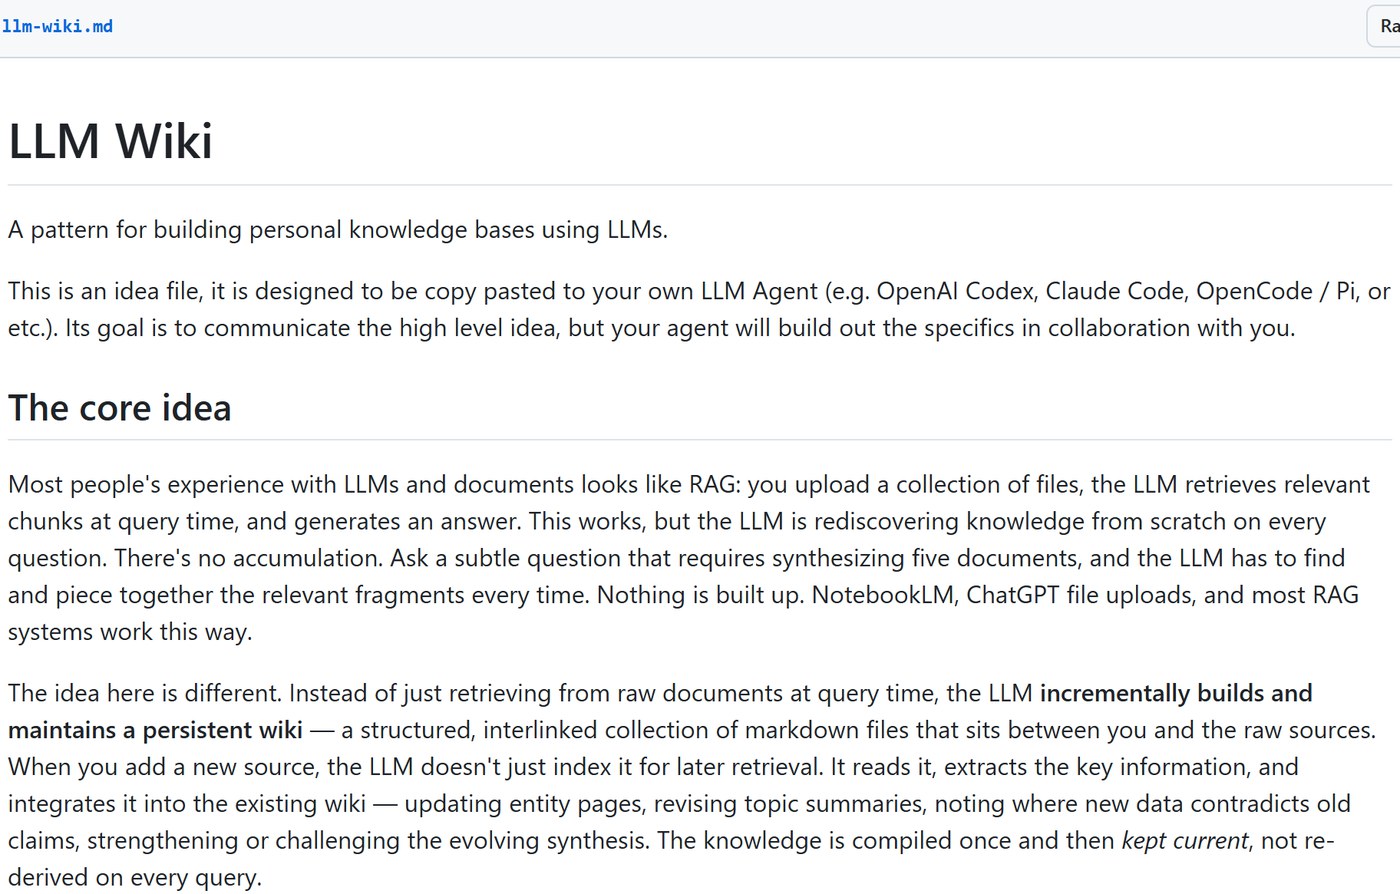
别每次现找,让它把资料编成一本 wiki
AK
Andrej Karpathy @karpathy · X · 2026-04-02
LLM Knowledge Bases
a large fraction of my recent token throughput is going less into manipulating code, and more into manipulating knowledge
我最近的 token,越来越少花在写代码上,越来越多花在整理知识上
~100 articles and ~400K words … I thought I had to reach for fancy RAG
一百来篇、四十万词,原以为得上一套正经的 RAG,结果没用上
约 2200 万次浏览,截至 2026-10-16
gist.github.com/karpathy ·llm-wiki · 2026-04-04
两天后,他把思路写成一份文件
The LLM is rediscovering knowledge from scratch on every question. There's no accumulation.
每问一次,模型都从头重新找一遍知识,什么也没攒下
This is an idea file, it is designed to be copy pasted to your own LLM Agent.
这是一份思路文件,直接贴给你自己的智能体用
后面三页的三层、三个动作,都出自这份文件
Karpathy 是 OpenAI 创始成员、前特斯拉 AI 负责人,LLM Wiki 这个叫法就从这里来。他只发思路,代码让各人的智能体去写。今天的 personal-wiki 技能,就是照这个思路写的 。
Karpathy, LLM Knowledge Bases, X, 2026-04-02, https://x.com/karpathy/status/2039805659525644595(浏览数截至 2026-10-16);Karpathy, llm-wiki, GitHub Gist, 2026-04-04, https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f
II 第二条路 · 原文 · llm-wiki.md
原文八节,前四节就是今天的练习二
The core idea 别每次从头找,让模型一直维护一本 wiki 今天的出发点
Architecture 三层:原件只读,wiki 归模型写,schema 定规矩 练习二的三层
Operations 三个动作:入库、查询、体检 personal-wiki
Indexing and logging index 按内容编目,log 按时间往后记 索引.md、日志.md
Optional: CLI tools 库大了再加一个搜索工具 今天不用
Tips and tricks Obsidian 剪藏、图谱视图、Marp、git 今天不用
Why this works 最累的是记账,人会放弃,模型不嫌烦 后面记台账那页
Note 刻意写抽象,目录、格式、工具按你的领域定 目录照这句定
原文是思路文件,贴给智能体就能一起搭。personal-wiki 是照它改写的中文版 。
Karpathy, llm-wiki, GitHub Gist, 2026-04-04, https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f;截图 2026-10-17
II 延伸阅读 · 三篇公众号
同一个思路,三种落地
Karpathy 的思路发出来以后,中文圈很快有人照着搭。三篇都能在微信里直接打开
一个讲思路,一个教入门,一个跑了 430 多篇公众号,最后都落到一个文件夹,加一个能读写文件的 AI 。
AI寒武纪 2026-04-05;AI and Economics 2026-03-24;AI编程实验室 2026-04-07。均为微信公众号文章,2026-10-17 查
II 为什么以前做不成
难的不在读和想,在记台账
The tedious part of maintaining a knowledge base is not the reading or the thinking — it's the bookkeeping.
维护知识库最烦人的,不在读,也不在想,在记账这类杂活。
以前 · 人来维护 上完一次课,得改好几处 第 4 次课讲完,课程安排那页添上闹钟,工具与操作那页添上定时任务怎么设,作业与考核添上作业二,索引跟着改,日志记一笔。维护的活比好处涨得快,人坚持不下去
现在 · AI 来维护 一份资料进来,改十几页也不烦 原文说一份资料可能牵动十到十五页,AI 来做,维护成本几乎是零。人挑资料、提问题、想清楚这些说明了什么,其余交给它
Karpathy, llm-wiki, GitHub Gist, 2026-04-04(Humans abandon wikis because the maintenance burden grows faster than the value;A single source might touch 10-15 wiki pages)
II LLM Wiki 长什么样
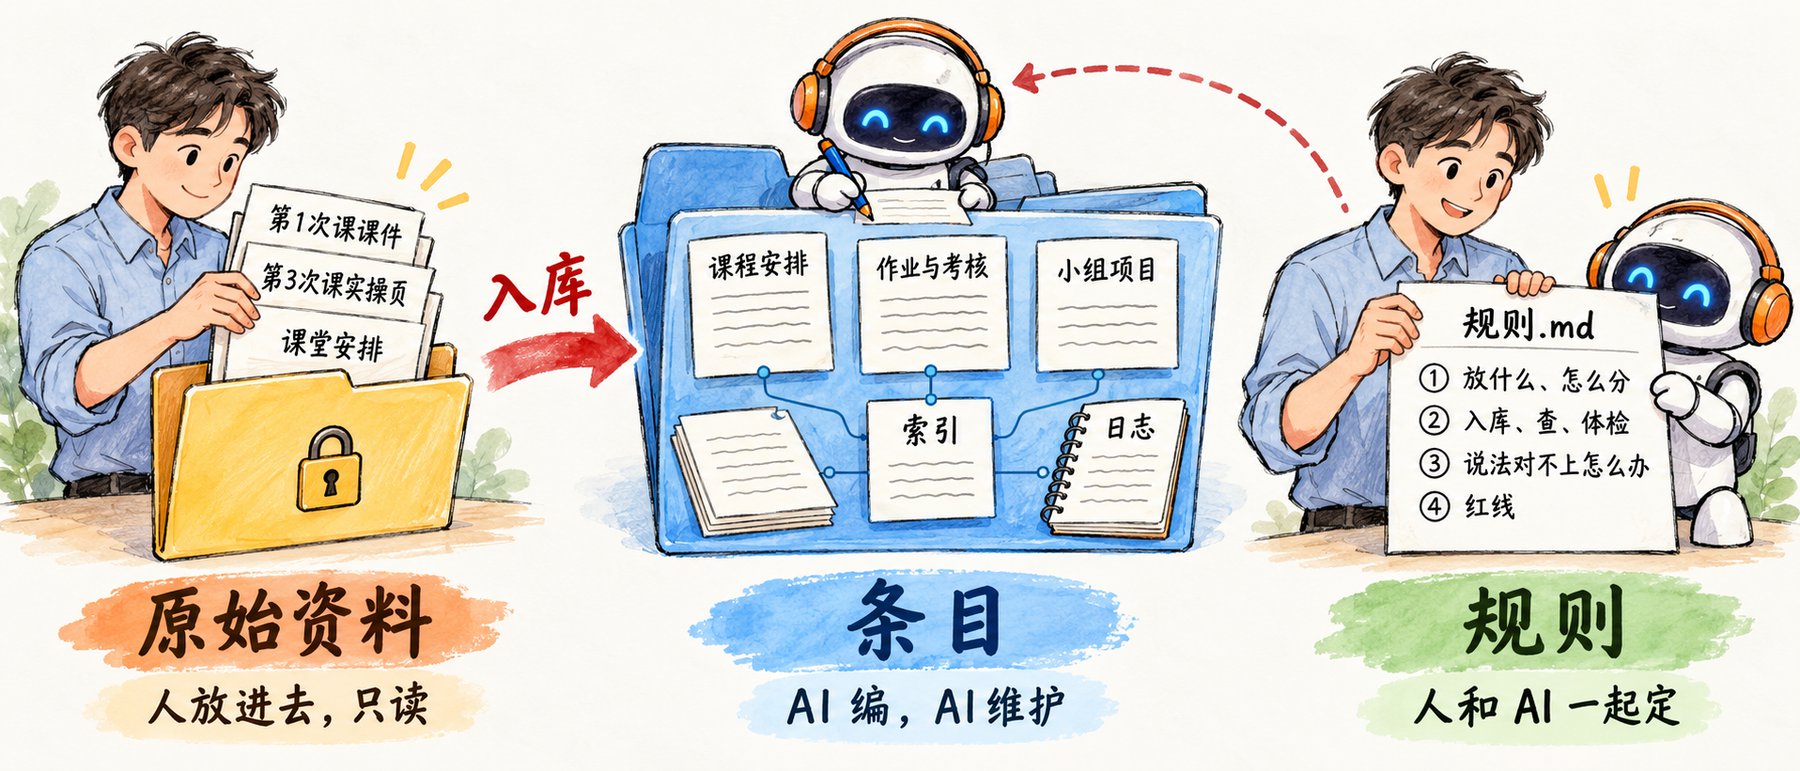
资料人放,页面它编,规矩一起定
原始资料 · 只读 人放进去,AI 只读不改。今天是大纲、九份快照、录屏逐字稿。怀疑哪句,回这里核
条目 · AI 编、AI 维护 Karpathy 叫它 wiki。按事一页一页写,比如课程安排、作业与考核,每句标出处。外加索引 每页一行,日志 按时间记每次改了什么
规则 · 一起定 一份说明文件,管条目怎么分、每次怎么处理。Karpathy 说,有了这份文件,AI 才像个守规矩的档案员,不再随口闲聊
Karpathy, llm-wiki, GitHub Gist, 2026-04-04(Raw sources / The wiki / The schema;index.md、log.md)
II 日常就三个动作
入库、查询、体检
入库 · Ingest
来了一份新资料 读完,更新它牵动的每一页 ,和旧说法对不上的标出来,更新索引,在日志里记一笔
查询 · Query
有人来问 先读索引,找到相关页面再答,标出处。答得好的,存回 wiki 里
体检 · Lint
隔一阵扫一遍 找页面之间的矛盾、被新资料推翻的旧说法、没人引用的孤页 、提到了却没建页的
大家最容易漏掉中间那个动作。好的问答本身就是 wiki 的新内容 ,你问出来的一个对比、一个结论,不该消失在聊天记录里。
Karpathy, llm-wiki, GitHub Gist, 2026-04-04(good answers can be filed back into the wiki as new pages)
II 真在用的
两个跑起来的知识库,都是一个文件夹
一个跑了两年的个人笔记库
目录、规则文件、索引,加三个技能
2682 篇笔记,会议 203 篇
105 份索引,每个目录一份
13 条定时任务
每小时导会议转写,每天出日报,每周出周报,每周自己体检一次 。它靠的是每次都找得到,不靠记得
我的《高级计量经济学》课程 wiki
我把 Karpathy 的原文交给 AI,让它自己搭
18 份课件 PDF,一次入库
43 页:讲次 17、概念 15、方法 11
1 份规则,照 Karpathy 的写
目录和规则我都没手写。体检时它指出两页写的同一个门槛数字不一样 ,一个是经验值,一个是查表值。它没替我判,只提醒我去核
工具不同,骨架一样。原件只读,条目让 AI 写,规矩写进一份文件 。今天练习二就是这个骨架的缩小版。
II 放在一起比
RAG 和 LLM Wiki,差在什么时候干活
比什么 RAG · 问的时候去找 LLM Wiki · 来的时候就编
活干在哪头 每问一次,现找一次 每来一份资料,编一次 怎么找到 比夹角,问的是哪段文字和这句话最像 ,捞回几段 先读索引,问的是按东西的摆法,答案应该在哪一页 。问常驻在第几次课讲,就在索引里找到课程安排那一行,整页读 对不上怎么办 两段都捞回来,靠模型当场判断 入库时就标出来,写进变更记录或待核 会错在哪 捞错了段,照着错的答 编错一句,以后一直错 。微软研究院 2026 年让前沿模型连着多轮改文档,结束时平均改坏约四分之一的内容适合多大 几千到几百万份,问法五花八门 约一百份资料、几百页。再大,Karpathy 自己也说要加检索
两条路可以叠着用,常被问的核心资料编进知识库,量大、偶尔才查的放进 WorkBuddy 资料库。不管哪条,原件都要留着、都要能核 。
Karpathy, llm-wiki, GitHub Gist, 2026-04-04;Laban, Schnabel & Neville, LLMs Corrupt Your Documents When You Delegate, arXiv 2604.15597, 2026-04-17
第二轮 · 记住一句
RAG 每次现找,Wiki 平时就记好
资料常被问、要长期跟的,编成页面才划算;查一次就扔的,问的时候捞回几段就够了。
II 落到我们自己身上
我们的个人知识库,就是 LLM Wiki 的落地版
干什么 Karpathy 原文 有人做成三个技能的笔记库 今天 · 技能 personal-wiki
立规矩 schema,一份 AGENTS.md 一类的说明文件 AGENTS.md:这个库干什么、收到东西按什么顺序处理 AGENTS.md 讲目录,规矩写在规则.md 先看哪 index.md,每页一行摘要 每个目录一份 _index.md 索引.md,一个条目一行 进料 ingest,一份资料牵动十几页 takenote:一句「记一下」,按规则归档、连上旧笔记、更新索引 入库 ,存原件、改条目、记日志问完存回去 query,好答案存进 wiki research-save:主动去查,查到的存回库里 查完问你要不要补进条目 定期维护 lint,找矛盾、孤页、过时说法 update-vault:维护索引、补断链 体检,只列不改
我们把它做成了技能 personal-wiki ,今天的四页条目管的是三层里中间那层,我在做什么。模型谁都能买,你那摊事的来龙去脉只有你有 ,知识库是你不断增值的私有资产。
Karpathy, llm-wiki, GitHub Gist, 2026-04-04
II 练习二的工作空间
一个文件夹,三层东西
练习2_知识库/
├── AGENTS.md          ③ 讲清目录,新任务先读
├── 规则.md  索引.md    ③ 每次先读
├── 日志.md  术语表.md  ③ 记一笔,统一叫法
├── 关于我.md           ③ 收不收,看它
├── 收件箱/             所有素材先在这
│   ├── 大纲、九份网页快照、录屏逐字稿
│   └── 小红书链接.txt  不收/
├── 学习/ 工作/ 研究/   ② 条目,AI 编,AI 维护
├── 会议/ 想法/ 个人/   六个领域,现在空着
├── 原始资料/  空       ① 整理时挪进来,只读
├── .workbuddy/skills/  预装,打开就能用
│   └── personal-wiki/  web-access/
└── 待入库/             第三步才拿出来
学习/…/小组项目.md 课堂安排入库后,该多出来的一段
## 线上项目咨询
- 第三周与第四周之间,线上,14 组各 10 分钟,分两晚 [课程大纲_学员版.md 四、7.3]
- 带上给本组场景想的知识库,按三层想:原始资料放什么、条目分几种、规则写哪几条 [第5次课_课堂安排.md]
原始资料里没有一份叫小组项目的文件。这一页是它从大纲、前几次课的课件和实操页、今天的课堂安排 里拼出来的,每句话都指得回原件。这就是编 。
II 规矩写在一份文件里
知识库的规则,不用你手写
.workbuddy/skills/personal-wiki/SKILL.md 入库第 4 步
4. 说法对不上,分三种情况:
- 同一类来源,后发的改了先发的 (后一次课改了前一次课说的安排,新通知改了旧通知):正文改成新的;旧说法挪到这页末尾的「变更记录」,写清哪份、哪天改了哪份。
- 来源分高低 (规则.md 里写了以哪份为准):正文照高的写,低的写进「待核」。
- 分不出谁对 :不替用户挑,两种说法都写进「待核」,各写出处。
后发的改先发的 · 课程调安排会碰上 以后课程再调一次安排,新通知改了旧通知。正文写新的,旧说法进变更记录,写清哪份改的
来源分高低 · 放工作材料会碰上 规则里写一句制度原文高于会议纪要。两份对不上,正文照制度写,纪要那句进待核
分不出谁对 · 放简历会碰上 简历和年度总结写的到岗年份不一样。它不替你挑,两种都进待核,等你拍板
这类文件不用自己手写。技能里写好了通用做法,材料包里的规则.md 我起了头,以后加主题由它起草,你看过说可以再加。你不用会写员工手册的排版,但得知道手册里该有岗位职责、工作流程和红线 。
II 落到 WorkBuddy 上
个人知识库和资料库,各管一摊
WorkBuddy 资料库 · ima · 乐享
放量大、偶尔查、团队共用 的原件,制度汇编、产品手册、历年研报
资料进来时切好块,问的时候捞回几段
你的个人知识库 · 一个文件夹
放你那摊事的来龙去脉 ,课程、工作、个人
来的时候就编好,问的时候整页读
对不上的,它入库时就替你标出来
课后接着用 今天放的是课程。课后把脱敏的简历、手头一份工作说明拷进 练习2_知识库/,入库到 个人/、工作/,就能问跨领域的问题,比如照我的简历,哪两次课对我的工作最有用 。练习2_知识库/ 别删 ,挪到固定位置,以后选它当工作空间。
知识库里的东西每次读都会发给模型。还是第 3 次课那三类,自己的材料脱敏后再进,内网和客户真实数据不进 。
II 收件箱
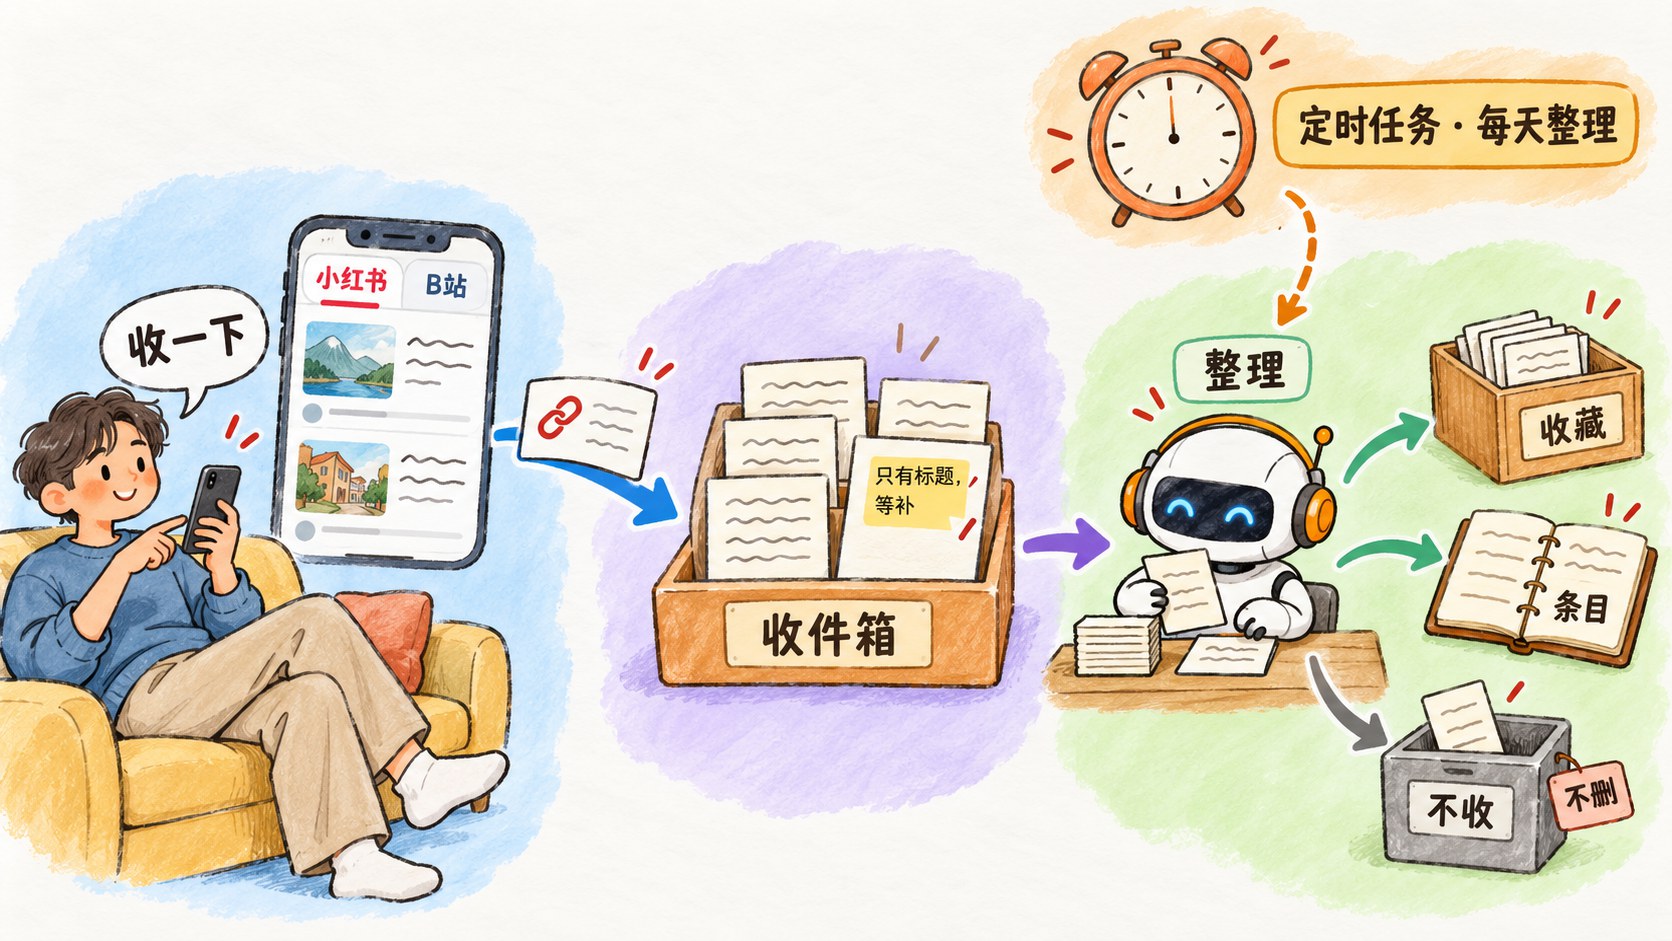
刷到的先收进收件箱,整理交给它
小红书链接.txt 里放了两条,课后说一句收一下试试
先用 WorkBuddy 自带的网页读取 常弹安全验证。视频笔记多半只读到简介
读不到,可以换 web-access 已经装好,要先在 Chrome 打开远程调试。它的说明写着有封号风险 ,课上不强推
还读不到,复制正文或截图给它 全部读得到。读到什么存什么,读不到就说读不到
刷到的链接说收一下 ,先进收件箱;自己想到的一句话说记一下 ,它直接存原件、补条目。
web-access v2.4.3,一泽Eze,github.com/eze-is/web-access,MIT,README 写明要 Chrome 远程调试、操作小红书有封号风险;小红书链接为 codebuddy 命令行 2026-10-17 实测
II 演示
整理一次,问一次,新的进来关掉再问
01 · 整理收件箱 · 课前预跑
收件箱里的课程资料 用预装的 personal-wiki,照规则把大纲、九份快照、录屏逐字稿挪进原始资料,编四页条目。翻原件、条目和日志
盯:收件箱还剩什么,有没有出处
课前预跑,和练习二第一步一个做法
02 · 新任务问
三个问题 第 6 次课讲什么、课间问卷什么时候填在哪、小组知识库按什么想
盯:先读索引没有,后两题答不上时说不说没有
课前预跑,试跑约 2 分钟
03 · 新资料进收件箱
今天的课堂安排 同一个任务里接着发,让它从 待入库/ 复制进收件箱再整理
盯:日志多一笔,新消息补进哪页
课前预跑
04 · 关掉再问
后两题 现场新建任务,再问课间问卷和小组知识库
盯:答得上了,出处是课堂安排吗
现场跑,试跑不到 1 分钟
同一份课堂安排丢进聊天框,它只做了理解;放进收件箱整理,它还归档、补进该在的那一页、补索引,下回直接翻出来 。
练习 二 每人一份 · 工作空间 练习2_知识库/ · 全程不联网
资料先进收件箱,整理交给它
一 整理收件箱 2-1 休息时已发。它先读 AGENTS.md 和规则.md,再整理
二 新建任务问 新建任务 发 2-2,三个问题,答不上的看它说不说没有
三 新资料进收件箱 接着发 2-3 ,它把 待入库/ 那份复制进收件箱再整理
四 记一下 接着发 2-4,把小实验的结果记进知识库 。那句话照你自己的结果改
五 关掉再问 新建任务 发 2-5,三个问题,这回都该答得上 ,看出处
II 怎么算做完
验收五条,每条回原文核
# 检查项 过的标准
1 收件箱理完,句句有出处 课程资料都挪进 原始资料/…/MDE智能体课程班/,收件箱只剩 小红书链接.txt 和 不收/;四页条目在 学习/…/MDE智能体课程班/,句句有出处,索引多了四行,日志记了这次整理 2 新任务里先读了规则和索引 第 6 次课答的是企业分享,带出处 3 库里没有,就说没有 课间问卷、小组知识库两题,入库前答知识库里没有 ,没有编一个出来 4 新来的补进去,下回答得上 课堂安排整理进库后,关掉再问,问卷和小组知识库两题答得上,出处是 第5次课_课堂安排.md 5 记一下,也进了库 原话存成了原件,相关条目多了一句、带出处,日志记了一笔;关掉再问,子代理读不读 AGENTS.md 答得上,出处是你记的那份
第 2 条和第 4 条,自己翻大纲和 待入库/ 里的课堂安排核一遍。它说得越笃定,越要核。
II 课后接着想
这门课只是例子,分法你来定
练习2_知识库/  只画条目
├── 学习/
│   ├── AI学习/MDE智能体课程班/ 今天的例子
│   │   └── 课程安排  作业与考核
│   │       小组项目  工具与操作
│   ├── AI学习/收藏/  课后收的
│   └── 其他课程/
│       ├── 【这学期另一门课】/
│       │   └── 课程安排  个人作业
│       │       小组作业  ……
│       └── 【再一门课】/
└── 工作/  研究/  会议/  想法/  个人/  以后加
框架哪门课都能用 练习二用的是这门课,因为资料大家手上都有。原件只读、条目它编、规矩写在规则.md,课后照同一个框架放别的课
这学期别的课也放进来 课件、作业要求、群里的通知,说一句入库,路径写 学习/其他课程/课程名/。加新主题,它先出方案给你看
想想分法合不合适 每门课都有个人作业和小组作业。作业与考核一页够不够,要不要拆开,小组那页要不要记分工?想好了让它改规则.md
今天的四页是起点,不是标准答案。分法不顺手就改规则,它照新规则把旧条目补一遍 。
A2 怎么讲
打开分享链接,对着对话讲四件事
讲 题目 在对话里指给大家看
一 用了哪个技能 现成的还是自己改的,它在哪一步用上了这个技能 二 接了什么数据 一个连接器、一张表还是一个文件夹,它从哪取的数 三 完成了哪件日常工作 原来你怎么做,最后交出来的是哪一份 四 哪一步卡住 卡在哪一轮对话,你后来补了哪句话 最后 一条改进 用今天的子代理或知识库 ,说清改哪一步、为什么。能并排的那段派出去,核对那一步换一双眼睛;每次都要补给它的背景,编进知识库
已报名的三位同学上台,一共二十分钟左右。不另做 PPT,在 WorkBuddy 里翻到哪讲到哪。最后那条是硬的,说不出改进,这次上台不算数。
下午见
W3 下午 · 企业分享(极视角)
带着上午的那队子代理和你的知识库,去听企业怎么落地