课程导论
AI 从哪里来
中山大学岭南学院 · 金融AI智能体设计与应用
副教授
- 研究方向 预期管理、文本数据分析与资产定价
- 本学期 为金融硕士、MDE 与本科三个班次讲授智能体课程
- 课程资料页 ai.lingnan.top/materials/2026-autumn-mf
- 课程教材 ai.lingnan.top/book
- 个人主页 lingnan.sysu.edu.cn/faculty/ZhangYifan
- 联系方式 zhangyf278@mail.sysu.edu.cn
今天下午,分三个部分
| 部分 | 主题 | 主要内容 | 动手 |
|---|---|---|---|
| 一 | 课程安排与考核 | 九次课的主题,考核办法,两项个人作业与小组项目,分组规则 | 举手自评 |
| 二 | 课程平台与开发环境 | 作业平台与资料页;智能体的四层架构;Claude Code、CC Switch 与 DeepSeek 的安装与验证 | 课堂装机 |
| 三 | 人工智能发展简史 | 规则与学习两种思路的交替演进,从达特茅斯会议到大模型与智能体 | 写规则、估参数 平台使用练习 |
课程安排
与考核
三次举手,看看你现在在哪一步
用过对话工具
DeepSeek、豆包、ChatGPT,
问过问题、让它写过东西
攒过自己的做法
把常用提示词存下来反复用,
或让 AI 写过脚本替你跑
搭过一套流程
让 AI 读写电脑里的文件,
自己连着跑完好几步
九次课,走三层台阶
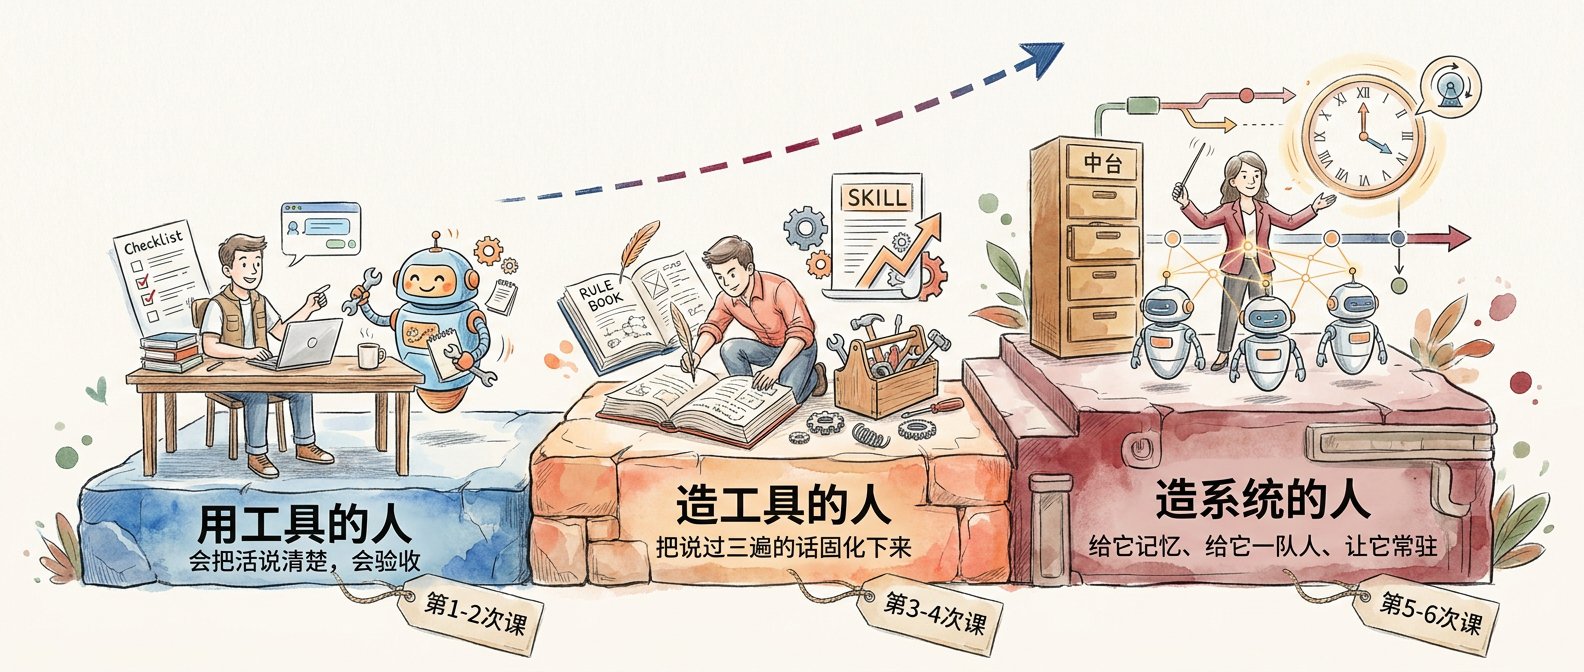 第 1 次课
第 2-3 次课
第 4-8 次课
九次课,每次课你会做出什么
| 次 | 日期 | 主题 | 主要内容 |
|---|---|---|---|
| 1 | 9/16 | 人工智能发展与智能体概览 | 人工智能发展脉络;开发环境安装与配置;记忆文档;组建小组 |
| 2 | 9/23 | 技能(Skill) | 技能的结构与渐进式披露;常见技能框架;编写金融技能;小组场景分享 |
| 3 | 9/30 | MCP 与论文复现 | 接入文献库、协作文档与金融数据服务;调用 Stata 或 Python 复现实证研究 |
| 4 | 10/10 周六 | 多子代理与上下文管理 | 子代理的适用情形与分工设计;上下文管理;个人作业一展示 |
| 5 | 10/14 | 任务编排与浏览器控制 | 子任务与子代理的编排;由智能体操作浏览器;小组进度汇报 |
| 6 | 10/21 | 个人知识库与常驻智能体 | RAG 与 Wiki 两种知识库方案的比较;常驻智能体的功能与部署 |
| 7 | 10/28 | 自动化工作流 | 办公流程自动化的设计与迭代;个人作业二展示 |
| 8 | 11/4 | 金融投资专题 | 量化投资中的智能体;投资顾问与行业研究中的智能体与技能 |
| 9 | 11/11 | 小组终期展示 | 各组展示带有 AI 模块的网页项目 |
每次课,大体相同的结构
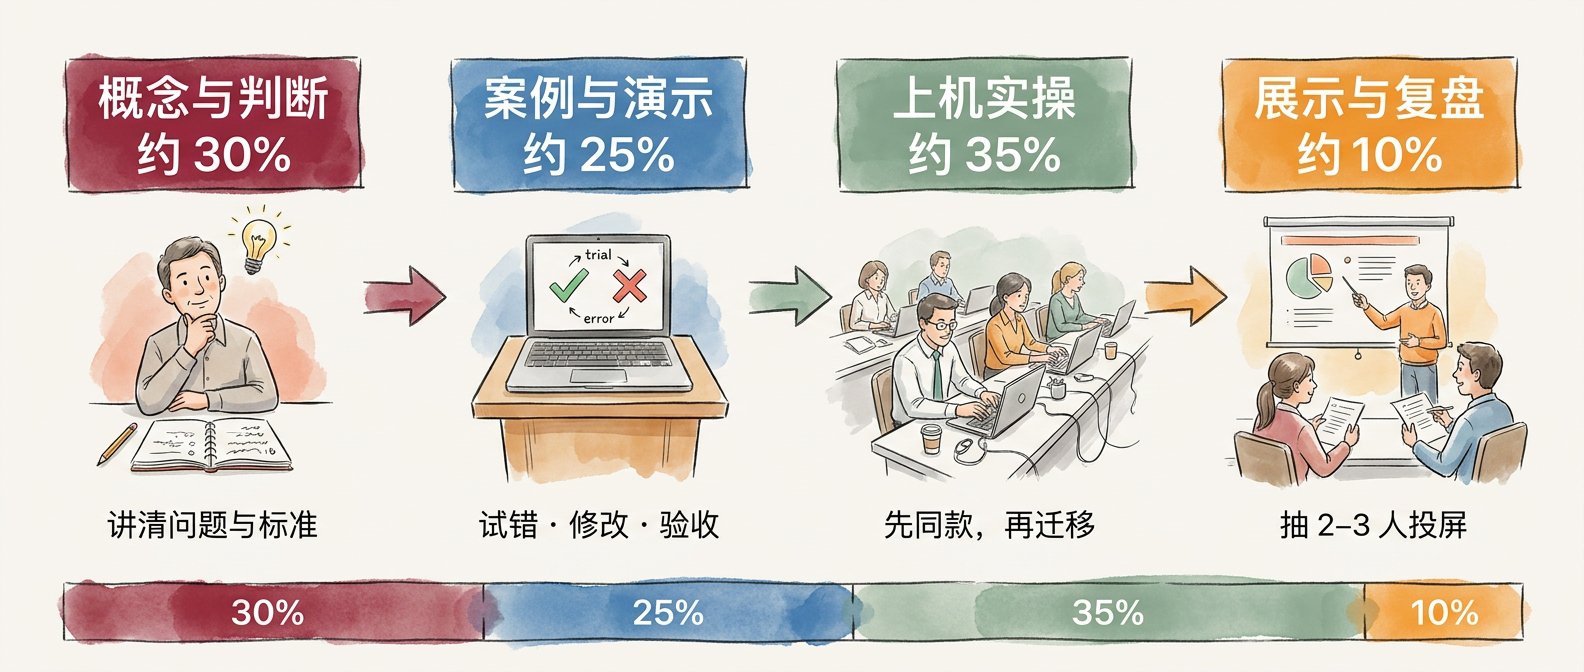
这门课不绑定任何一个工具
会变的 · 几个月一变
- 软件的界面、命令与菜单
- 模型能做到哪一步
- 各家的套餐、价格与额度
不会变的 · 这门课练的
- 把任务说清楚,判断哪些值得交给 AI
- 定验收标准,核对每个数字的来源
- 留下交互记录,让别人能够复核
考核办法,个人 50,小组 50
| 归属 | 项目 | 分值 | 说明 |
|---|---|---|---|
| 个人 50 | 课堂参与 | 10 | 出勤、随堂练习、课间问卷 |
| 个人作业一 · 论文复现 | 20 | 10 月 10 日提交 | |
| 个人作业二 · 行研报告或技术分享 | 20 | 10 月 28 日提交 | |
| 小组 50 | 进度汇报 | 10 | 第 5 次课,每组 5 分钟,全员参与 |
| 终期网页项目 | 40 | 第 9 次课,按组内互评折算到个人 |
两项个人作业
论文复现
自选一篇实证论文,借助 Claude Code 复现其实证程序,并在此基础上做拓展。数据须可公开获取,Stata 或 Python 均可。
提交内容 复现报告与代码;与 Claude Code 或类似 AI 软件的交互记录,一个或多个会话均可。
行研报告或技术分享
行研报告 针对某一行业开展研究,题目自定;无特定题目的,建议研究 AI 与该行业的现状及趋势。
技术分享 介绍一组现有金融技能(3 至 5 个)的设计思路与功能。
小组项目,带 AI 模块的网页
- 功能由小组自定,例如智能体自动审稿、附带出处的研报问答、金融知识对话助手
- 至少完成本地部署,能在本机浏览器访问;部署到公网服务器的加分
- 无须事先掌握编程,由 Claude Code 编写代码,小组负责提出需求与验收,第 2 次课介绍起步方法
进度汇报
当前进展、遇到的问题与后续计划。
终期展示
演示网页与 AI 模块;提交代码与交互记录。
五个例子,看做到什么程度算完成
| 题目 | 用户在网页上做什么 | AI 模块负责什么 |
|---|---|---|
| 研报问答 | 上传一批券商研报,用自己的话提问 | 找出相关段落回答,每句标出处与页码 |
| 论文审稿 | 贴进一篇工作论文,选一份评审清单 | 逐条对照清单给意见,指出证据不足的地方 |
| 年报指标提取 | 选几家公司,勾选要看的指标 | 从年报抽数生成对比表,标明每个数字在第几页 |
| 话术合规检查 | 粘进一段面向客户的沟通文本 | 比对口径清单,标出越界的句子并给改法 |
| 基金筛选解释 | 按条件筛一批基金,点开其中一只 | 用一段话说清它为什么被筛出来、风险在哪 |
九次课中的五次展示
| 课次 | 内容 | 展示者 | 时长 |
|---|---|---|---|
| 第 2 次课晚 | 小组项目设想 | 抽取 4 至 5 组 | 共约 45 分钟,含点评 |
| 第 4 次课晚 | 个人作业一 · 论文复现 | 报名 5 至 10 人 | 每人约 15 分钟,含讨论 |
| 第 5 次课晚 | 小组进度汇报 | 19 组 · 全员 | 每组 5 分钟 |
| 第 7 次课晚 | 个人作业二 · 行研报告或技术分享 | 报名 5 至 10 人 | 每人约 15 分钟,含讨论 |
| 第 9 次课 | 小组终期展示 | 19 组 · 全员 | 12 分钟讲解 + 3 分钟问答 |
91 人,今晚组成 19 个组
- 每组 4 到 5 人,自由组队;一个组满 5 人就加不进去了
- 登录作业平台 hw.lingnan.top/mf,在「我的小组」建组,队长搜同学姓名拉人
- 被拉的同学登录后点确认;本周五前仍未进组随机分组
- 建组即得组号,第 2 次课前每组在平台提交《场景确认》
遇到问题,分两步处理
先问 AI
把报错原文完整发给 Claude Code,由它诊断。
多数问题在这一步即可解决,
这本身也是本课要训练的能力。
再问同学与老师
先请教身边的同学;
仍未解决的,课间或课后找老师。
本课程的四条红线
- 课堂练习和作业只使用公开数据与虚构材料
- 实习单位的内部材料与客户信息,一律不上传公网模型,不写入作业
- DeepSeek 的 API 密钥与账户余额直接相关,不截图、不外发,不写入提交的文件与网页代码
- 编造数据、来源或运行记录,按学术诚信问题处理,不视为一般技术错误
课程平台
与开发环境
课程的东西,集中在两个地址
组队、提交作业、展示报名都在这里。第一次登录用学号和姓名核对身份,再自己设密码
每次课一个材料包:课件、练习网页、练习素材,第 1 次课另附装机手册
四层架构,智能体在第三层
在远端服务器上,负责理解与生成。它只读你给它的字,再吐出字
DeepSeek · Kimi · GLMClaude · GPT
一次次调用,按 token 计费。token 是模型计字的单位,一个汉字约 0.6 个
api.deepseek.com在你电脑上跑,替大模型动手
Codex
文件夹、表格、年报 PDF、取数脚本都在这里
VS Code · 终端Excel · PDF
中外智能体工具
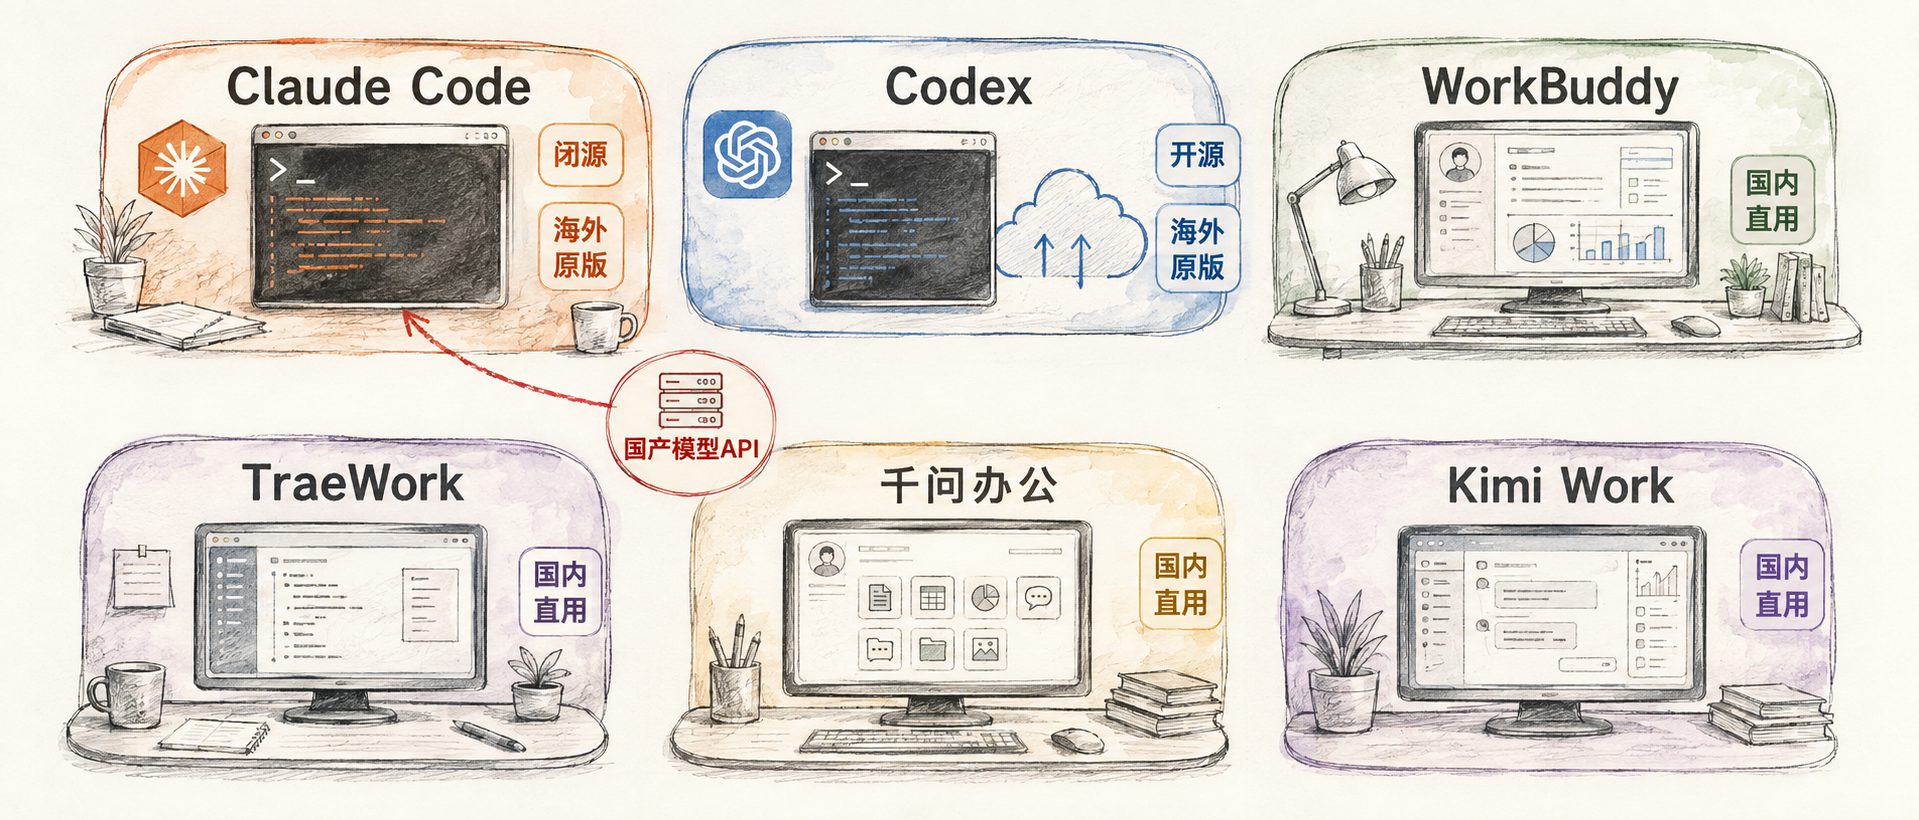
Claude Code 与 Codex,差在哪
| Claude Code | Codex | |
|---|---|---|
| 出品方 | Anthropic | OpenAI |
| 源码 | 闭源 | 开源 |
| 规则文件叫什么 | CLAUDE.md | AGENTS.md |
| 怎么接 DeepSeek | CC Switch 一键启用,或写 settings.json | DeepSeek 官方脚本写 config.toml |
| 本课怎么用 | 主用,今天装好 | 第 4 次课前装,审子代理交出来的东西 |
CC Switch 在中间干什么
- Claude Code 自己不带模型,它读配置决定把请求发给谁
- CC Switch 是开源工具,只做一件事,替你改这份配置,想换一家模型点一下就行
- 模型名填
deepseek-flash,再勾上旁边的 1M,Claude Code 就按 100 万上下文来管理。别手打 [1m],CC Switch 会自动去掉
装机共八步,跟着一起操作
| # | 步骤 | 操作 | 完成标志 |
|---|---|---|---|
| 1 | 打开终端 | Windows 用 PowerShell 并放开脚本限制 | 出现提示符 |
| 2 | 安装 Node.js | 镜像下载 v24;Mac 另改 npm 全局目录 | node -v |
| 3 | 安装 Git | 仅 Windows,按默认选项 | git --version |
| 4 | 安装 Claude Code | 切换 npm 镜像后全局安装 | claude --version |
| 5 | DeepSeek 密钥 | 注册、实名、充值、创建密钥 | sk- 开头 |
| 6 | 安装 CC Switch | 官网 ccswitch.io/zh 或 GitHub 发布页下载 | 可以打开 |
| 7 | 配置 DeepSeek | 选 DeepSeek 预设,填密钥,改模型名,启用 | 显示已启用 |
| 8 | VS Code 与插件 | 解压素材包打开练习1;扩展面板装 Claude Code 插件 | 左侧出现图标 |
CC Switch 中,核对这几个字段
| 字段 | 填写内容 | 说明 |
|---|---|---|
| 请求地址 | https://api.deepseek.com/anthropic | 预设已填好 |
| API Key | 你创建的 sk-… 密钥 | 粘贴,不要外发 |
| 模型映射各行 | deepseek-flash,勾 1M | 预设默认为 v4-pro,需改。Sonnet 行填好点一键设置 |
| Haiku 行 | deepseek-flash,无 1M 勾选框 | |
| 默认兜底模型 | deepseek-flash,勾 1M |
装机验收,三条全部通过
| # | 在终端中操作 | 通过标准 |
|---|---|---|
| 1 | claude --version | 显示版本号与 (Claude Code) |
| 2 | 进入练习文件夹,输入 claude,再输入 /model | 不要求登录,显示 deepseek-flash |
| 3 | 请它新建 hello.md,写一句话 | 文件夹中出现该文件,DeepSeek 用量页有消耗 |
deepseek-flash,按用量计费
| 元 / 百万 token | 空闲时段 | 高峰时段 |
|---|---|---|
| 输入 · 缓存命中 | 0.02 | 0.04 |
| 输入 · 缓存未命中 | 1.00 | 2.00 |
| 输出 | 4.00 | 8.00 |
| 上下文 · 看图 | 100 万 token · 能看图 | |
- 高峰是工作日 9:00-12:00、14:00-18:00,其余时间半价。我们下午的课在高峰里
- 多轮对话里重复发送的内容算缓存命中,价格低几十倍,实际账单比按表硬算低得多
国内模型套餐,价格与额度
| 平台 | 入门档 · 月付 | 中档 · 月付 | 高档 · 月付 |
|---|---|---|---|
| MiniMax Token Plan | Plus · ¥49 约 6 亿+ token / 月* | Max · ¥119 约 18 亿+ token / 月* | Ultra · ¥469 约 71 亿+ token / 月* |
| 智谱 GLM Coding Plan · 积分 | Lite · ¥118 2 千 / 5 小时 · 1 万 / 周 | Pro · ¥538 1.2 万 / 5 小时 · 6 万 / 周 | Max · ¥1078 2.8 万 / 5 小时 · 14 万 / 周 |
| Kimi 会员 含 Code · 共享额度 | Andante · ¥49 约 30 次 Agent / 月* | ¥99 / ¥199 约 60 / 150 次 Agent / 月* | Allegro · ¥699 约 360 次 Agent / 月* |
| 阿里百炼 Token Plan · Credits | Lite · ¥39(常规 60) 2,500 / 7 天 | Standard · ¥139(常规 180) 10,000 / 7 天 | Pro · ¥499(常规 600) 40,000 / 7 天 |
大厂的办公智能体,会员价格
| 产品 | 入门档 · 月付 | 中档 · 月付 | 高档 · 月付 |
|---|---|---|---|
| WorkBuddy 腾讯 | 标准版 · ¥99 2,000 积分 / 月 | 高级版 · ¥199 4,000 积分 / 月 | 旗舰版 · ¥999 20,000 积分 / 月 |
| TraeWork 字节跳动 | Lite · ¥49 2,000 Work 积分 / 月 | Pro · ¥99 / Pro+ · ¥239 4,000 / 12,000 积分 / 月 | Ultra · ¥699 40,000 积分 / 月 |
| 千问办公 阿里巴巴 | 免费版 · ¥0 注册送 2,000 积分 | 标准版 · ¥98 | 高级版 · ¥198 |
| Kimi Work 月之暗面 | 与 Kimi 会员共用额度,Andante · ¥49 起,档位见上一页 | ||
现在动手,把 Claude Code 装起来
照手册装
练习网页上打开装机手册,
八步照着走一遍。
课前已装好的直接跳到验收
接上 DeepSeek
CC Switch 里填密钥,
模型改成 deepseek-flash 勾 1M,
点启用
跑验收三条
版本号出得来,
/model 显示 deepseek-flash,
让它新建一个文件
人工智能
发展简史
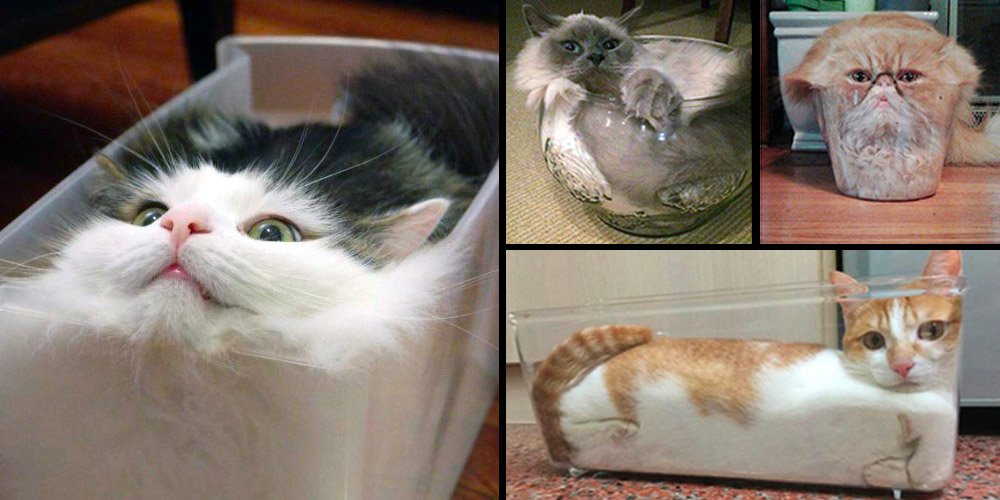
让计算机认出一只猫
怎样让计算机认出一只猫
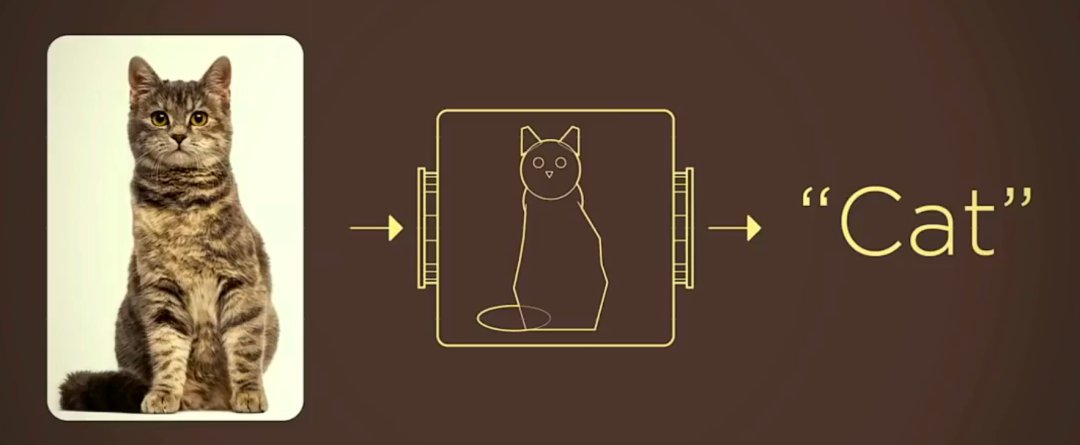
可是猫,会变成容器的形状
由人写规则,还是让机器自己学
规则路线 · 符号主义
- 智能就是按规则推理
- 把专家知识写成「如果……那么……」
- 长处是说得清为什么
学习路线 · 连接主义
- 智能来自大量简单单元的连接
- 给出例子,由模型自己调整参数
- 长处是能处理说不清规则的问题
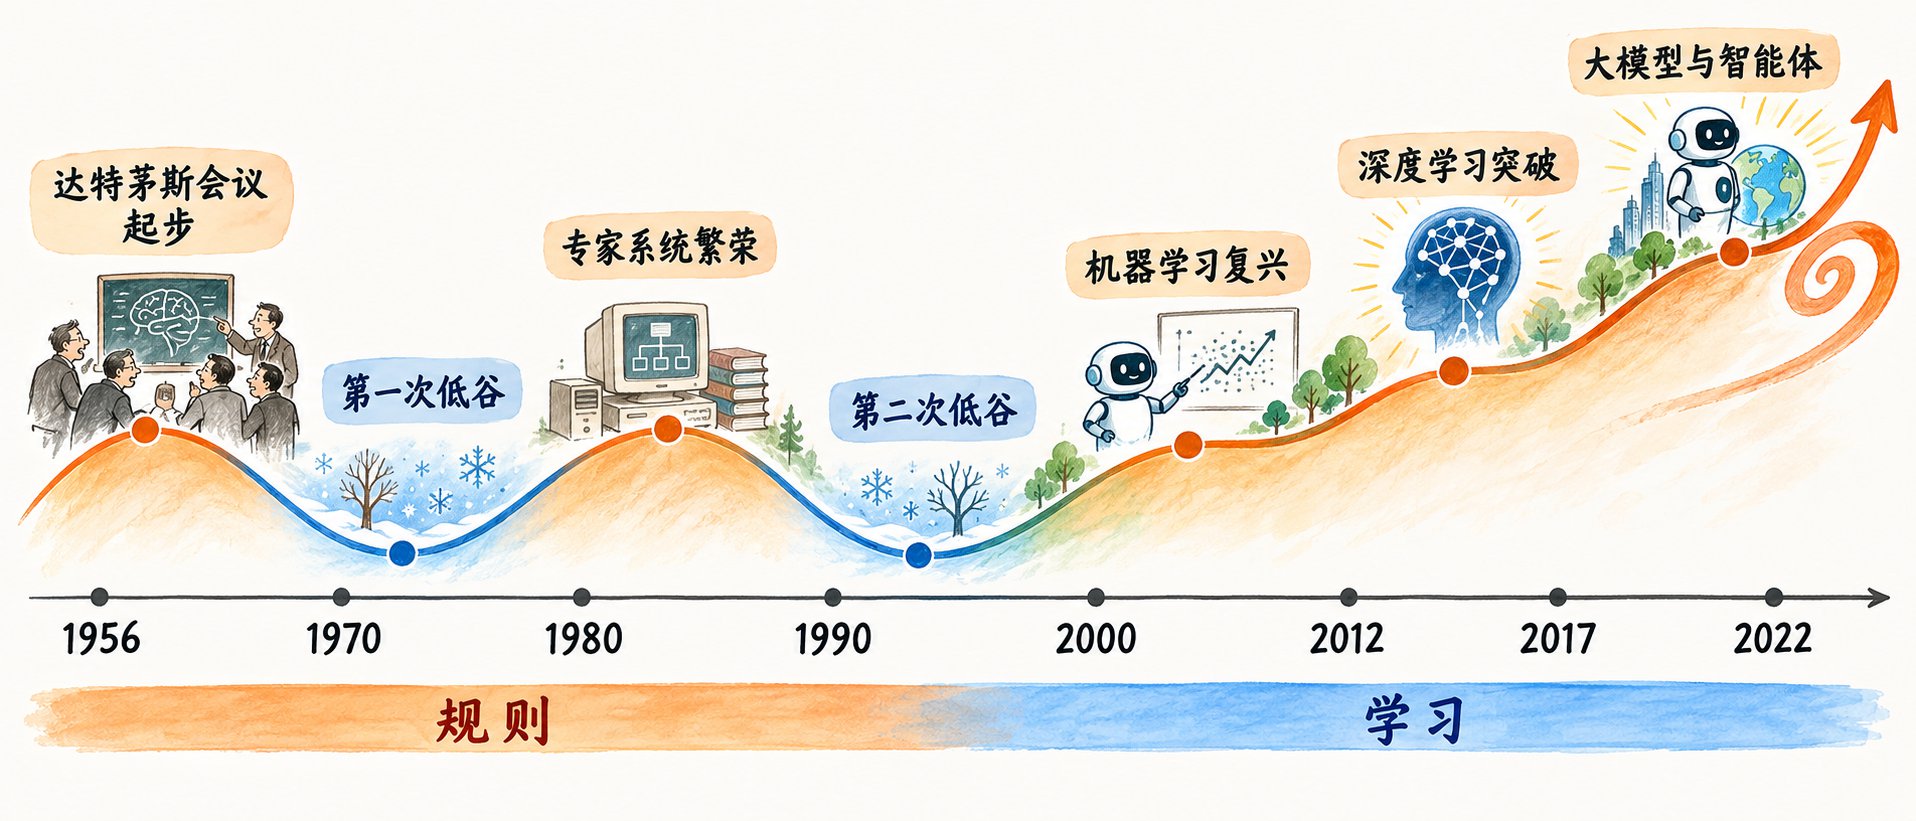
从达特茅斯开始,几起几落
图灵,机器能思考吗
- 1950 年发表《计算机器与智能》
- 他不去定义思考,而是提出一个可以检验的问题:隔着屏幕交谈,能否分辨对方是人还是机器
- 这就是后来所说的图灵测试
我提议来思考这样一个问题:机器能思考吗?
达特茅斯会议,人工智能得名
- 1955 年麦卡锡、明斯基、罗切斯特、香农撰写项目提案,首次使用 artificial intelligence 一词
- 1956 年夏天在达特茅斯学院举行两个月的研讨会
- 之后十余年,机器定理证明、跳棋程序相继出现
学习的每一个方面,或智能的任何其他特征,原则上都可以被精确描述,以至于可以造一台机器来模拟它。
感知机,第一台会学习的机器
- 罗森布拉特提出,后来做成了硬件
- 若干输入各乘一个权重,加总超过阈值就输出 1
- 判断错了就调整权重,机器最早的学习就是这个动作
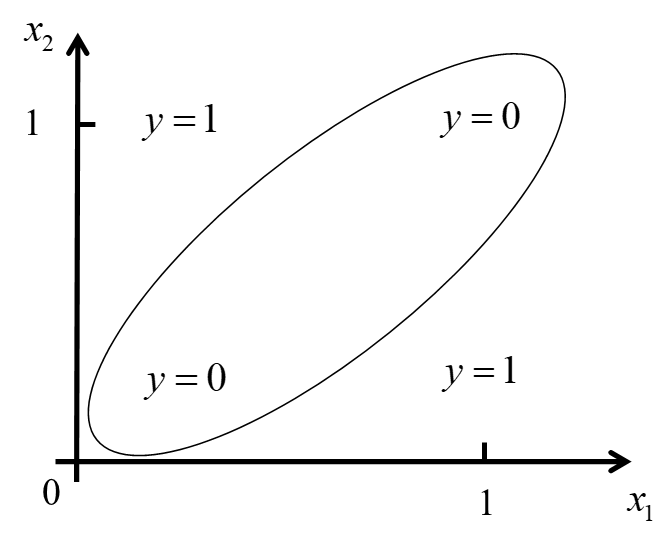
一条直线,分不开异或
- 单层感知机只能画一条直线划分两类样本
- 异或(两个输入相同输出 0,不同输出 1)的四个点,任何一条直线都分不开
- 1969 年明斯基与佩珀特出版《感知机》,指出这一局限,学习路线由此遇冷
- 1973 年英国莱特希尔报告批评 AI 未兑现承诺,经费大幅削减
专家系统,把专家的规则写进去
| 系统 | 做什么 | 说明了什么 |
|---|---|---|
| MYCIN 斯坦福 · 1970 年代 | 用几百条规则诊断血液感染、推荐抗生素 | 在窄领域内,规则可以接近专家水平 |
| XCON DEC · 1980 年起 | 按订单自动配置计算机零部件 | 首次在企业中切实节省成本 |
| 信用卡授权助手 美国运通 · 1988 年 | 辅助授权员判断大额消费是否批准 | 金融业很早就是 AI 的用户 |
规则路线的瓶颈,知识写不完
- 规则冲突 规则上千条之后相互矛盾,改动一条会牵连哪些,难以说清
- 维护成本高 业务一变,就要请专家重新梳理
- 无法应对例外 规则没有覆盖的情形,系统不会举一反三
- 市场萎缩 个人电脑与工作站取代了专用的 LISP 计算机,日本第五代计算机计划未达目标
从人写规则
到从数据中学习
遇冷的二十年,学习路线没有中断
| 年份 | 事件 | 意义 |
|---|---|---|
| 1986 | 鲁梅尔哈特、辛顿、威廉姆斯发表反向传播方法 | 多层网络可以训练 |
| 1989 | 杨立昆用卷积网络识别手写数字,后用于银行读取支票 | 神经网络首次进入金融业 |
| 1990s | 支持向量机等统计学习方法成为主流 | AI 从讲规则转向讲概率 |
| 1997 | IBM 深蓝战胜国际象棋世界冠军卡斯帕罗夫 | 依靠搜索,而非学习 |
| 2006 | 辛顿与萨拉赫丁诺夫在《科学》发表深度网络训练方法 | 深度学习一词开始流行 |
算法、数据、算力,缺一不可
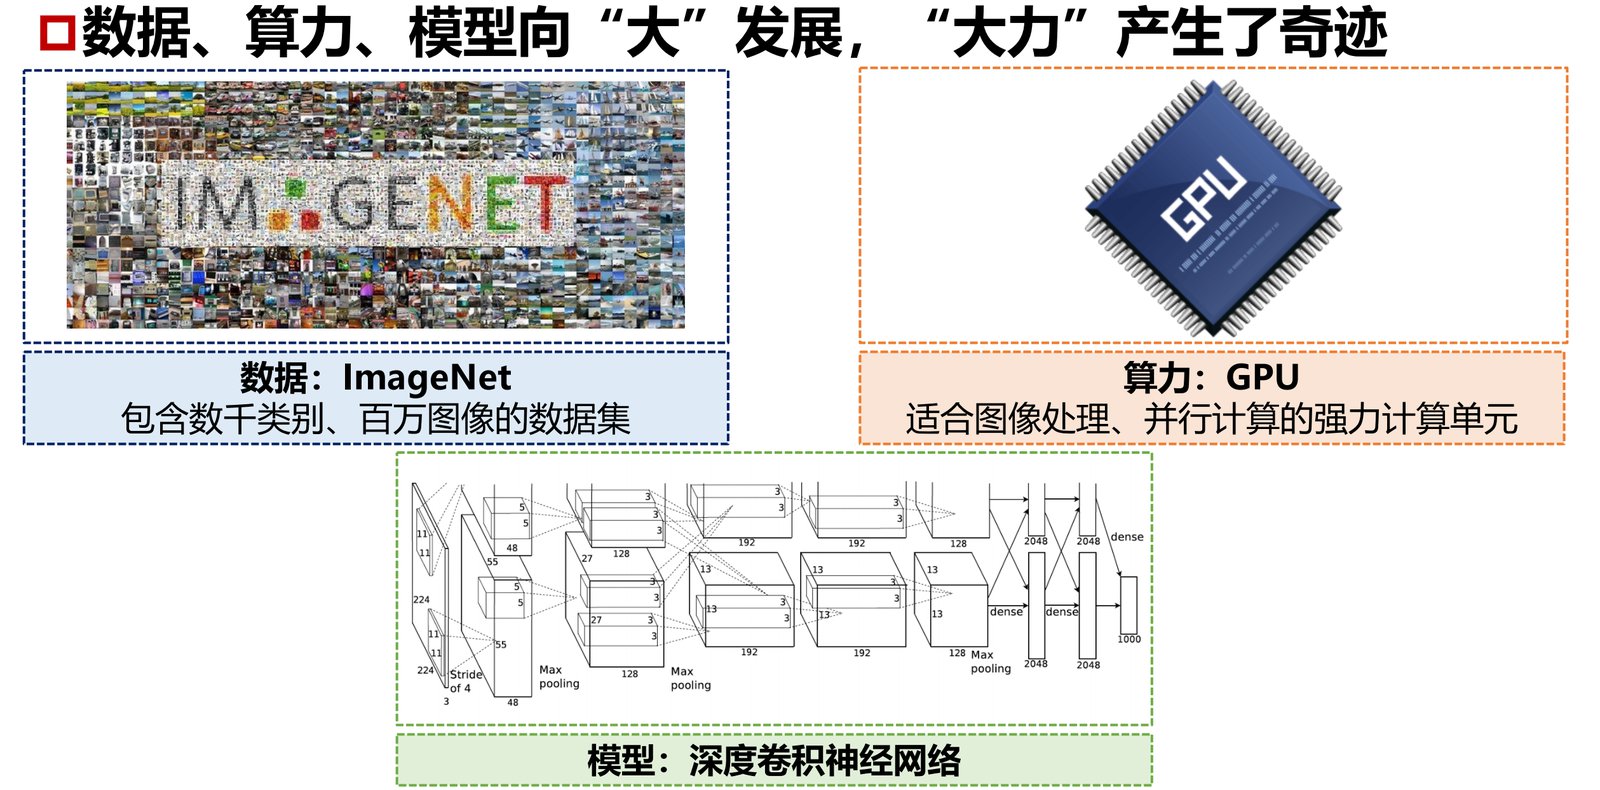
三件小事,分别补上了三块短板
深层网络训得动了
辛顿等人提出逐层预训练,深层网络的训练出现转机;此后更好的激活函数与初始化方法陆续出现。
ImageNet
李飞飞团队构建大规模标注图库,后扩展到 1400 余万张。竞赛使用其中 120 万张、1000 类。
GPU 可以通用计算
英伟达推出 CUDA,游戏显卡可以用于矩阵运算,恰好适合神经网络。
AlexNet,错误率拉开十个百分点
类别均不正确的比例),采用传统方法
克里泽夫斯基、苏茨克维、辛顿
训练约五六天
- 此前每年进步一两个百分点,这一次拉开十个百分点,整个领域转向深度学习
- 论文作者之一苏茨克维,后来成为 OpenAI 的联合创始人
一场竞拍,为深度学习重新定价
- 辛顿与两名学生成立的公司 DNNresearch,3 个人,成立 1 个月
- 辛顿在太浩湖的酒店主持竞拍,谷歌、微软、DeepMind、百度以邮件出价,每次至少加价一百万美元
- 最终以 4400 万美元售予谷歌。一年多后,谷歌又收购了 DeepMind
- 此前几十年,神经网络在主流学界长期不受重视
AlphaGo 4 : 1 李世石
- 先学习人类棋谱,再自我对弈数百万盘,即强化学习
- 第二局第 37 手,职业棋手起初都认为是失误
- 2017 年的 AlphaGo Zero 完全不用人类棋谱,从零自学,超过了所有前代版本
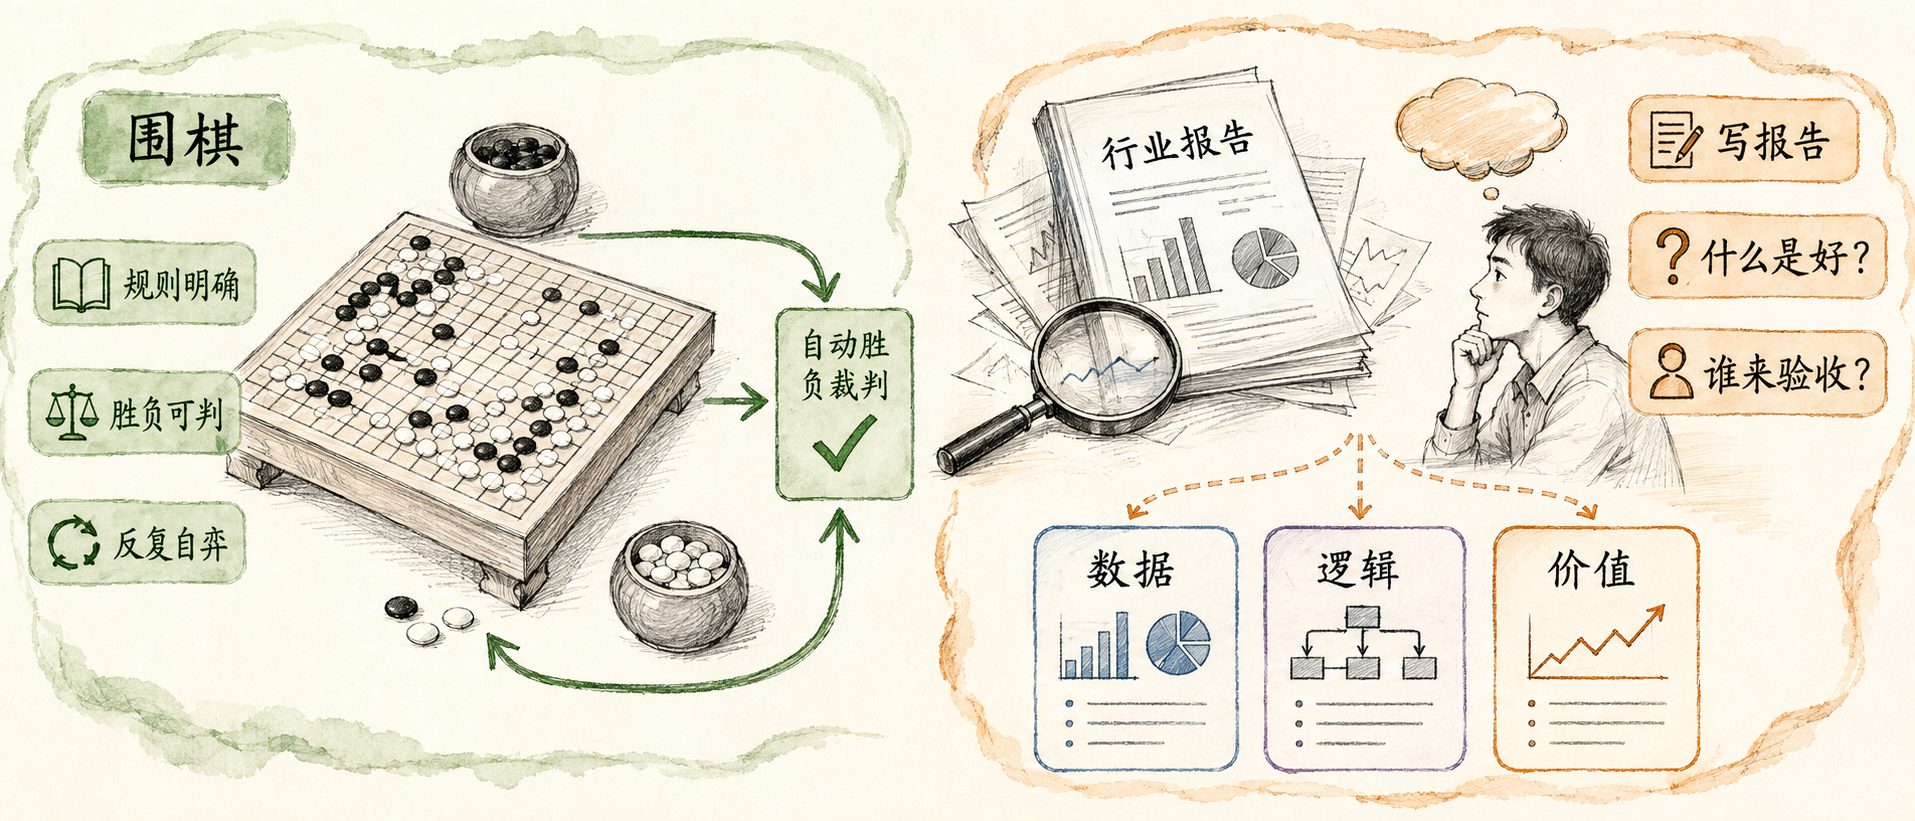
规则明确,胜负清楚,可以无限次自我对弈。每一盘都有自动的裁判判定输赢。
为什么没有白领版的 AlphaGo
从一个模型做一件事
到一个模型读遍所有文字
Transformer,一次看完整句话
此前的做法 · 逐词读取
- 如同逐字朗读,读到后面,前文越来越模糊
- 必须按顺序计算,无法并行
- 模型规模一大,训练慢得难以承受
Transformer · 注意力机制
- 每个词直接关注句中所有其他词,决定各自的权重
- 整句可以同时计算,发挥 GPU 的并行能力
- 模型因此可以不断扩大
参数量涨了多少倍?
模型越来越大
| 模型 | 参数 | 训练数据 | 训练算力 |
|---|---|---|---|
| GPT-1 · 2018 | 1.17 亿 | 约 7000 本书 | — |
| GPT-3 · 2020 | 1750 亿 | 3000 亿 token | 约 3×10²³ 次浮点运算 |
| Chinchilla · 2022 | 700 亿 | 1.4 万亿 token | 与 2800 亿参数的 Gopher 相同 |
| Llama 3.1 · 2024 | 4050 亿 | 超过 15 万亿 token | 3.8×10²⁵ 次浮点运算 |
- 参数即感知机中的权重;token 是模型处理文字的基本单位
- GPT-1 到 GPT-3,参数增长约 1500 倍;GPT-3 到 Llama 3.1,训练算力约增长 120 倍
从摩尔定律,到 AI 算力的指数增长
- 摩尔定律在放缓:单核性能年增幅已降到约 3%,单个晶体管的成本不再快速下降
- 算力增长转而依靠专用芯片与大规模并行。英伟达称其 GPU 的 AI 推理性能十年提升约 1000 倍,制程进步只贡献其中 2.5 倍
规模定律,从越大越好到怎样变大
| 时间 | 认识 | 含义 |
|---|---|---|
| 2020 | Kaplan 等(OpenAI) 模型损失随参数量、数据量、算力按幂律稳定下降 | 投入可预测地换来能力 |
| 2022 | Chinchilla(DeepMind) 参数与训练数据应同比例扩大;700 亿参数、4 倍数据的模型胜过 2800 亿参数的 Gopher | 光堆参数不够,数据要跟上 |
| 2024.09 | OpenAI o1 表现随训练中的强化学习和回答前的思考时间增加而提升 | 规模扩展到推理阶段 |
| 2024.12 | 苏茨克维 「我们只有一个互联网」,预训练数据接近上限 | 单纯扩大预训练的收益在减弱 |
AI 争夺产能,电脑硬件随之涨价
单季环比涨幅
相对 2025 年 7 月(德国市场)
美国零售中位价涨幅
- 存储原厂把产能转向 AI 服务器所需的高带宽内存与服务器内存,普通内存与固态硬盘供给收紧
- 英伟达 2026 年 5-7 月一个季度的数据中心营收达 890 亿美元,同比增长 117%;三季度内存涨幅开始收敛
它只学一件事,预测下一个词
- 把能获取的书籍、网页、代码作为语料,遮住下一个词让它猜,猜错了就调整参数
- 它每次预测之前能看到的全部文字,称为上下文
- 预测数千亿次之后,为了猜得准,它学会了语法、常识与推理的形式
- 因此它的输出看起来像真的,但它并不查证,只是给出最可能接续的内容
ChatGPT,两个月一亿用户
当时增长最快的消费应用
- 底层仍是预测下一个词,另加两步:用人工编写的问答示范教它遵循指令,再由人对回答排序,按人的偏好调整
- GPT-3 两年前已经发布但并未普及,普及的是一个人人会用的对话框
从更大,到更会思考
| 时间 | 事件 | 影响 |
|---|---|---|
| 2023.03 | GPT-4 发布,可以理解图片,多项考试成绩接近人类高分段 | 能力上了一个台阶 |
| 2024.09 | OpenAI o1 回答前先进行长时间推理,推理模型出现 | 数学、代码与多步分析明显改善 |
| 2025.01 | DeepSeek-R1 开源,推理能力接近 o1,API 价格低得多 | 国产模型进入第一梯队 |
| 2026.04 | DeepSeek V4 开源,上下文 100 万 token;9 月发布 V4.1-Flash | 一次可读入几份完整年报 |
只有一个对话框,数据要你搬进搬出
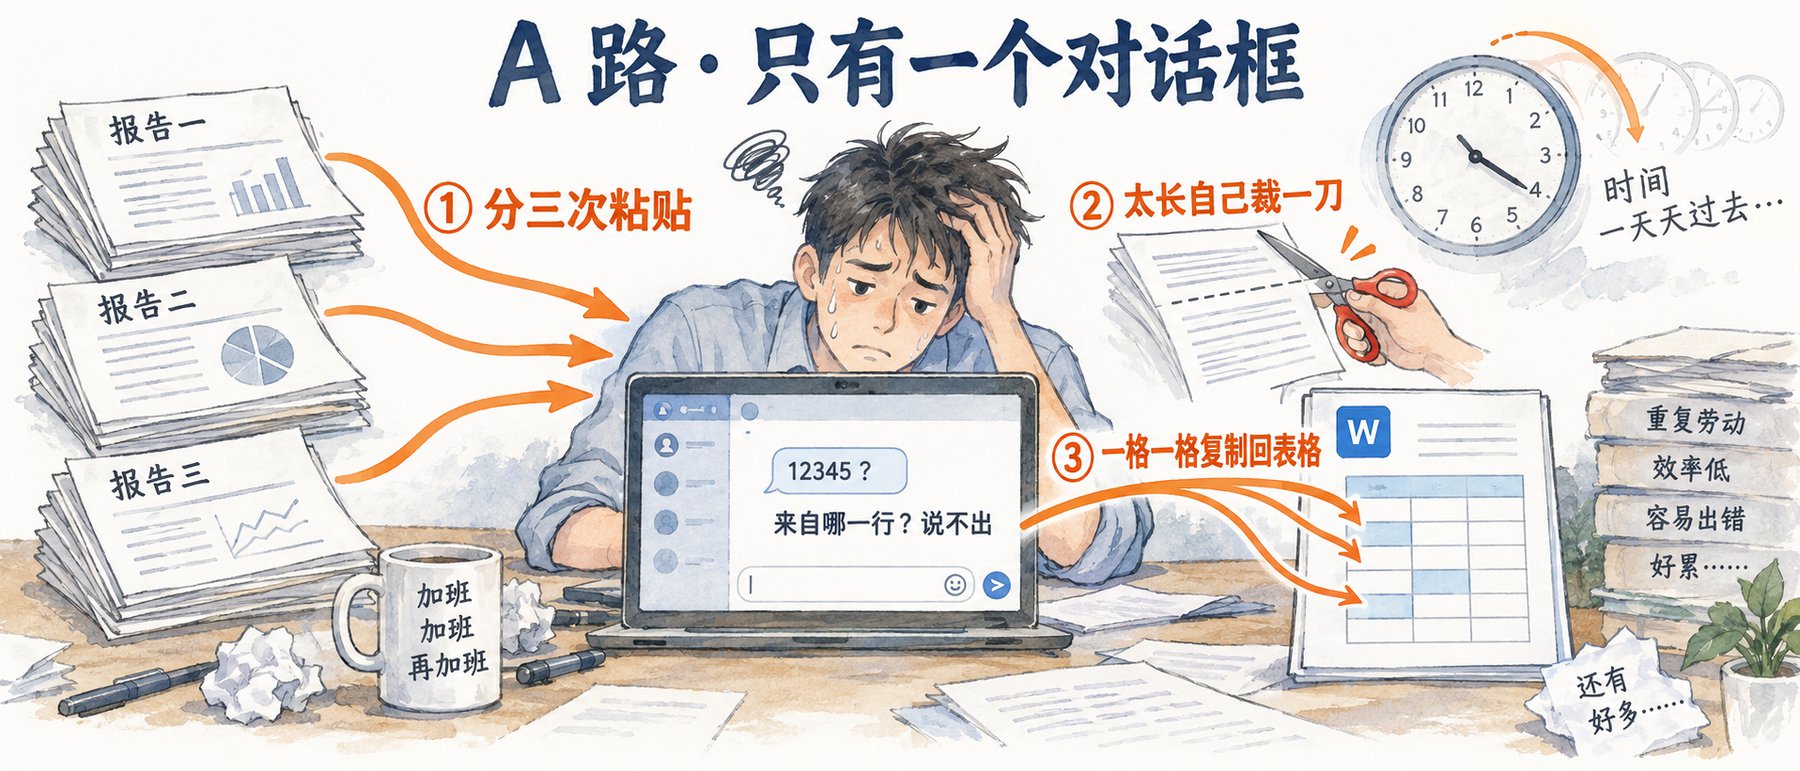
从会说
到会做
给模型接上工具
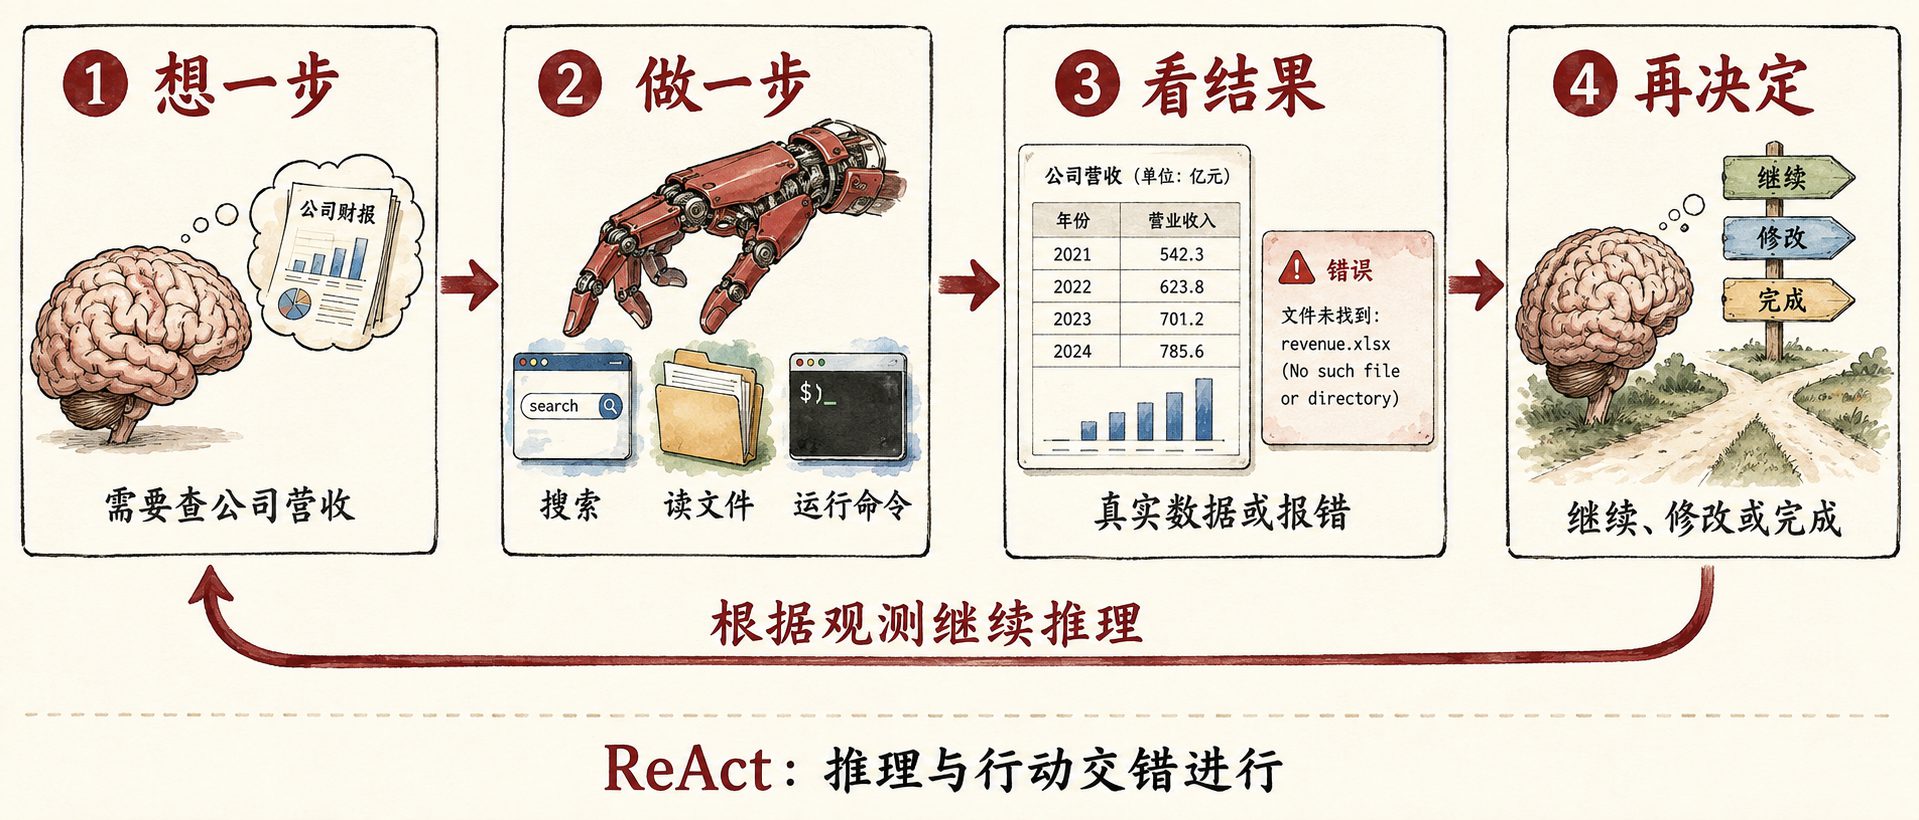
AutoGPT,为何兴起又退潮
- 兴起 给定目标后自行拆解任务、上网检索、循环执行,几周内成为 GitHub 上最受关注的项目之一
- 执行几步就偏离 当时的模型撑不起长链条任务
- 上下文容纳不下 任务进行到后面,前面的信息装不进去
- 缺少验收 它声称完成,是否正确没有标准
编码智能体,为何率先落地
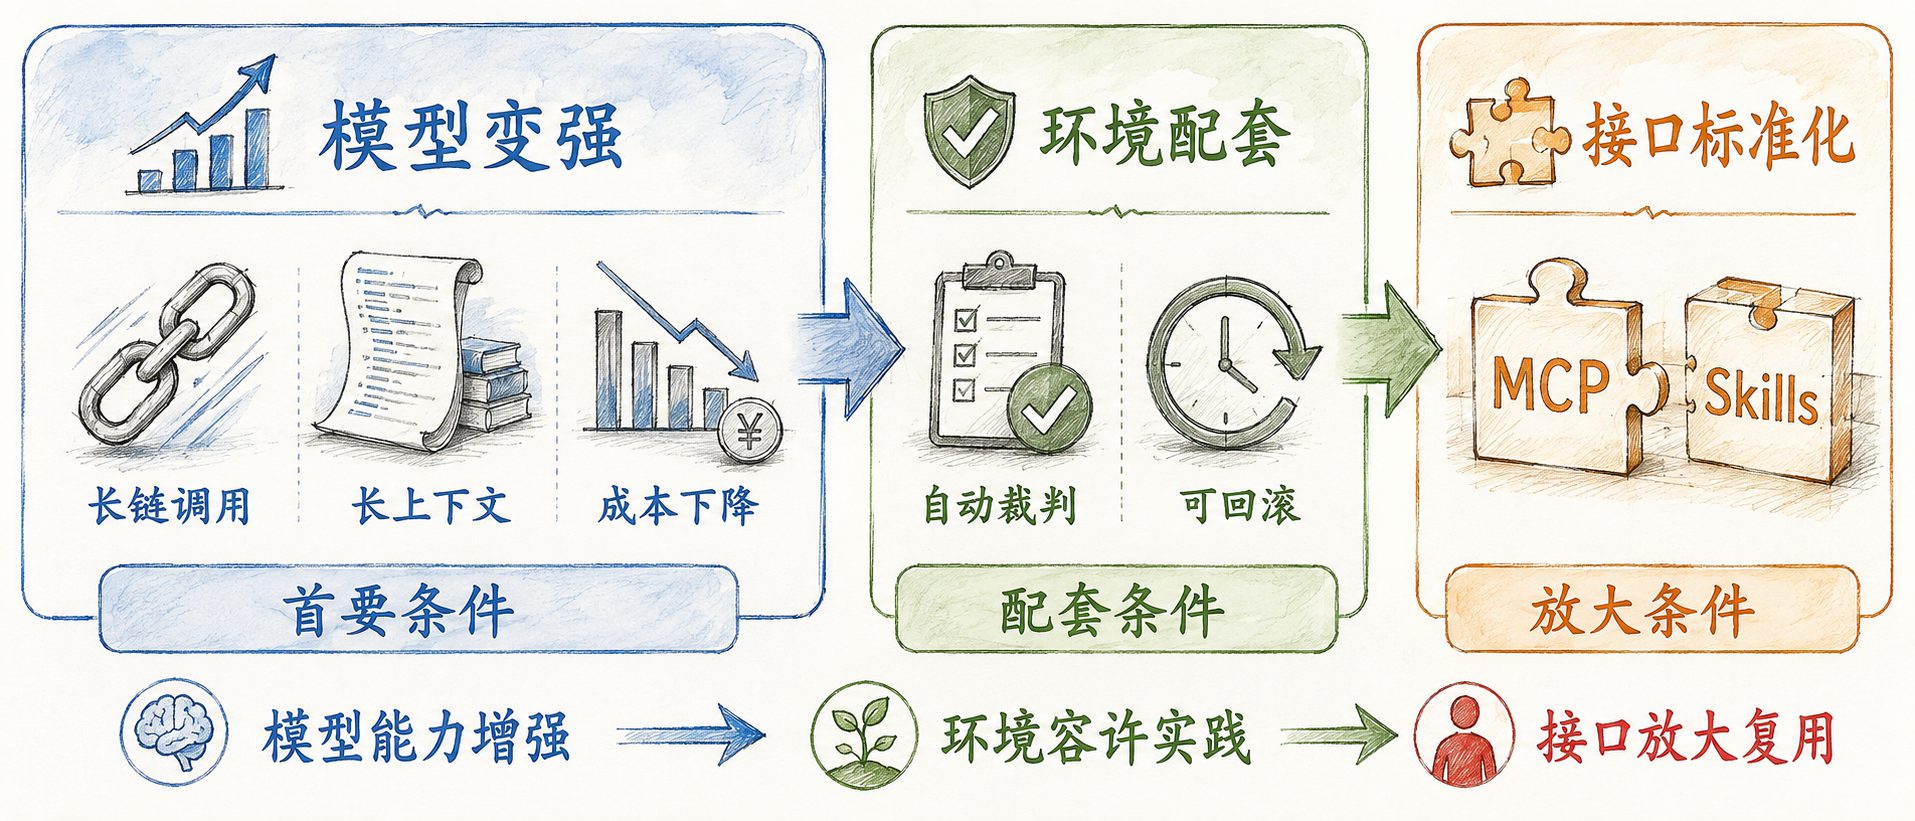
智能体接入外部工具与数据的统一接口
终端读写文件、运行命令的智能体,本课主要工具
把一套做法打包成文件,用到时才读取
网页聊天时代,到智能体时代
网页聊天时代
- 很聪明,但只有嘴
- 它说方法,人来执行
- 主要在问答窗口里工作
智能体时代
- 有手有脑,能交付文件
- 给一个目标,细节方法由它补全
- 从开发者的终端走向白领的桌面
这个领域,变化很快
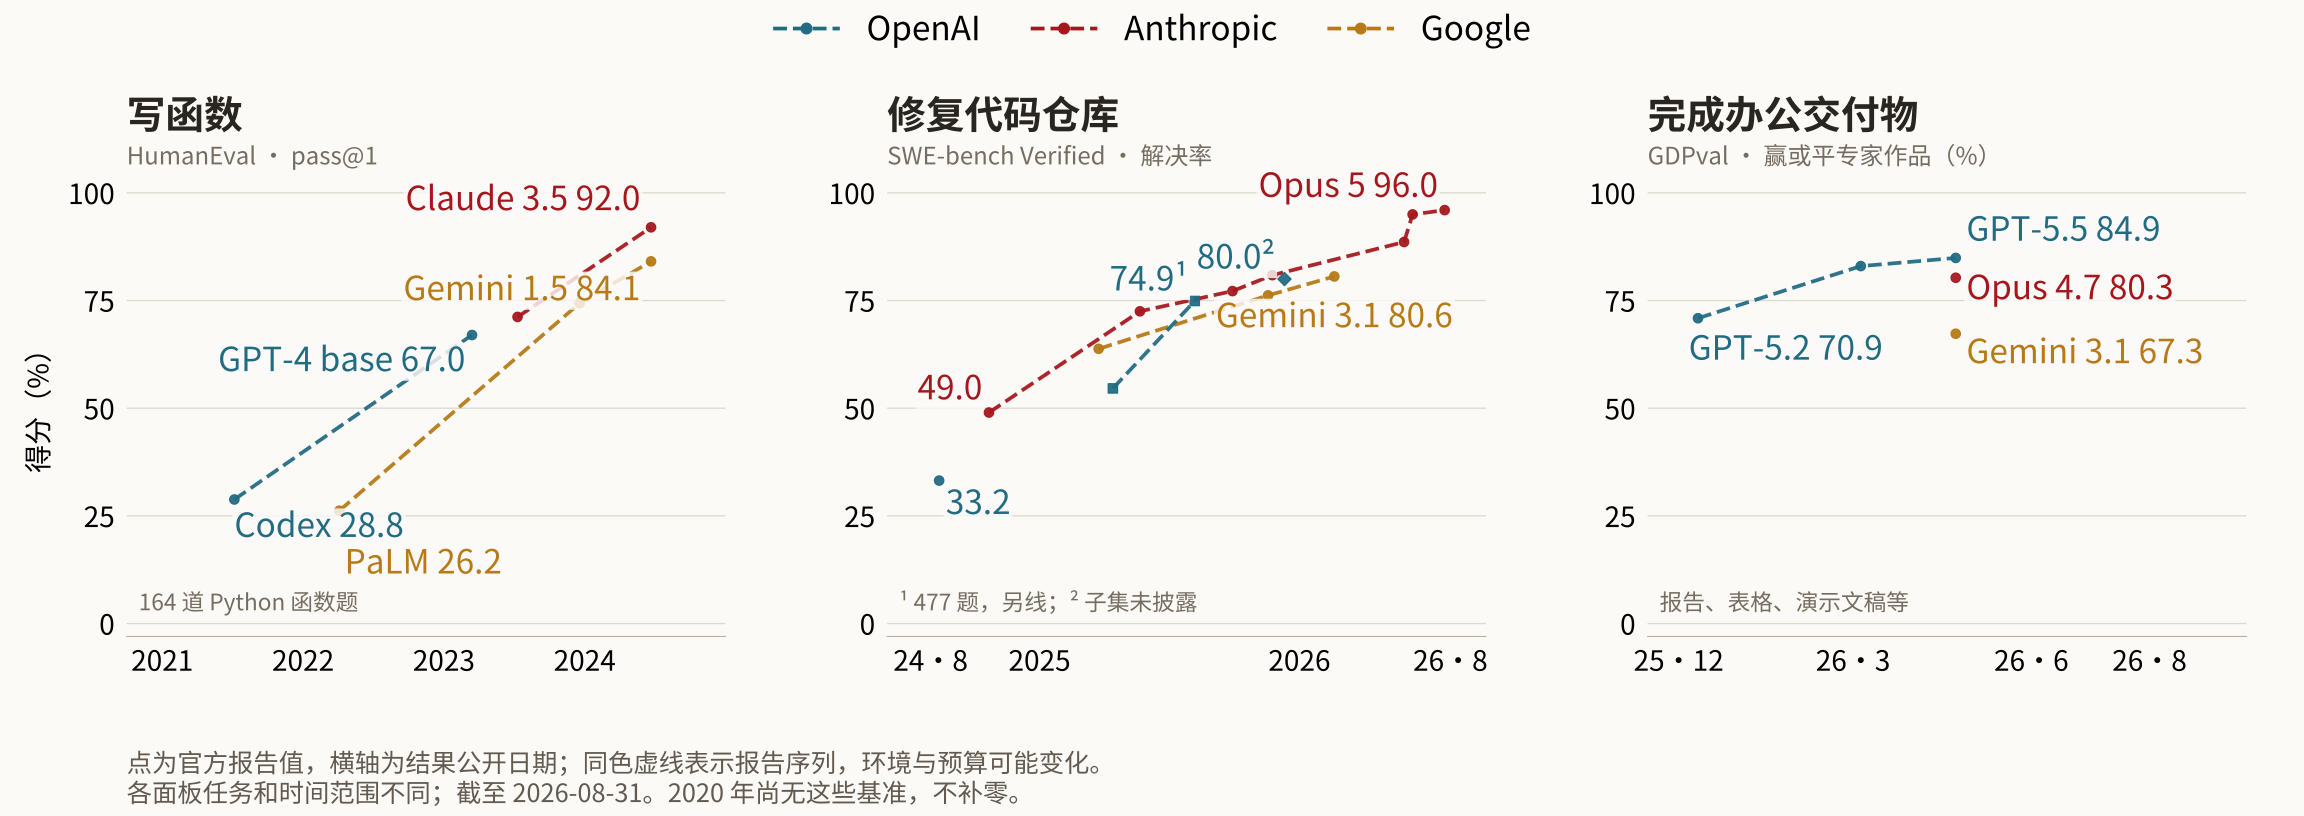
12 小时的任务,一半成功率
Claude Opus 4.6 的成功率为 50%
2019 年以来
2024 年以来
- 12 小时是任务跨度,不是智能体连续运行的时长;2023 年以来的倍增周期约 129 天
金融业,一直是 AI 的早期用户
| 时间 | 金融业中的应用 | 所属路线 |
|---|---|---|
| 1988 | 美国运通专家系统授权助手投产,辅助判断信用卡大额消费是否批准 | 规则 |
| 1988 | 文艺复兴科技设立大奖章基金,用数学模型从价格数据中寻找规律 | 学习 |
| 1989 | FICO 信用评分推出,用统计模型评估个人信用 | 学习 |
| 2009 | 高频交易一度占美股成交量一半以上(行业估计) | 算法与规则 |
| 2010s | 智能投顾兴起,Betterment 2010 年上线,Wealthfront 2011 年推出 | 算法与规则 |
| 2015 起 | 网商银行开业,小微贷款后来形成「310」模式:3 分钟申请、1 秒放款、0 人工干预 | 学习 |
大模型出现后,金融业如何应对
| 时间 | 金融业中的应用 | 阶段 |
|---|---|---|
| 2023 | 彭博发布 BloombergGPT,以金融语料训练的 500 亿参数模型 | 大模型 |
| 2024 | 摩根大通推出内部大模型助手 LLM Suite,8 个月开通 20 万员工 | 大模型 |
| 2025 | 工商银行、邮储银行、江苏银行等引入或本地部署 DeepSeek,约 20 家券商完成部署 | 大模型 |
| 2026 | 金融监管总局发文规范银行保险业 AI 应用,监管文件中首次专门提及金融智能体 | 监管跟进 |
回顾这段历史,三条规律
- 两条路线交替领先,螺旋上升 规则写不完,就从数据中学习;数据与算力到位,学习路线便再次领先。今天的智能体又把规则请了回来,写进记忆文档与技能
- 两次低谷,都是承诺超前于能力 当下的热度中同样有泡沫,一件事能否交给 AI,要看它在你的任务上实测的表现
- 任务越开放,验收越重要 下棋有裁判,写研报没有。判断对错的责任,在你
平台使用练习,交一份基本信息
登录
打开 hw.lingnan.top/mf,
用学号和姓名核对身份,
设置自己的密码
填写
待办里打开
第 1 次课 · 平台使用练习,
填本科学校、专业、编程基础
提交
点最下面的提交,
回「我的待办」
看到已交就算完成
晚上 19:00 见
装机验收三条全部通过 · 平台使用练习已交 · 课间问卷已填 · 素材包已解压
张一帆 · 中山大学岭南学院 · 金融AI智能体设计与应用