金融AI智能体设计与应用 · 第 3 次课 · 晚上
01 — 23
序 · 开场
中山大学岭南学院 · 张一帆
+
+
01序 · 开场
金融硕士选修课 · 第 3 次课 · 晚上 · 2026-09-30 · 东 2-304
AI与科学研究
原始数据与论文复现
Han et al.(2024) · Stata 复现与拓展
张一帆
中山大学岭南学院 · 金融 AI 智能体设计与应用
AI岭南学院
0今晚的目录
先看科研现场,再读论文、跑回归
| 顺序 | 主题 | 要做什么 |
|---|
| 序 | 先回到个人作业一 | 复现范围、平台三个文件位与提交前检查 |
| 第一部分 | 看科研现场
分三小节 | 一 三个真实产品与案例:Claude Science、玻尔、Coscientist
二 自动化走到哪一步:Project APE、刷量的后果、三档自主程度
三 研究者怎么用:Goldsmith-Pinkham 的三件工作 |
| 第二部分 | 读懂一篇论文 | Han et al.(2024):研究问题与数据、三个发现、脱钩指标与 Table 1 |
| 第三部分 | 跑一遍回归 | 三种 Stata 接法;我们的复现工作区;用作者数据跑出整张 Table 1 |
| 第四部分 | 核对与拓展 | 与论文逐格对照;把样本拆成前后两期并检验差异;当堂练习 |
| 收尾 | 回到作业一 | 把方法迁移到个人作业一,延伸阅读与答疑 |
含订阅数据的逐行记录只留在教师机;学员拿到的是论文原文、作者复现材料,和一个能让 AI 跑 Stata 的 skill。
0先回顾个人作业一
选一篇公开可取数的论文,至少核对三个维度
| 环节 | 具体要求 |
|---|
| 选文与取数 | 自选实证论文,先确认论文、数据和代码能合法取得;优先用公开数据 |
| 最低范围 | 核对样本与描述统计、核心结果,再核对一项稳健性或异质性结果 |
| 新增工作 | 完成最低范围后可做小拓展;补充公开数据或自己整理公开数据,按质量与可复现性加分 |
| 留痕 | 提交可重跑代码、运行说明、数据来源、原文对照与 AI 交互记录 |
| 截止 | 10 月 10 日 18:00,通过课程平台提交 |
复现是学习论文的入口。今晚用一张表做示范;你自己的作业还要检查样本与描述统计。
0现行提交接口怎么用
平台目前有三个文件位,交前逐项打开检查
| 文件位 | 放入什么 |
|---|
| 报告 PDF | 研究问题、数据与模型、原文对照、拓展解释;15 页是上限 |
| 展示页 zip | 现行表单要求所有人上传;展示页不超过 30 页 |
| 会话记录 zip | AI 交互记录;由于没有独立代码位,另放 do/py、README 和数据来源说明 |
提交前单文件不超过 50 MB。检查压缩包能打开,清掉密钥与他人个人信息;不能上传没有分发权的订阅数据。AI 错误只写实际发现的问题和核验过程,不凑数。
金融硕士作业平台现行个人作业一表单
I
PART I · 一 · 看科研现场
AI 在科研里
已经做到哪一步
三个真实产品与案例:从文献检索,到计算与审阅,再到接管实验设备
IAI for Science 的价值在哪里
AI 开始处理可交付、可检查的科研工作
01 · 找问题
检索与组织证据
跨论文、数据库和实验记录找线索,留下文献与数据的出处。
玻尔的科学导航面向这一环节。02 · 做分析
写代码、跑工具、改图表
把模型放进真实软件环境执行,保留代码、输入、输出和审阅意见。
Claude Science 将多种工具接成工作台。03 · 进实验
提出方案并接仪器
已有研究让语言模型调用检索、代码和自动化设备完成化学实验步骤。
实验安全与结果确认仍由研究团队负责。
对经济金融研究者,最直接的入口是第二步:让 AI 把论文规格写成可运行的代码,同时把核验责任留在研究者手里。
Anthropic, Claude Science, 2026-06-30;北京软件和信息服务业协会,玻尔发布稿,2025-04-01;Boiko et al., Nature, 2023
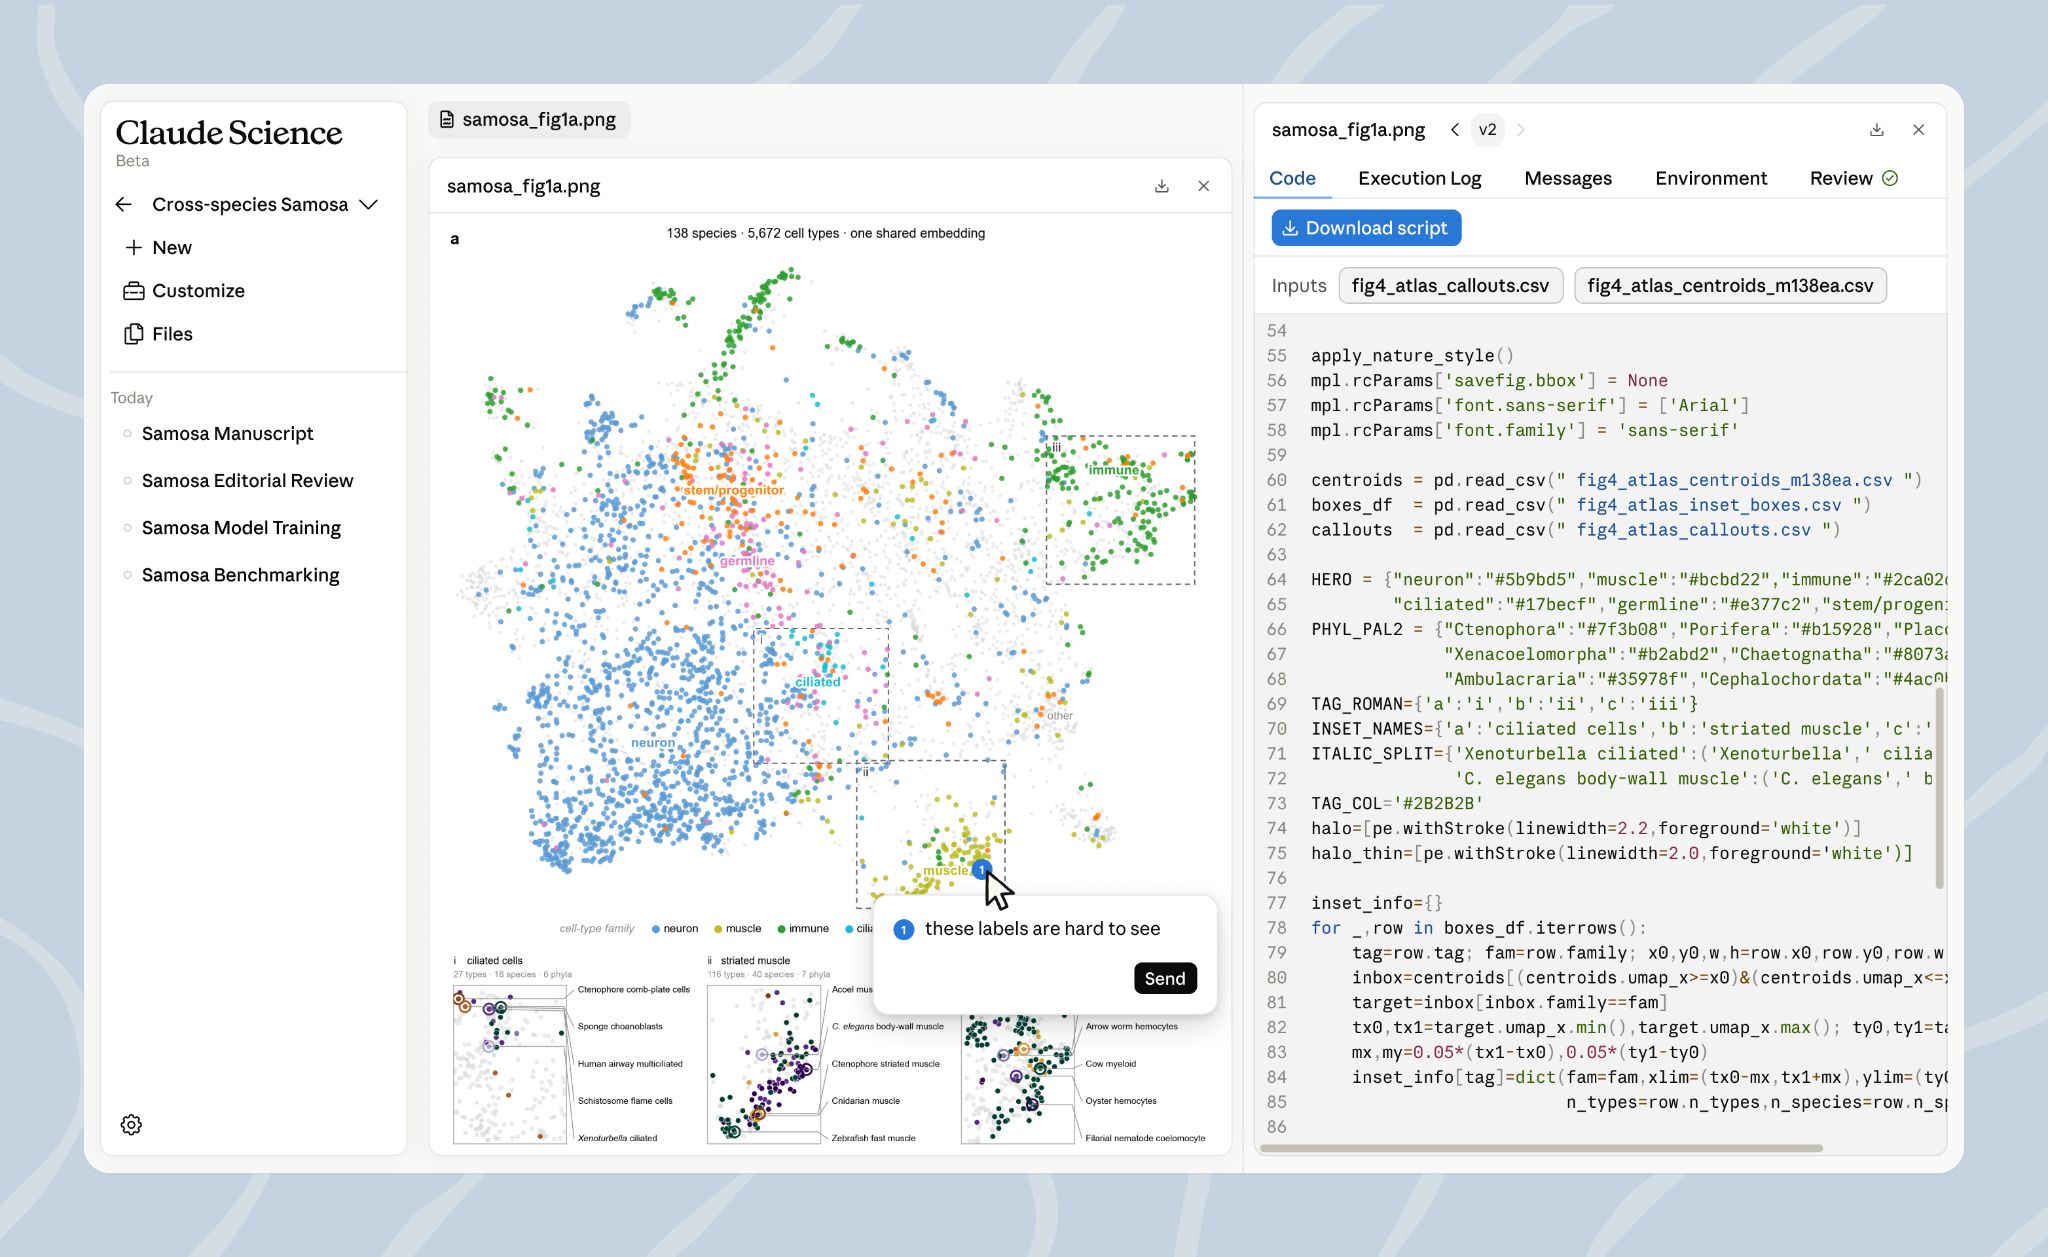
IClaude Science · 官方产品画面
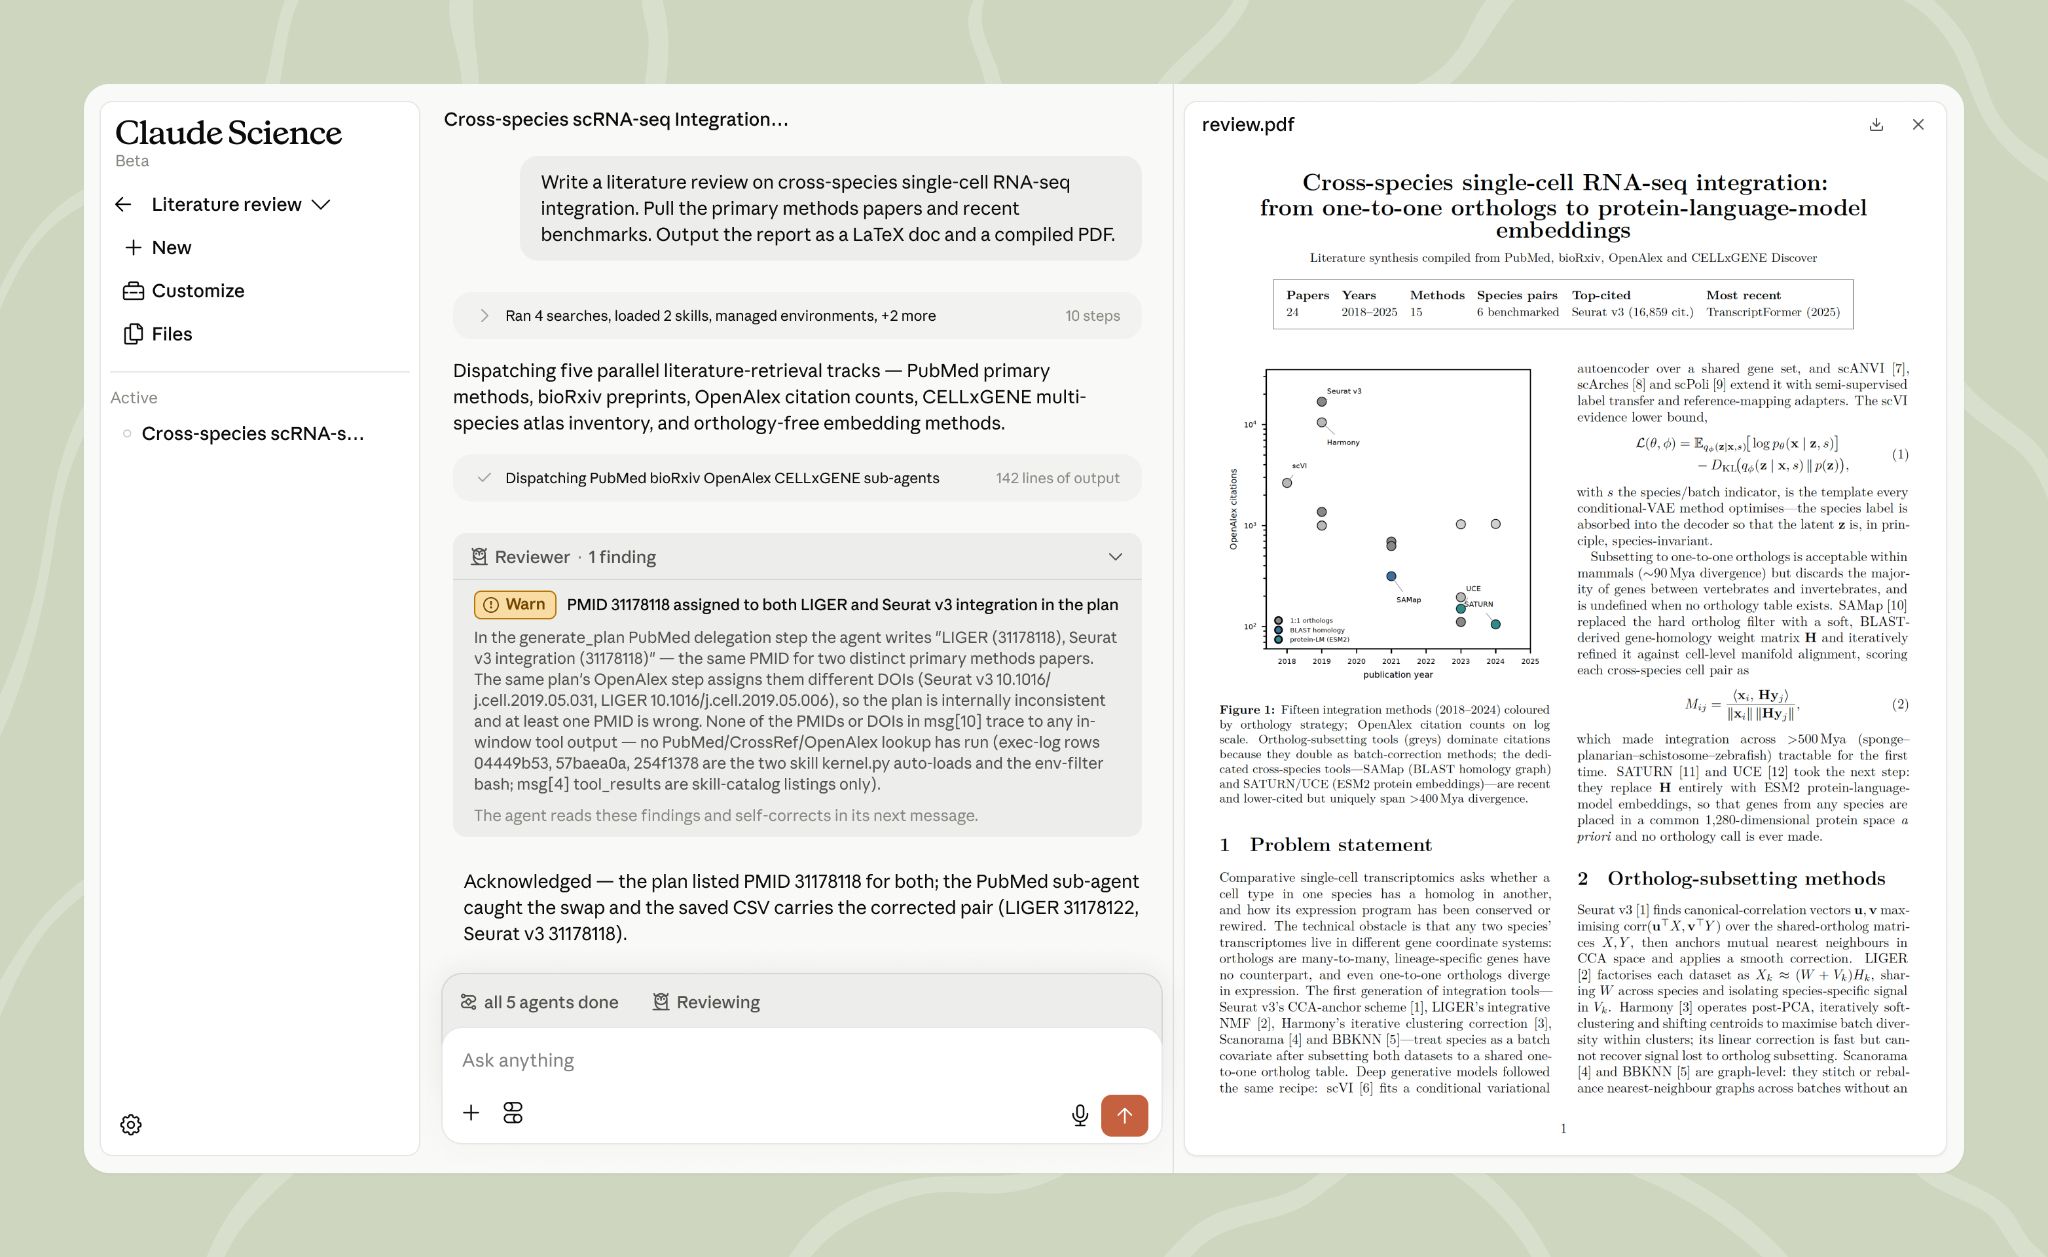
一张科研图,旁边就是代码、输入和审阅
![Claude Science 官方界面:图形、代码和审阅并排显示]()
这幅截图能说明什么
左侧是分析结果,右侧并排代码、执行记录、消息、环境和审阅页签。
另设一个审查智能体,核对引用与计算,挑出引错的文献和对不上代码的图。
每张图附复现包,含生成它的代码、运行环境与完整消息记录。
边界:公开测试版,是应用不是新模型,目前主推生命科学,面向 macOS 与 Linux。
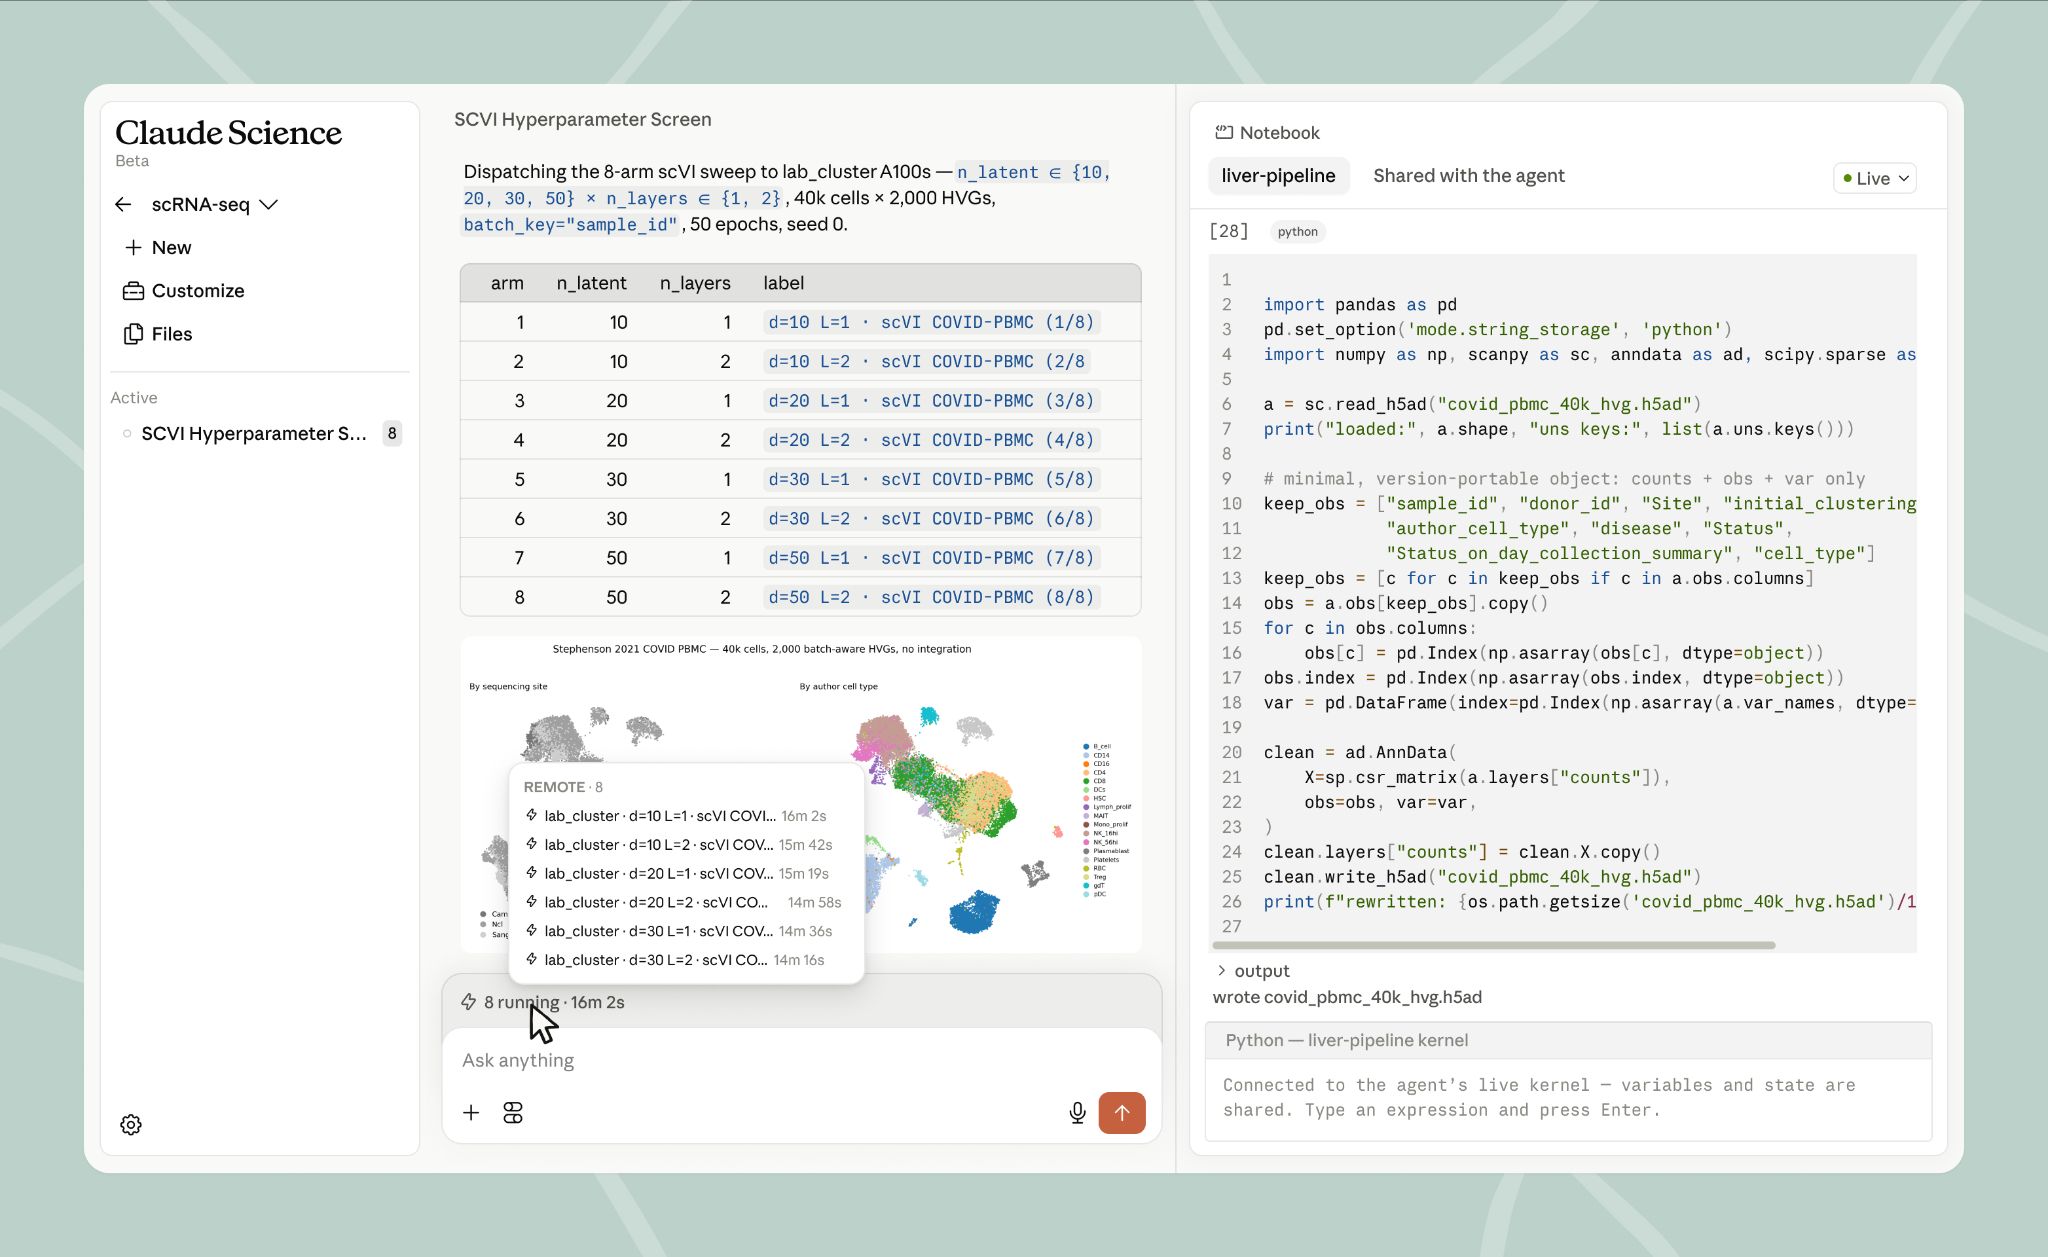
I从对话走到执行环境
数据、计算和图表接在同一个任务里
官方发布的产品范围
测试版预置六十多个面向科研的技能和连接器,覆盖基因组学、单细胞分析、蛋白组与化学信息学,首批重点在生命科学。
它可以调用计算环境,读文件、写脚本、生成图表并保留运行材料;也能通过 SSH 连到实验室自己的集群,访问新资源前会先征求用户同意。
经济学课堂的启发:我们也要把文献、数据、Stata 脚本和对照表放在同一条可复查的链上。
![Claude Science 官方计算环境产品画面]()
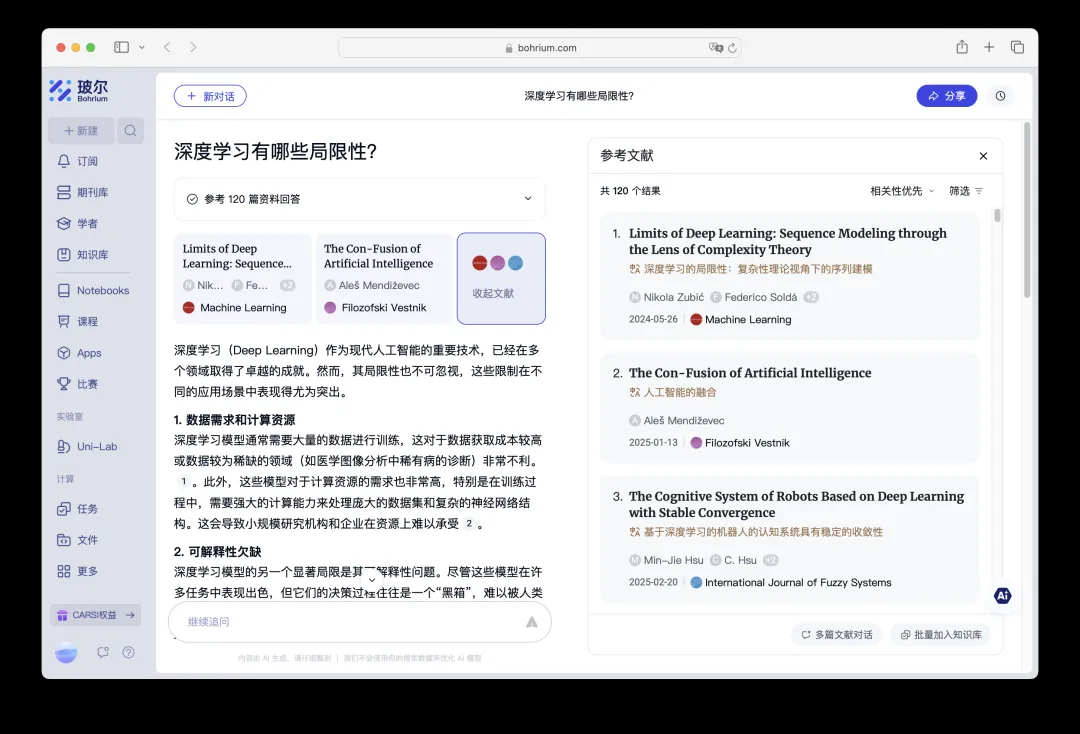
I国内产品进展 · 玻尔
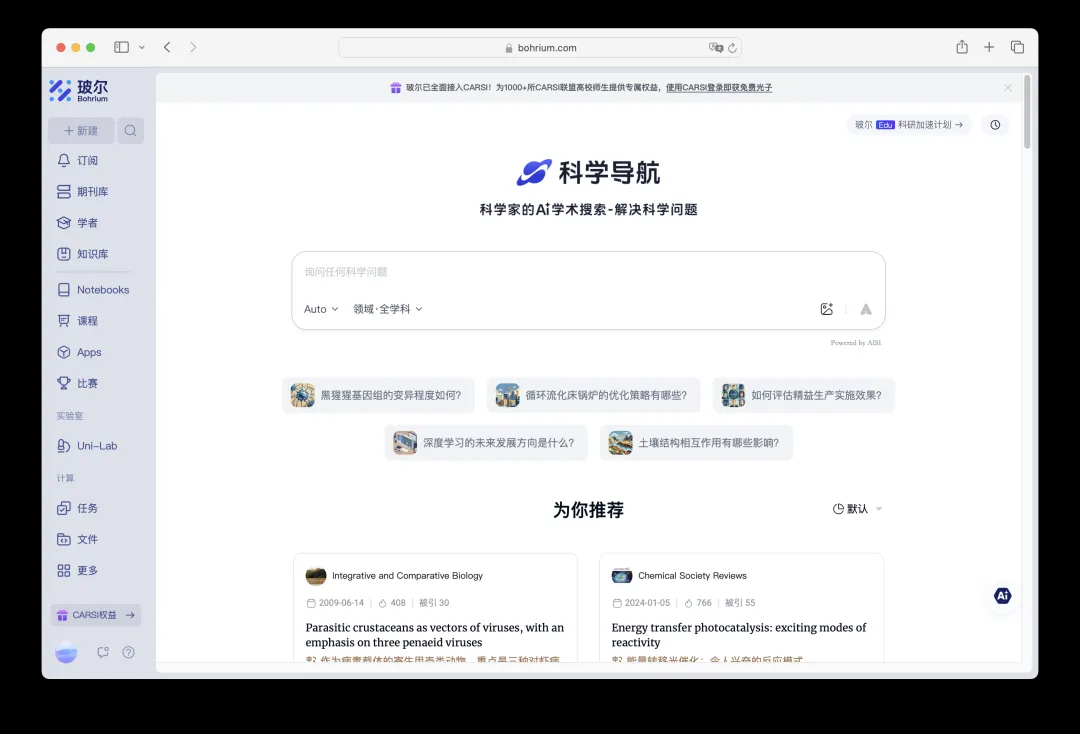
玻尔:一个能直接用的文献检索入口
![玻尔科研空间站的科学导航回答界面]()
它是什么,能做什么
是什么。深势科技与北京科学智能研究院 2025 年 3 月发布的新版玻尔科研空间站,核心是「科学导航」:输入或选择一个科学问题,它解析问题意图、匹配相关成果、生成答案,并能一键跳到原始文献;整站覆盖读文献、做计算、做实验三段。
对我们最有用的部分。找文献与追踪进展:支持自然语言、图表与化学结构检索,可按关键词、期刊、学者订阅最新文章。
入口。bohrium.com,已接入 CARSI,用校园网身份就能登录。
边界。界面证明的是检索与整理能力,不等于 AI 完成了实验;答案旁的文献列表也不保证每句话都被准确支持,引用前要点开原文。
I2026 年的研究案例
AI 参与发现,湿实验由人完成
![Anthropic 酶系统报道的实验画面]()
ART 逆转录酶系统
Anthropic 报告称,约 950 个智能体并行跑了 21 小时,从二十多万条逆转录酶里收敛到约二十个候选。
研究者随后做实验验证;实验室工作由人完成。
边界:这套系统的功能未知;没有证据表明它像 CRISPR 那样工作;预印本尚未同行评议,另外十次搜索都没再找到那段阵列。
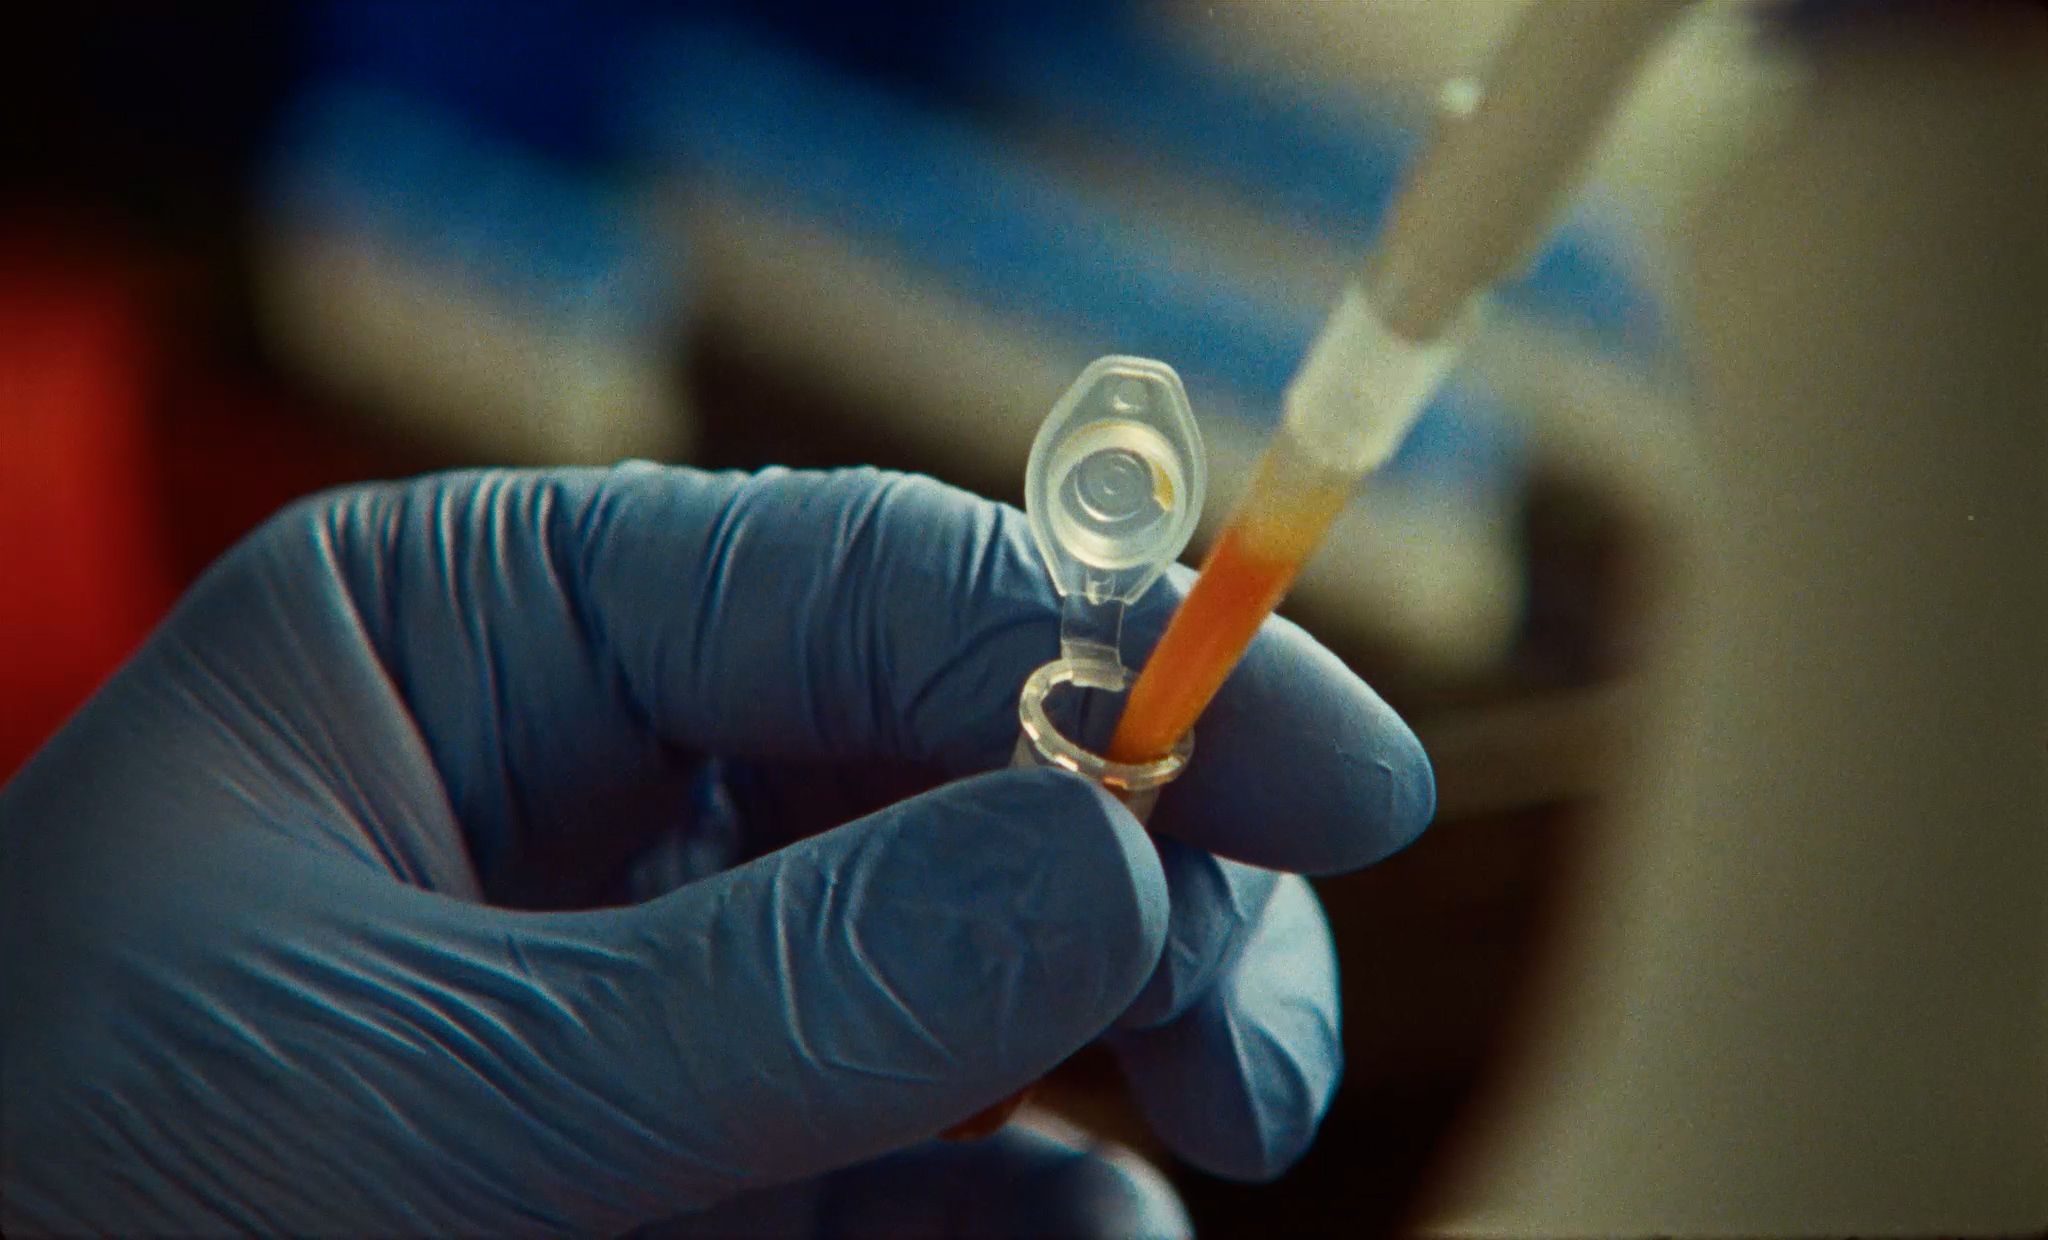
I真实实验 · 视频素材
AI 能接入实验设备,看 Coscientist 的现场
Boiko et al.(2023)Coscientist 把语言模型、科学检索、代码和自动化仪器连起来,在研究团队的环境中规划并执行化学反应步骤。
边界很清楚:设备在预设条件下执行步骤,实验板仍由人手动搬运,安全与结论由研究团队负责。
播放左侧视频,观察自然语言任务如何进入实验流程,以及哪些步骤仍由人核对。
I三年里发生了什么
从实验自动化到科研工作台
![Coscientist 化学实验照片]()
2023 · Coscientist语言模型调用实验工具,完成化学实验步骤。
![玻尔科学导航产品界面]()
2025 · 玻尔科研空间站加入科学导航。
![Claude Science 科研工具画面]()
2026 · Claude Science技能、连接器与计算环境集中到一处。
这些例子来自不同学科、不同成熟度:Coscientist 有同行评议论文,玻尔和 Claude Science 只有公司发布稿,能说明的东西不一样。共同变化是 AI 的工作从给建议,延伸到调用工具、产出可检查的文件。
Boiko et al., Nature, 2023;深势科技,2025;Anthropic,2026
I
PART I · 二 · 自动化走到哪一步
有人把整条实证流程
交给了系统
它跑到多大规模、怎么给自己排名与查错,以及一个人用 AI 刷量之后的后果
I经济金融领域的自动化尝试
Project APE 把实证研究跑成流水线
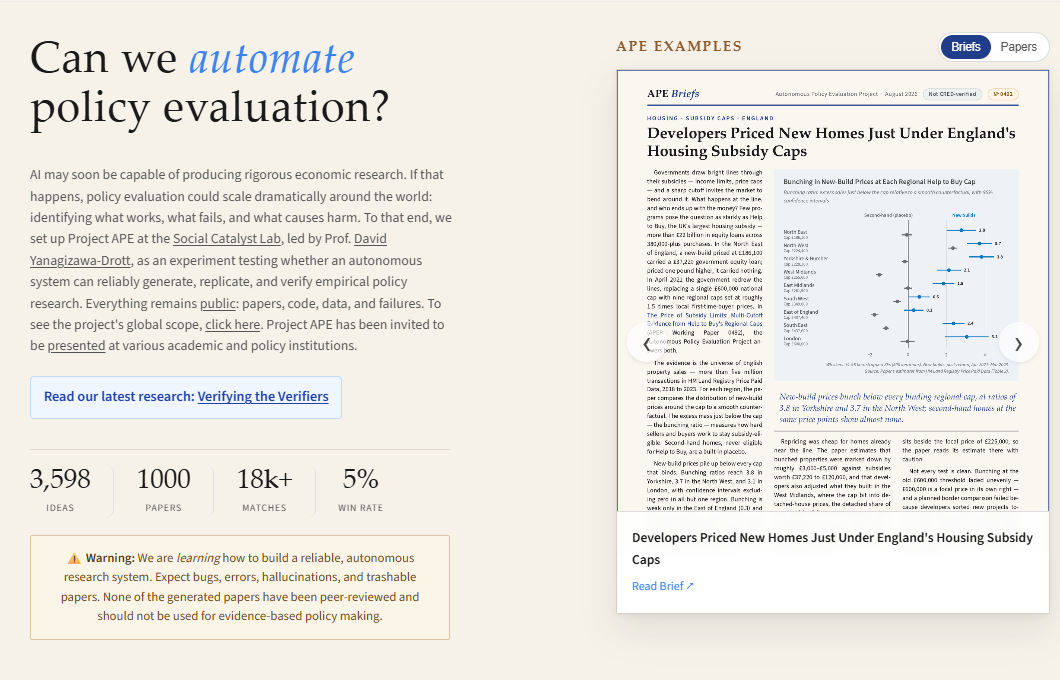
![Project APE 站点首页:项目自述、四个统计数字与官方警告]()
这个项目是什么
苏黎世大学 Social Catalyst Lab 的实验项目,由 David Yanagizawa-Drott 主持。
用公开数据写原创实证论文:自己找问题、取数、选识别策略、写 R 脚本并成文。
截图上的四个数字:3,598 个选题、1,000 篇论文、18,000 多场比较、对人类论文胜率 5%。
官方自己写着:会有错误、幻觉和该扔掉的论文,未经同行评议,不能作为政策依据。
I自动跑出来的论文怎么评
先排名次,再查错
名次怎么排
每篇 AI 论文与一篇即将发表于顶刊的人类论文配对,由模型读完两篇,判断哪一篇更好。每天比对 50 对。
担任评委的模型不是生成论文的那一家,避免自我偏好。每对交换顺序评两次,两次都赢才算赢;名次按累计胜场排定,单场胜负不改变位次。
评委看不到什么
评委只看到论文本身,拿不到代码和数据。它能判断文章读起来是否像一篇好论文,不能判断结果是否正确。
项目自己声明,这个名次是有噪声、可能有偏的信号,不是同行评议。两类论文用同一套分数衡量,人类顶刊论文整体排在 AI 论文之上。
另一项工作是查错。项目把实证研究里常见的缺陷整理成一份分类清单,让模型照清单审查论文;为检验查得准不准,先把已知错误注入 100 篇论文,看它能找出多少。在另一批未经改动的论文中,人工复核认为模型报出的问题 97% 属实,据此估计每篇论文都存在错误或缺陷,其中一些属于严重级别。
I同一件事的另一面
一个人九个月两百多篇,论文被平台下架
| 环节 | 发生了什么 |
|---|
| 谁 | 芝加哥大学布斯商学院计量经济学与统计学教授 Nicholas Polson,终身教职 |
| 产出 | 2026 年到 8 月底,署名他的预印本账号上传 258 篇工作论文,其中 8 月一个月 104 篇;多数是二三十页以上的长文 |
| 怎么被发现 | 8 月 18 日 UCLA 的 Auyon Siddiq 发帖指出异常,经济学家 Jeremy Horpedahl 逐篇统计确认;随后这批论文从 SSRN 下架 |
| 作者怎么说 | 主要合作者 Vadim Sokolov 承认用了 AI,但否认「一句提示生成三十页」;他同时承认,AI 的参与程度没有在论文里一致披露 |
两种解释:Gelman 读的那篇 80 页论文横跨多个学科却价值不大;Makowsky 称之为「知识圈地」——用 AI 把想法迅速铺成论文,抢占「我先想到」的记录。与 Project APE 对照,一个是系统自己写,一个是人用 AI 放大产出,共同点是量大之后验证成为瓶颈。
科学网(中国科学报社)报道,2026-09-29;原始讨论见 Andrew Gelman 的博客 Statistical Modeling, Causal Inference, and Social Science,2026-08-27
I前面这些例子,各站在哪一档
判断留在谁手里,分三档
第一档 · 副驾驶
它干一段,人做每个决定
写代码、取数、画图交给它,问题怎么问、口径怎么定、结论成不成立由人判断。
今晚的 Stata 复现;Goldsmith-Pinkham 的两件工作。第二档 · 交出一段活
整段交给它,人在两头把关
一次计算、一次实验、一版初稿可以由它跑完,交付之前与之后由人核对。
Claude Science 的工作台;Coscientist 按一句提示做完两个反应。第三档 · 全自主
选题、取数、成文都由它做
人退到系统设计的位置,只在事后抽查结果。
Project APE 已经做到这一档;下一页还有一家公司想接着往下做。
这三档不是高低排序,区别在于判断留在谁手里。越往上,越依赖能自动查错的办法,这也是 Project APE 第一步先做验证器的原因。这学期要练熟的是前两档。
本页为课程归纳
I2026 年 8 月的新动向
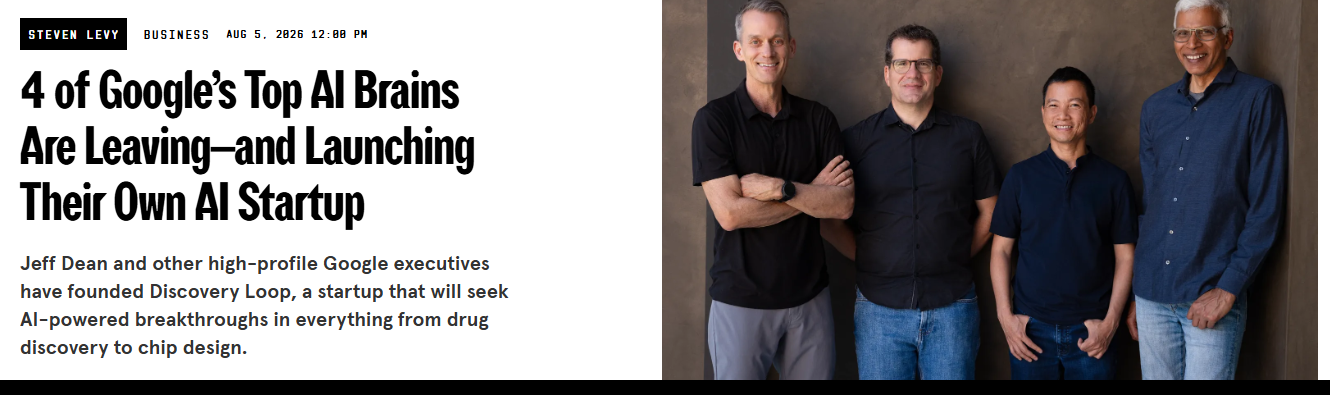
谷歌几位核心人物下场做这件事
![WIRED 报道截图:四位创始人合影与标题]()
2026 年 8 月 5 日
Jeff Dean 在谷歌近 27 年后离开,与 Sanjay Ghemawat、Oriol Vinyals、Quoc Le 创办 Discovery Loop(公益公司,Dean 任 CEO)。Alphabet 是创始投资人兼云服务方。
要做的正是上一档那件事:把科学方法本身自动化——提出实验、搭好条件、执行、评估,再跑上千遍;路线是先改进自己的模型,再扩到芯片设计、生物学、药物发现与材料。
投资人的说法:过去是人用 AI 做研究,现在要让 AI 当研究者。
Steven Levy, “4 of Google’s Top AI Brains Are Leaving—and Launching Their Own AI Startup,” WIRED, 2026-08-05
I
PART I · 三 · 研究者怎么用
回到你手上
这一档
一个实证研究者的真实做法:从取数与画图,到把年报做成可查询的数据库
I经济金融领域的公开实践
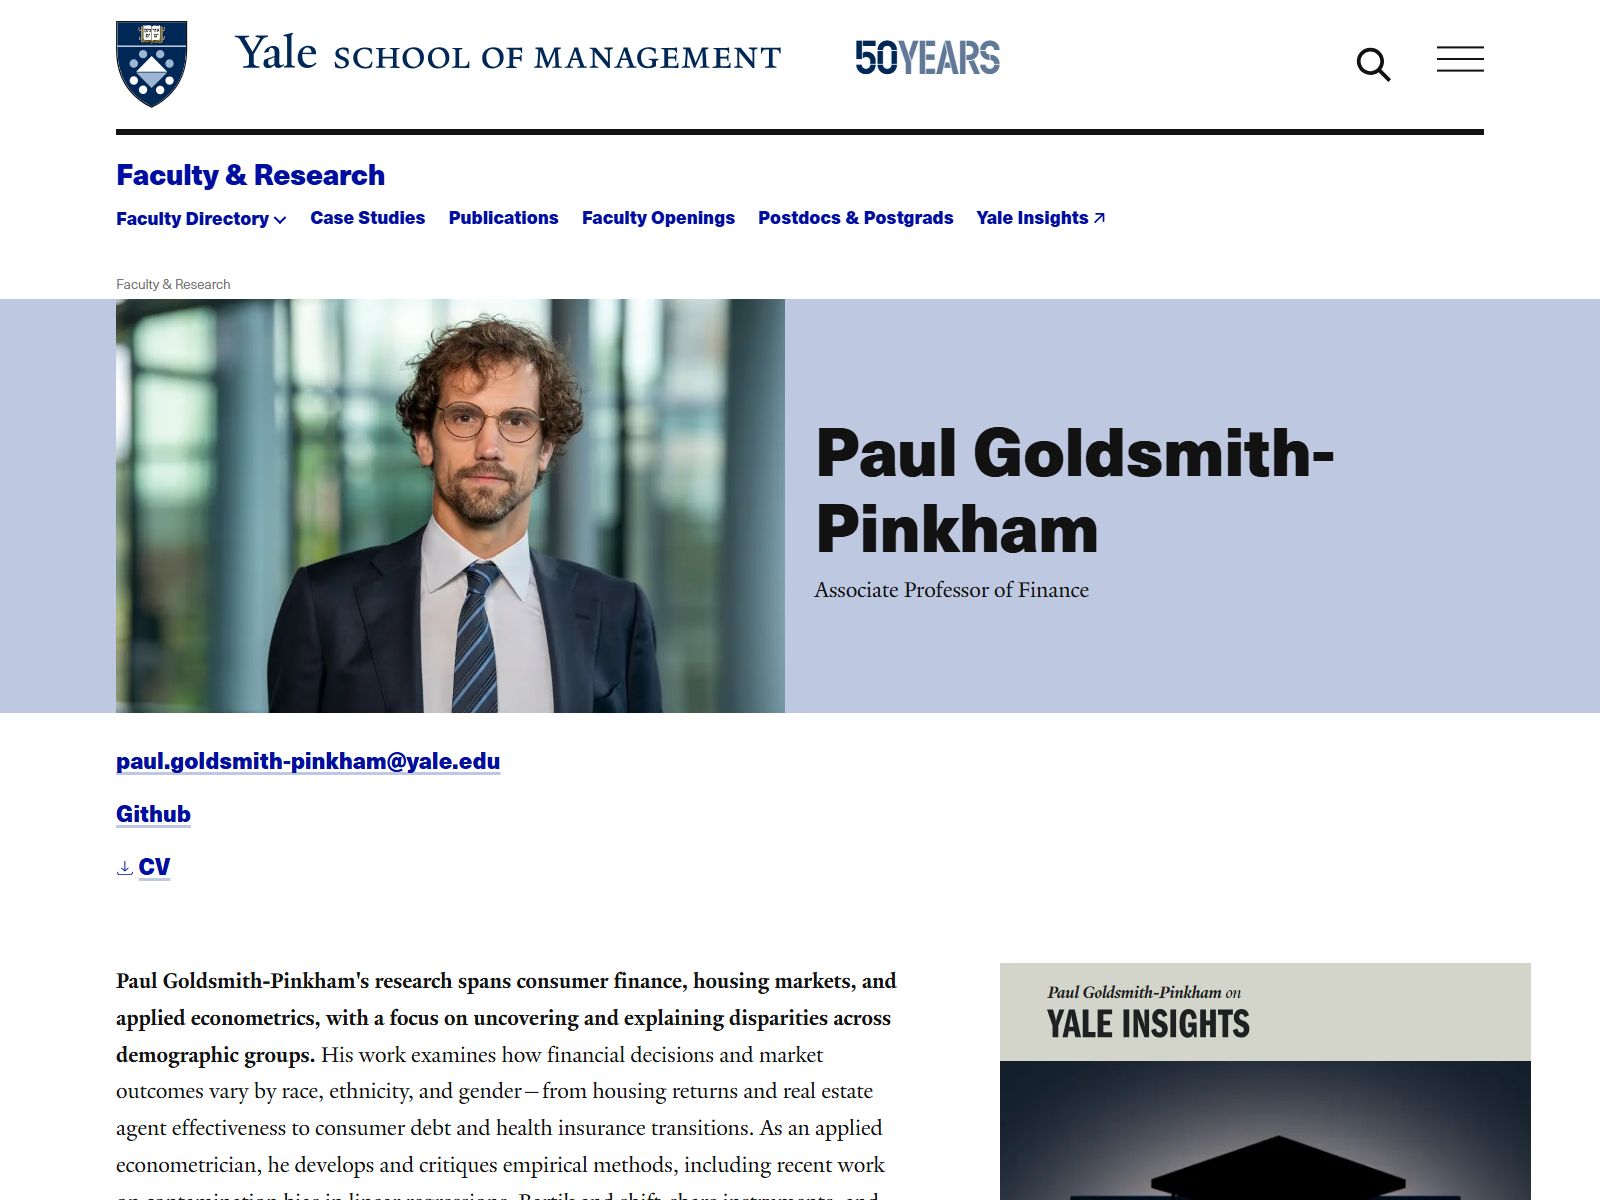
Paul Goldsmith-Pinkham 把工具分成五级
![Paul Goldsmith-Pinkham 耶鲁管理学院官方教师页面截图]()
他把工具分成五级
- 0–1 级 浏览器里复制粘贴,或用编辑器内联补全
- 2 级 Cursor 这类智能体编辑器
- 3 级 终端里的 Claude Code 与 Codex CLI
- 4 级 接上 MCP,连数据库与 API
- 5 级 放进容器,无人看管跑一阵
他停在第 3 级:能读写文件、执行脚本、按报错自我调试,像一个住在电脑里的 RA。但 RA 交来的代码要验,它交来的结果也要验。
I他真做过的第一件工作
一件描述性工作,6 分 21 秒跑完
| 环节 | 发生了什么 |
|---|
| 问题 | 过去 50 年,美国住房自有率随年龄的分布怎么变;这是他本人研究的题目,与他和 Kelly Shue 关于住房回报的论文相关 |
| 起点与过程 | 只说清要什么数据,不说它在哪张表里;先试 FRED 卡在系列编号,普查局返回 403,它自己补上 user-agent 才下载成功 |
| 产出 | 找到两张普查表,按季度的一张从 1994 年起,按更细年龄组的一张从 1982 年起;解析多数据块与合并单元格后落成两个 CSV |
| 画图与结论 | 只给一句「照 Kieran Healy 的《Data Visualization》做」,它译成直接标注、少装饰与配色,写了 77 行 R,年份标签重叠也自己修好;2004 年住房自有率最高,2024 年与危机后时期相似 |
判断仍在人手上:呈现哪些年龄组、跟哪一年比、这张图要讲什么,都是研究者定的。
I他真做过的第二件工作
从 120 份年报,搭出一个能查询的库
| 环节 | 发生了什么 |
|---|
| 问题 | 2025 年关税升级后,上市公司在 10-K 风险因素(Item 1A)里的关税表述有没有变化 |
| 前置与反问 | 先把 CIK、EDGAR 接口、每秒 10 次的限速与 User-Agent 要求讲清楚;它自己进入计划模式,反过来问数据库格式(选 DuckDB)、关键词策略和 User-Agent 用谁的身份 |
| 过程 | 480 行 Python;约 30 家公司 120 份 10-K;抽取从 112 份修到 119 份,剩下 1 份格式特殊,要人工处理 |
| 发现 | 2010 年 18 家公司共 25 段提到关税,2022–2025 年每家每年 26 到 35 段;词汇从 anti-dumping、countervailing duties 扩到 trade war、liberation day |
交付物是那个可查询的数据库,不是抓下来的 HTML;加关键词、接其他数据、交给合作者,都不必重跑爬虫。全程约 30 分钟,作者说这是描述性事实,不是因果结果。
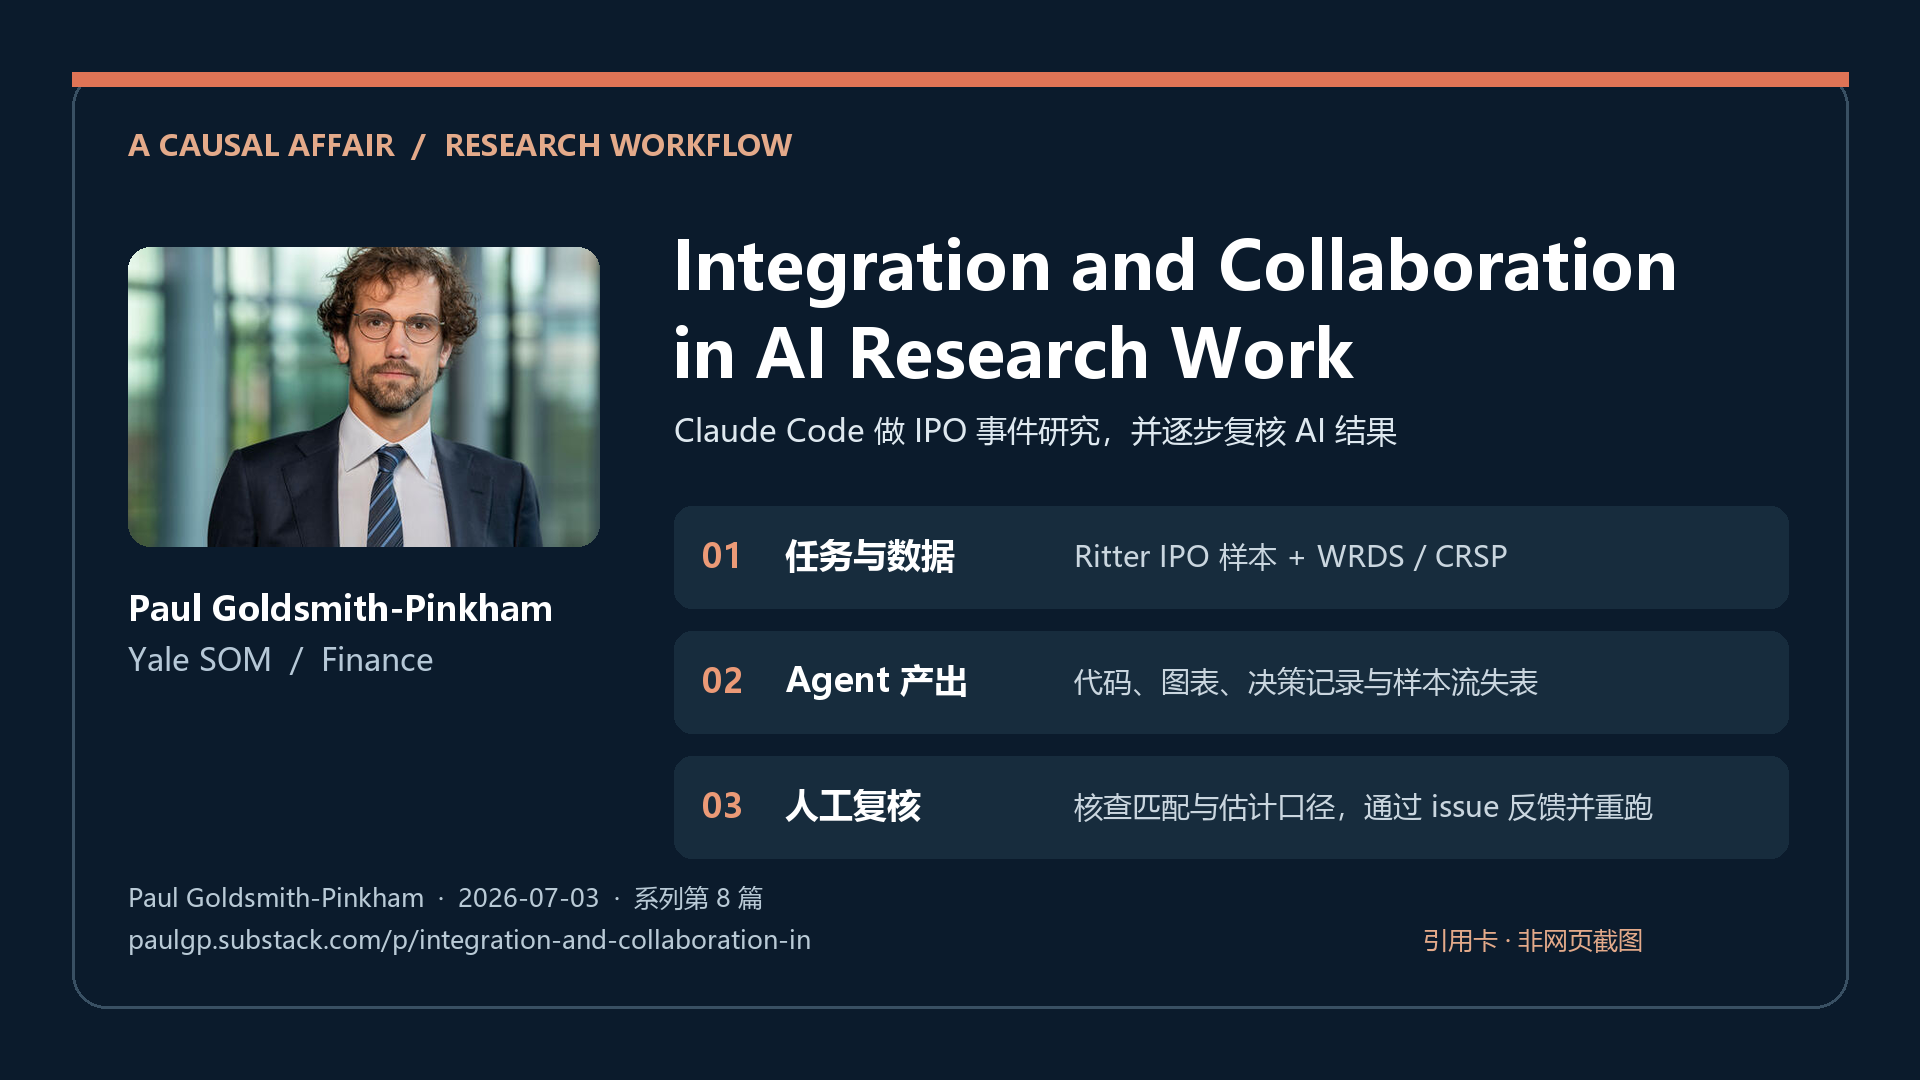
ISubstack · 一次具体的实证任务
25 分钟拿到初稿,接下来逐项核查
![Goldsmith-Pinkham Substack IPO 实证案例引用卡,非网页截图]()
IPO 长期表现案例
让 Claude Code 接入 IPO 与 CRSP 回报数据,生成脚本、表和初步解释。
随后检查频率、首日回报口径、代码和每个结果的来源,发现月度数据不能直接核对首日收益。
可迁移的习惯:把“完成速度”和“数值可信”分开检查。
I回到我们自己的研究
复现让你真正读懂论文
READ
把文字写成规格
样本怎么选、变量怎么构造、模型放了什么固定效应,都要从论文和代码里找出来。
CHECK
把每个数字对上
先对样本量,再对系数和标准误;差异出现时,回查数据、变量和估计命令。
EXTEND
在可靠起点上练习
基准表跑通后,才知道改样本期或模型设定究竟改变了什么。
AI 可以帮忙写代码和查错;论文读没读懂、结果能不能相信,最终还是由研究者判断。
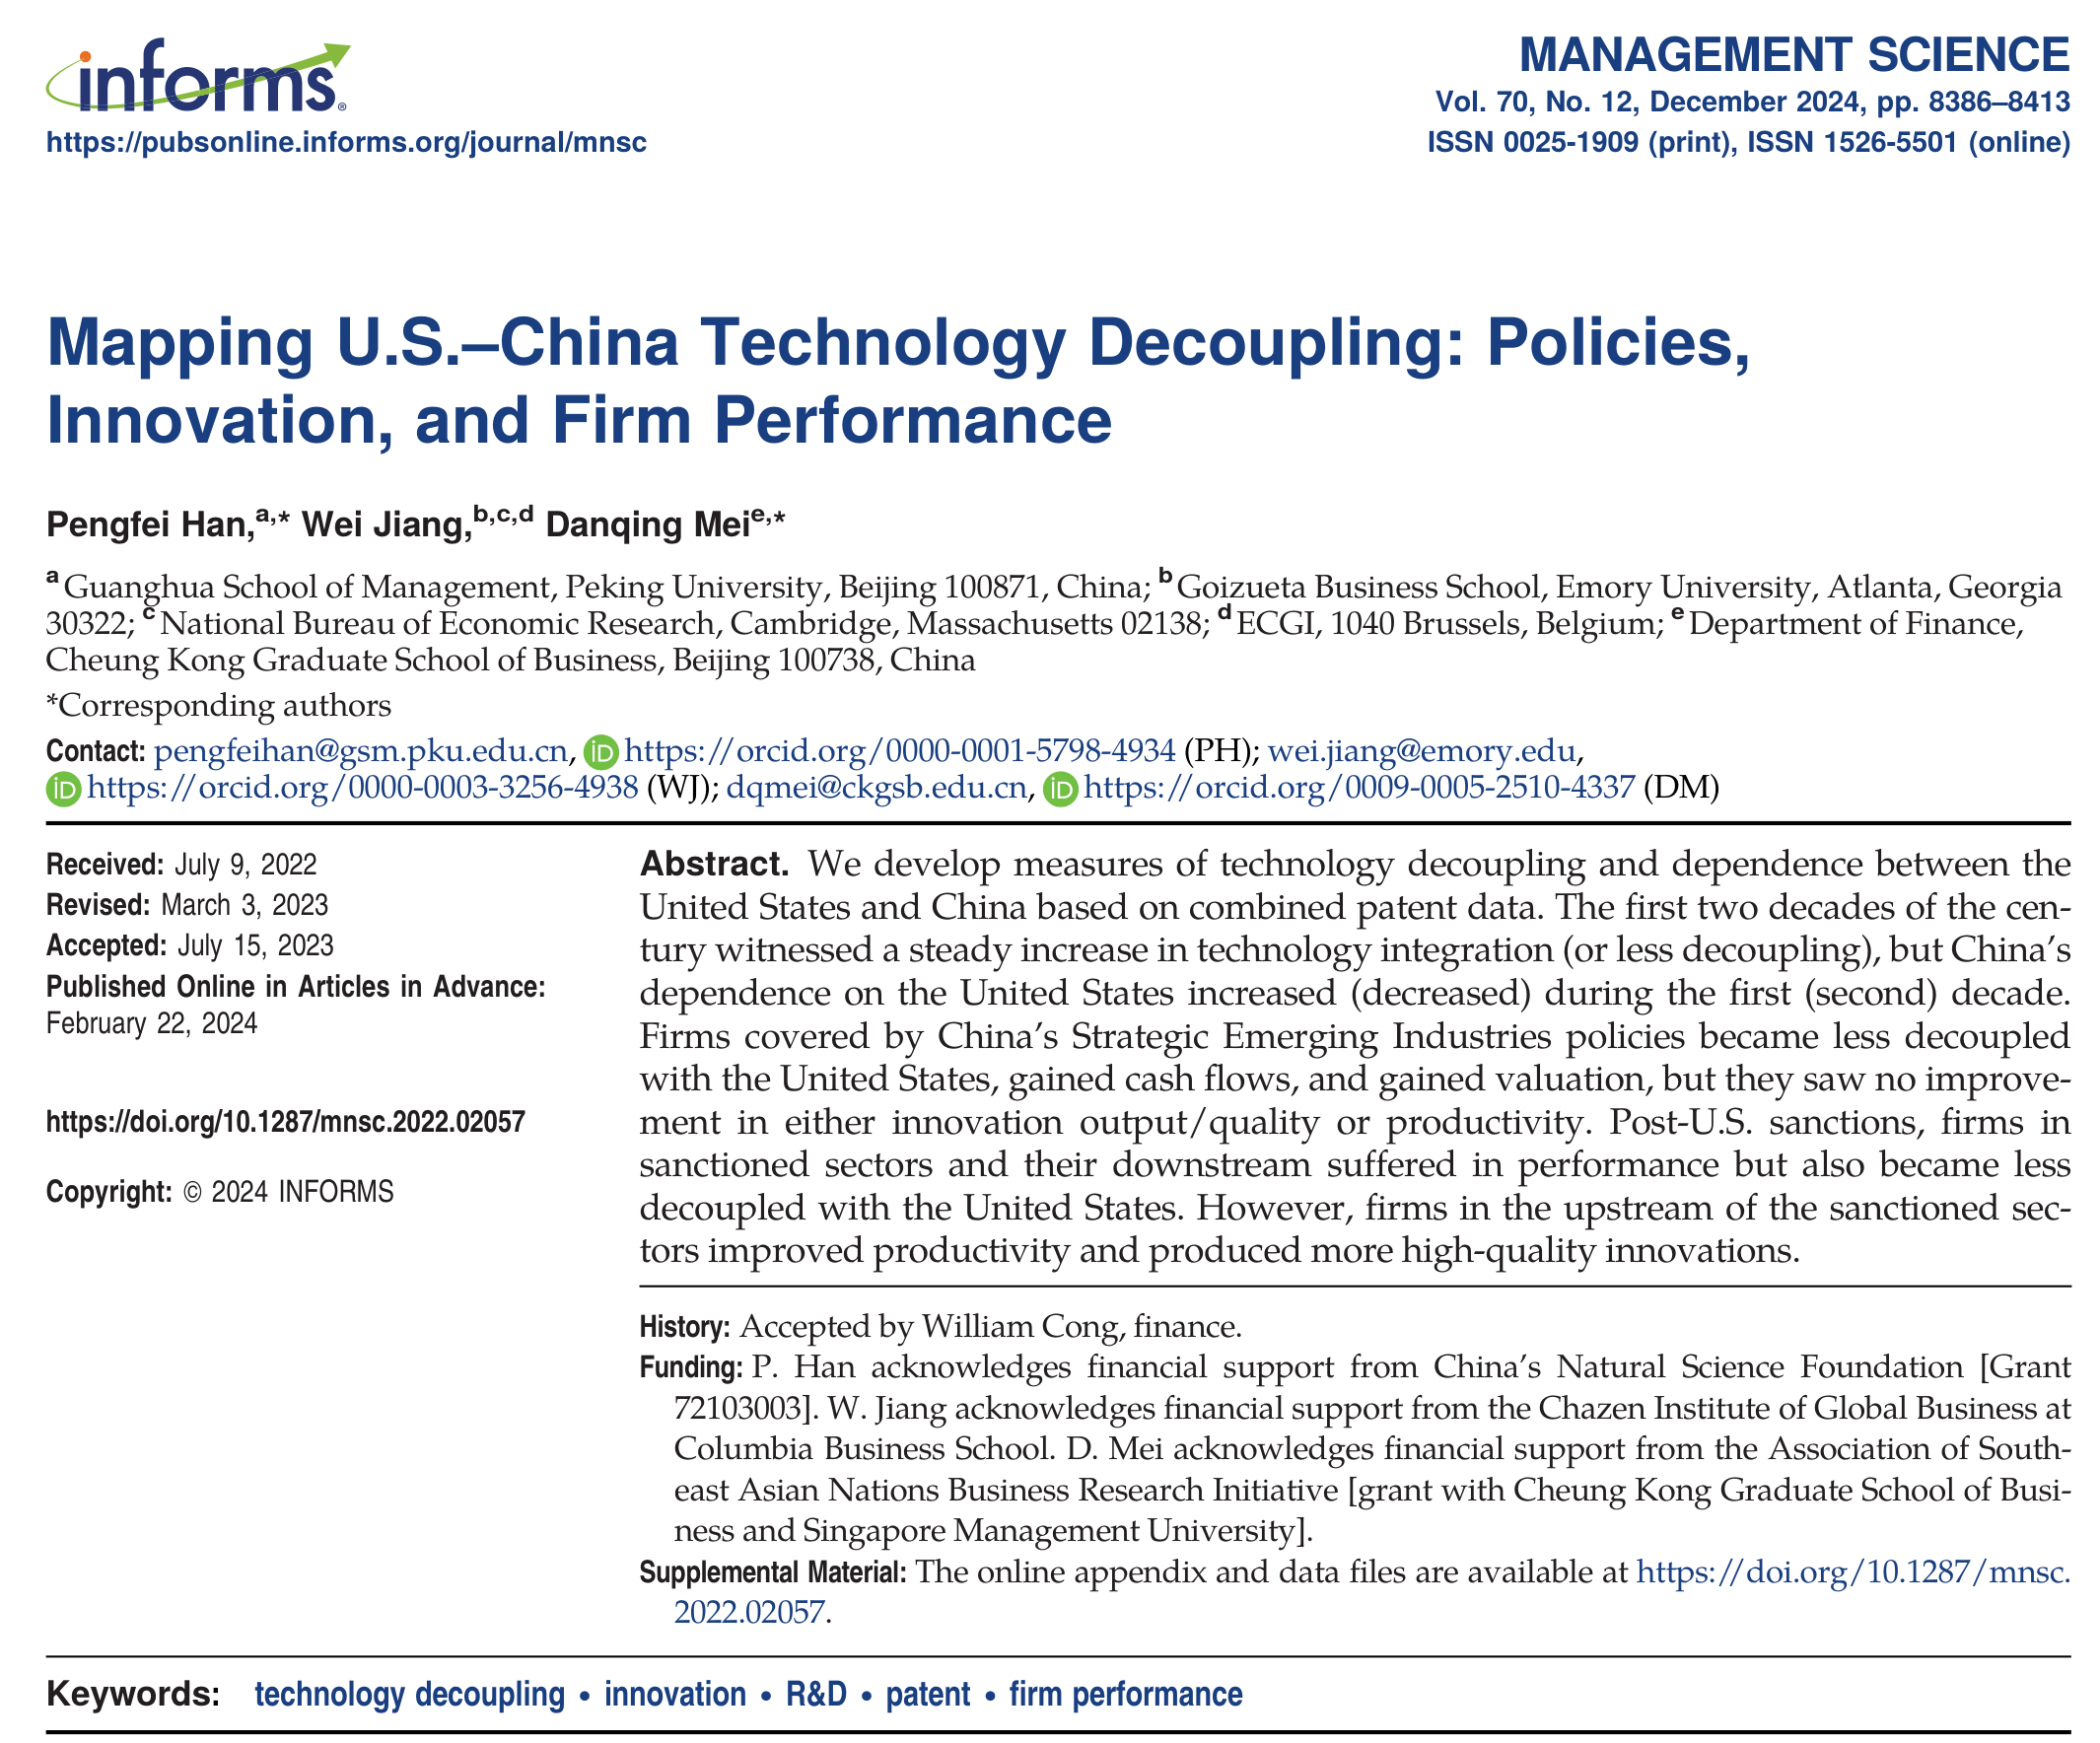
II这篇文章做了什么
Han et al.(2024):先量技术联系,再看企业
![Han et al.(2024)论文首页]()
研究问题
中美的技术联系有多紧密,两国政策让这种联系发生了什么变化,又怎样影响企业的创新与经营?
数据两条线。专利取自美国专利商标局与中国国家知识产权局的授权库,按专利之间的引用关系配对;企业取自 2007–2019 年两国上市公司财务数据,剔除金融业。
做法两步走。先用专利互引量出「脱钩」与「依赖」两个指标,再把指标接到企业年度面板上做回归。
II论文的核心发现
脱钩在降,依赖先升后降,企业结果分化
发现一 · 总体走势
联系在变紧,依赖先升后降
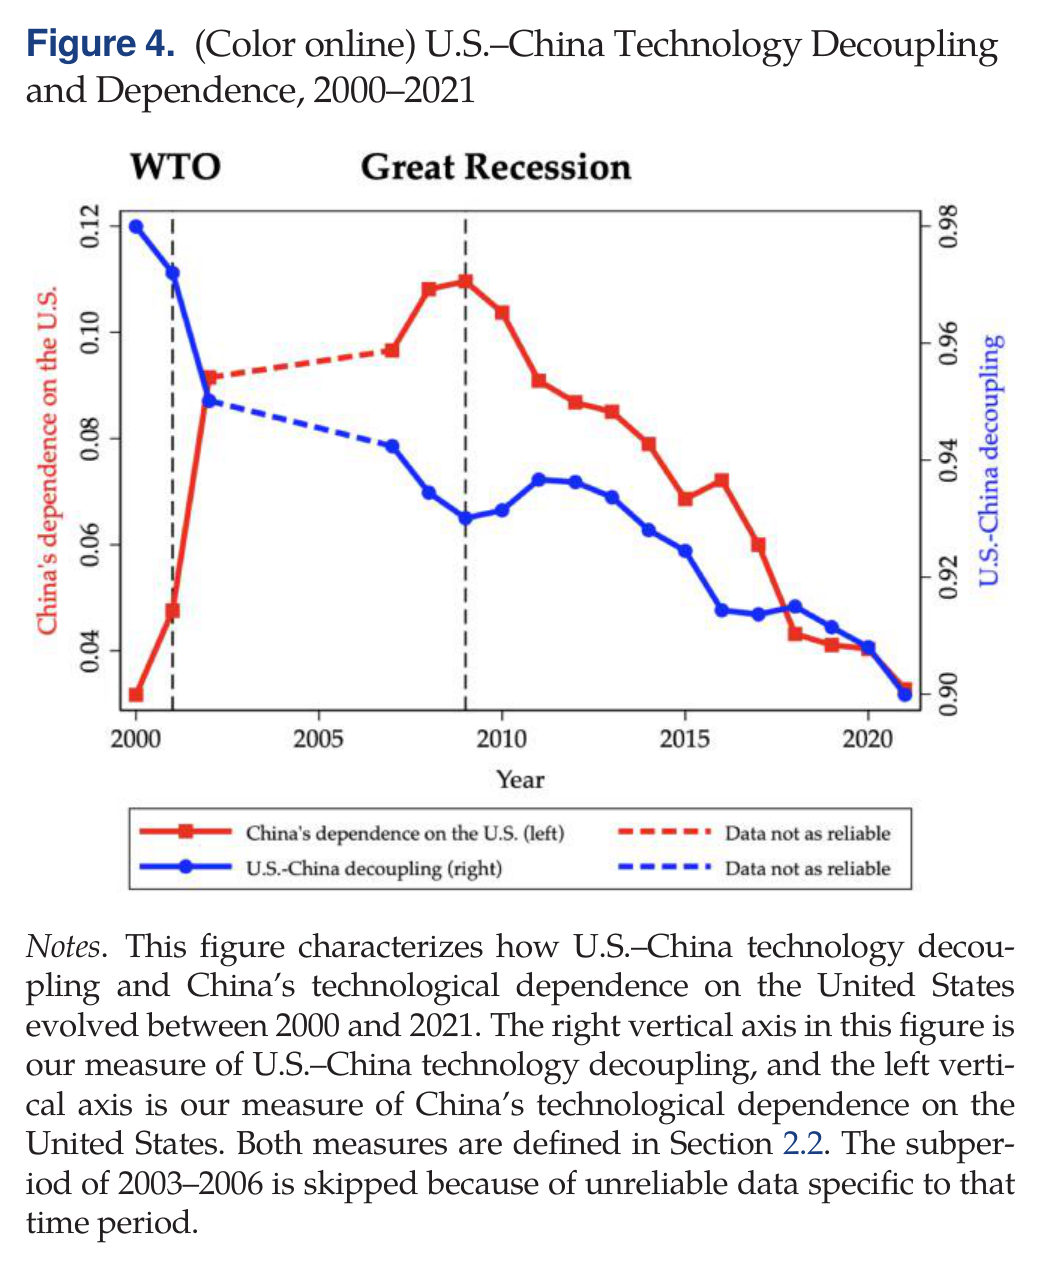
2000–2021 年测得的脱钩程度持续下降;中国对美国的依赖约在 2009 年前后见顶,之后一路回落。
见下一页 Figure 4。发现二 · 企业结果
创新产出上升,盈利与估值下降
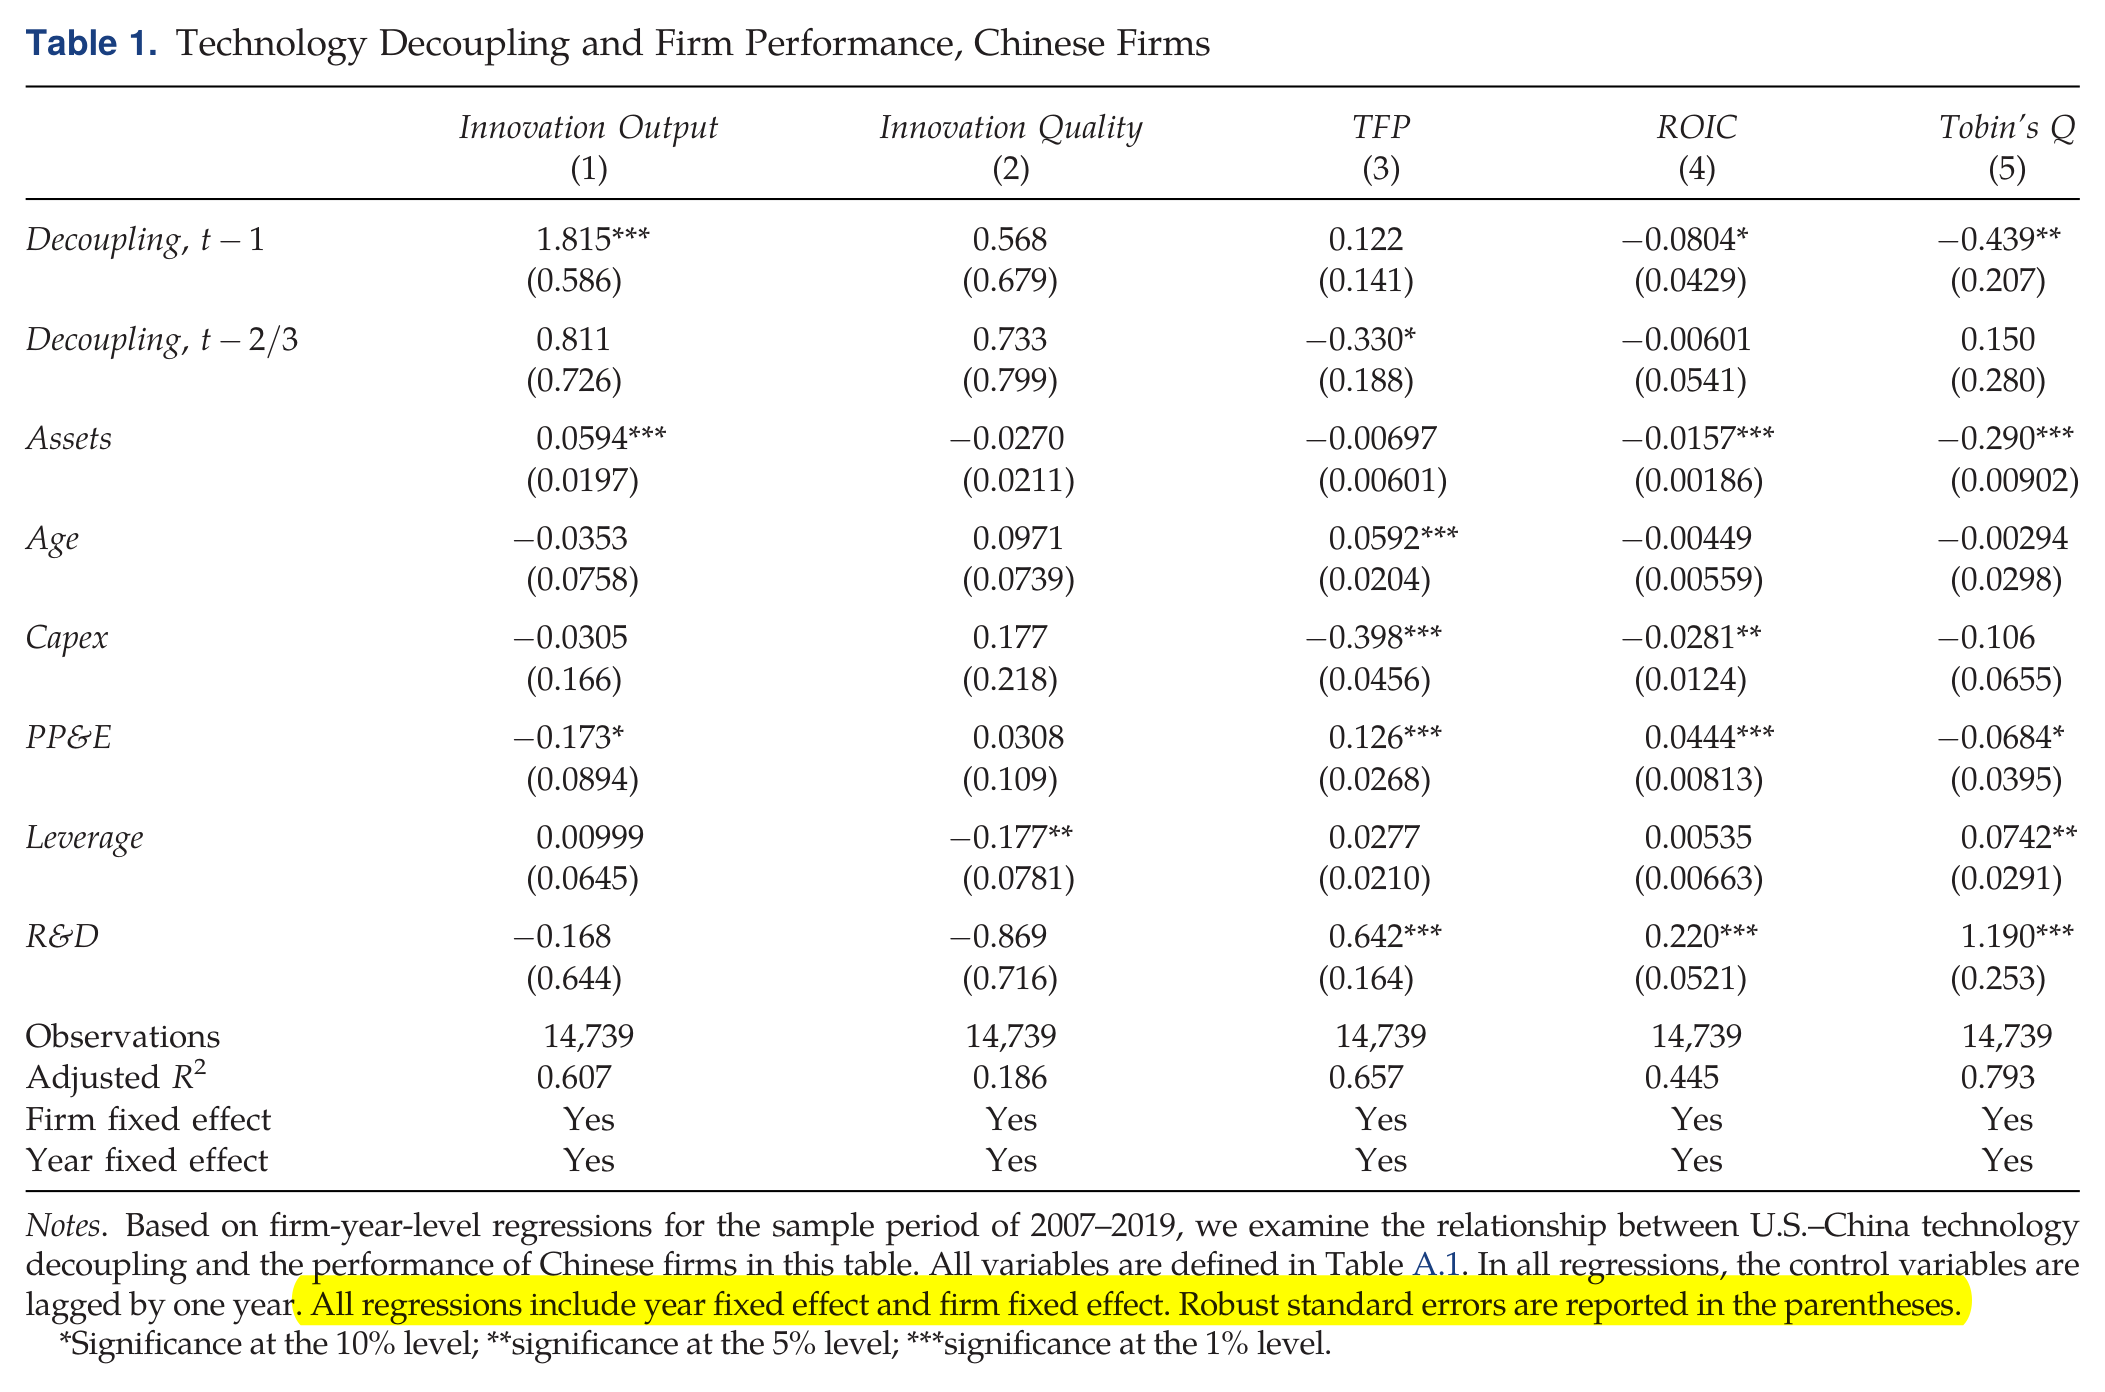
脱钩之后,中国企业的创新产出显著上升(滞后一期系数 1.815),盈利和估值显著下降(ROIC −0.0804、Tobin’s Q −0.439),创新质量与 TFP 不显著。
这就是 Table 1,今晚复现的对象。发现三 · 异质性
政策时期与技术领域不同
2014 年后的斜率、以及几类特定技术领域的表现与全样本不同。原文用 Table 2 处理,本课不复现这一张。
讲课时一句带过,不展开。
企业表给出的是控制企业、年份固定效应之后的相关关系,不能单凭它讲因果。今晚的任务是复现 Table 1,不是重复论文的全部论证。
Han et al.(2024), 摘要与 §§2–4;Table 1 数值见原文刊页 8397
II指标是怎么构造出来的
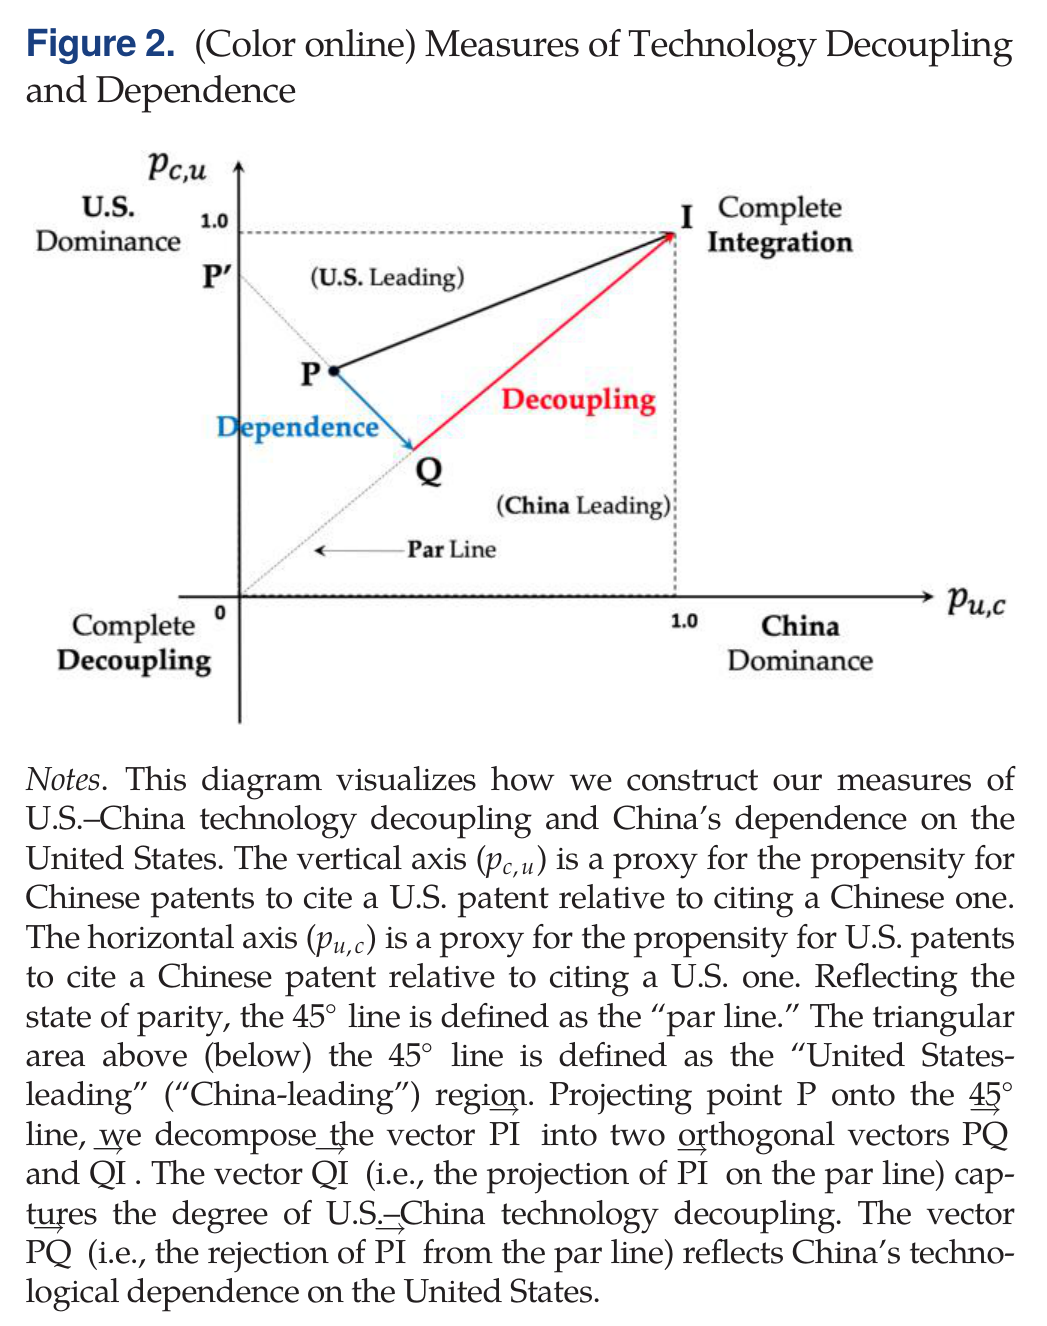
两个倾向,一张图,算出脱钩与依赖
![论文 Figure 2:脱钩与依赖的几何定义]()
两条轴各是什么
横轴:美国专利引用中国专利、相对引用本国专利的倾向
p(美→中) = (n(美,中) ÷ x(中)) ÷ (n(美,美) ÷ x(美))
纵轴:中国专利引用美国专利、相对引用本国专利的倾向
p(中→美) = (n(中,美) ÷ x(美)) ÷ (n(中,中) ÷ x(中))
n 是引用次数,x 是到当年为止该国授权的专利总数。除以 x 是为了不让两国专利数量的差距影响结果,否则量出来的只是谁专利多。
怎么读图。原点是两国互不引用,即完全脱钩;(1, 1) 是引用对方与引用本国一样频繁,即完全融合。把点投到 45° 对等线上:投到 (1, 1) 的距离是脱钩程度,离开对等线的垂直距离是依赖程度,落在上三角表示中国更依赖美国。
Han et al.(2024), Figure 2 与 §2.2 公式 (1),刊页 8389–8390
II原文 Figure 4
论文的总体趋势,比标题更复杂
![论文 Figure 4:2000 至 2021 年中美技术脱钩和中国对美依赖指数]()
这张图在讲什么
横轴是年份(2000–2021)。两条线各对一个纵轴:右轴是脱钩指标,左轴是依赖指标。
蓝线按右轴读。脱钩程度一路下降,说明两国的技术联系反而更紧了,与「正在脱钩」的直觉相反。
红线按左轴读。中国对美国的依赖先升后降,约在 2009 年见顶,此后持续回落。
虚线提醒。2003–2006 年引文数据不可靠,原文跳过这一段,不能拿它讲连续趋势。
Han et al.(2024), Figure 4, 刊页 8392
II企业回归从哪里来
专利指标接到企业年度面板
| 层次 | 课堂要核对什么 |
|---|
| 技术联系 | 中美专利交叉引用,按技术类别和年份构造脱钩与依赖指标 |
| 企业结果 | 中国企业 2007–2019 年的创新产出、创新质量、TFP、ROIC 和 Tobin’s Q |
| 回归规格 | 企业固定效应、年份固定效应、企业控制变量;原文报告稳健标准误 |
| 可用数据 | 作者复现包含 WRDS、Compustat、CSMAR 订阅资料;教师机有授权副本 |
课堂数据边界教师机本地只读运行原始 .dta;投屏只显示代码和聚合结果。下载包不包含原始或派生企业记录。
Han et al.(2024), §§2–3 与作者复现包说明
II原文 Table 1
五个结果变量,同一套中国企业样本
![Han et al.(2024)原文 Table 1 完整表题、五列和注释]()
Han et al.(2024), Table 1, 刊页 8397,点击可放大查看注释
IITable 1 的关键格
短期创新产出更高,盈利和估值更低
| 滞后一期脱钩 | 创新产出 | 创新质量 | TFP | ROIC | Tobin’s Q |
|---|
| 系数 | 1.815*** | 0.568 | 0.122 | −0.0804* | −0.439** |
| 稳健标准误 | 0.586 | 0.679 | 0.141 | 0.0429 | 0.207 |
| 企业年观测 | 14,739 | 14,739 | 14,739 | 14,739 | 14,739 |
复现时核对整张表:五列的核心系数、六个控制变量、样本量与调整 R² 都要对上。这张表给出的是控制固定效应之后的相关关系,不是单凭它就能成立的因果效应。
Han et al.(2024), Table 1;* p<0.1,** p<0.05,*** p<0.01
读完论文再动手
复现它:用同一份数据跑出整张表
论文给出五列的目标值。我们用自己的代码跑一遍,把整张表逐格对上;有出入就回到数据、变量和命令去查。
Han et al.(2024), Table 1;本机 Stata/MP 17 复现
III打开软件之前,先选入口
三种接法,最后都由 Stata 执行回归
01 · 直接使用
Stata 界面与 do-file
人打开软件,输入命令或运行脚本。每一步看得见,适合初学、单步排错和核对原文。
依赖本机 Stata 授权与可访问的数据。02 · 通过 skill
智能体调用 PyStata
skill 规定何时、怎样调用本地 Python 脚本;脚本把 do-file 交给 Stata。
适合已跑通、需要重复执行的固定流程。03 · 通过 MCP
智能体调用 Stata 服务
MCP 服务向智能体暴露运行工具。能力和权限取决于具体服务配置。
适合在已有受控服务的环境里跨工具编排。
共同点:都要读懂同一篇论文,使用同一份有权访问的数据,核对同一组 N、系数与标准误。接法本身不保证结果正确。
III三种方式怎么选
先用直接操作看懂输出,再把成熟步骤交给智能体
| 你现在的任务 | 合适入口 | 理由 |
|---|
| 第一次认识 Stata,或在查一条报错 | 软件界面 + do-file | 命令与输出同屏,容易定位是哪一行出了问题 |
| 同一张表要反复重跑、导出汇总 | skill / PyStata | 固定脚本和参数,能把执行步骤写成可重跑流程 |
| 已有可信 Stata MCP 服务,要和其他工具配合 | MCP | 通过统一工具接口调用;先确认它能做什么、能读哪些目录 |
今晚的选择教师先示范 Stata 界面,再用本地已配置的 PyStata skill 跑作者原始数据。MCP 讲接法与选择条件,不把临时安装服务当课堂目标。
III
PART III · 真实数据复现
现在打开 Stata,
用原始数据跑一张表
先认软件与我们自己写的代码,再看五次回归的聚合结果
III教师现场指给大家看
Stata 在哪里,命令从哪里运行
| 动作 | 看到什么 |
|---|
| Windows 开始菜单搜 Stata | 打开已获授权的版本;教师机使用 Stata/MP 17 |
| Command 窗口 | 逐条输入命令;先检查目录、数据描述和一条回归 |
| Results / Variables | 查看样本量、系数、标准误及当前变量 |
| Do-file Editor | 打开 .do,逐段运行,保存修改后的可重跑版本 |
今晚的数据来自作者随论文公开的复现包。本机没有 Stata 的同学跟着投屏读代码与结果,不要求自行安装。
III方式一 · 软件界面
在 Do-file Editor 里看懂一列真实回归
Table 1 · 创新产出列的实际命令
use "Table_1_Data.dta", clear
areg n_pat decoupling_l1 decoupling_l23 ///
asset age capex_ratio ppe_ratio leverage_ratio RnD_at_ratio ///
i.year, absorb(firm_ID) vce(robust)
读规格
n_pat 是被解释变量;两段滞后脱钩指标是核心解释变量;i.year 和 firm_ID 对应两组固定效应。
读输出
先找 N=14,739,再找 1.815 和稳健标准误 0.586。对不上时回查样本、变量和命令。
Han et al.(2024), Table 1;作者脚本回归语法按本机 Stata/MP 17 改用 areg,聚合结果与原文一致
III方式二 · skill 或 MCP
让智能体操作软件,仍然运行同一份 do-file
课堂演示:PyStata skill
智能体先读本地 skill.md,调用 run_stata.py -f <do-file>,PyStata 在本机启动授权的 Stata。
脚本只读入原始 .dta,输出聚合系数 CSV;输入文件不随会话上传。
可选接法:Stata MCP
智能体通过 MCP 的工具调用把命令交给已配置的 Stata 服务。具体能否读数据、运行 do-file,要看该服务暴露的工具和访问权限。
课堂不临时安装 MCP,也不假定所有服务接口一样。
两条智能体路线都只是在本地 Stata 前面加了调用层;核查原文表格和数据许可的工作没有转交出去。
III我们的复现工作区
作者包只读,代码另写一份
作者包
放在一处,只读不动
复现包整体放在固定目录,不改动任何文件。
→
提取
只取本表要用的
Table_1_Data.dta 一份数据,加作者原脚本与结果,作对照用。
→
重写
自己的代码,逐行注释
按论文规格写 01_复现Table1.do,结果导出成可逐格对照的长表。
真实数据的边界作者数据含订阅数据库资料。教师机本地读取,学员材料只收录可分享的回归汇总;工作区放在 _src 下,不进入发布脚本的取材范围。
工作区 _src/L3复现Table1/;本机 Stata/MP 17 运行
IIITable 1 · 五列已重跑
原文与本机结果,核心行逐格一致
| 本机聚合结果 | 创新产出 | 创新质量 | TFP | ROIC | Tobin’s Q |
|---|
| 脱钩滞后 1 年 | 1.815
(0.586) | 0.568
(0.679) | 0.122
(0.141) | −0.0804
(0.0429) | −0.439
(0.207) |
| 脱钩滞后 2–3 年 | 0.811
(0.726) | 0.733
(0.799) | −0.330
(0.188) | −0.00601
(0.0541) | 0.150
(0.280) |
| 每列 N | 14,739 | 14,739 | 14,739 | 14,739 | 14,739 |
括号内是 vce(robust) 标准误。上页原文 Table 1 是核对基准;本页数字来自原始数据的 5 次真实回归。
Han et al.(2024), Table 1;本机 Stata/MP 17 运行,仅展示核心行
III核对的是整张表
45 个系数、5 个样本量、5 个 R²,全部对上
| 对照维度 | 论文 Table 1 | 本机复现 |
|---|
| 系数(9 个变量 × 5 列) | 论文报告值 | 45 格全部一致 |
| 稳健标准误(同 45 格) | 括号内取值 | 全部一致 |
| 样本量(5 列) | 14,739 | 14,739 |
| 调整 R²(5 列) | 0.607 / 0.186 / 0.657 / 0.445 / 0.793 | 相同 |
判定按论文显示的三位有效数字:复现值四舍五入到同一精度后一致即算通过。整张表都对上,说明样本、变量与规格都理解对了,不是只碰对了一个数。逐格对照表在 结果/Table1_对比.md。
对照对象:作者复现包 Table_1_Results.txt;本机结果由 代码/03_对比与出表.py 生成,2026-09-30
IV
PART IV · 基准复现之后
同一列回归,
分两个时期再看
这是课堂练习;它是教学性的拓展,不是论文里的正式设计
IV一项简单拓展
把 2007–2019 年拆成前后两段
Table 1 第 1 列 · 只改样本期
areg n_pat decoupling_l1 decoupling_l23 asset age ///
capex_ratio ppe_ratio leverage_ratio RnD_at_ratio i.year ///
if inrange(year, 2007, 2013), absorb(firm_ID) vce(robust)
* 再把年份改为 2014, 2019 重跑同一规格
保持不变
因变量、两段脱钩指标、控制变量、企业和年份固定效应、稳健标准误。
只改一处
把样本期分为 2007–2013 和 2014–2019;分别记录 N、系数和标准误。
本机 Stata/MP 17 运行;基准规格取 Han et al.(2024)Table 1
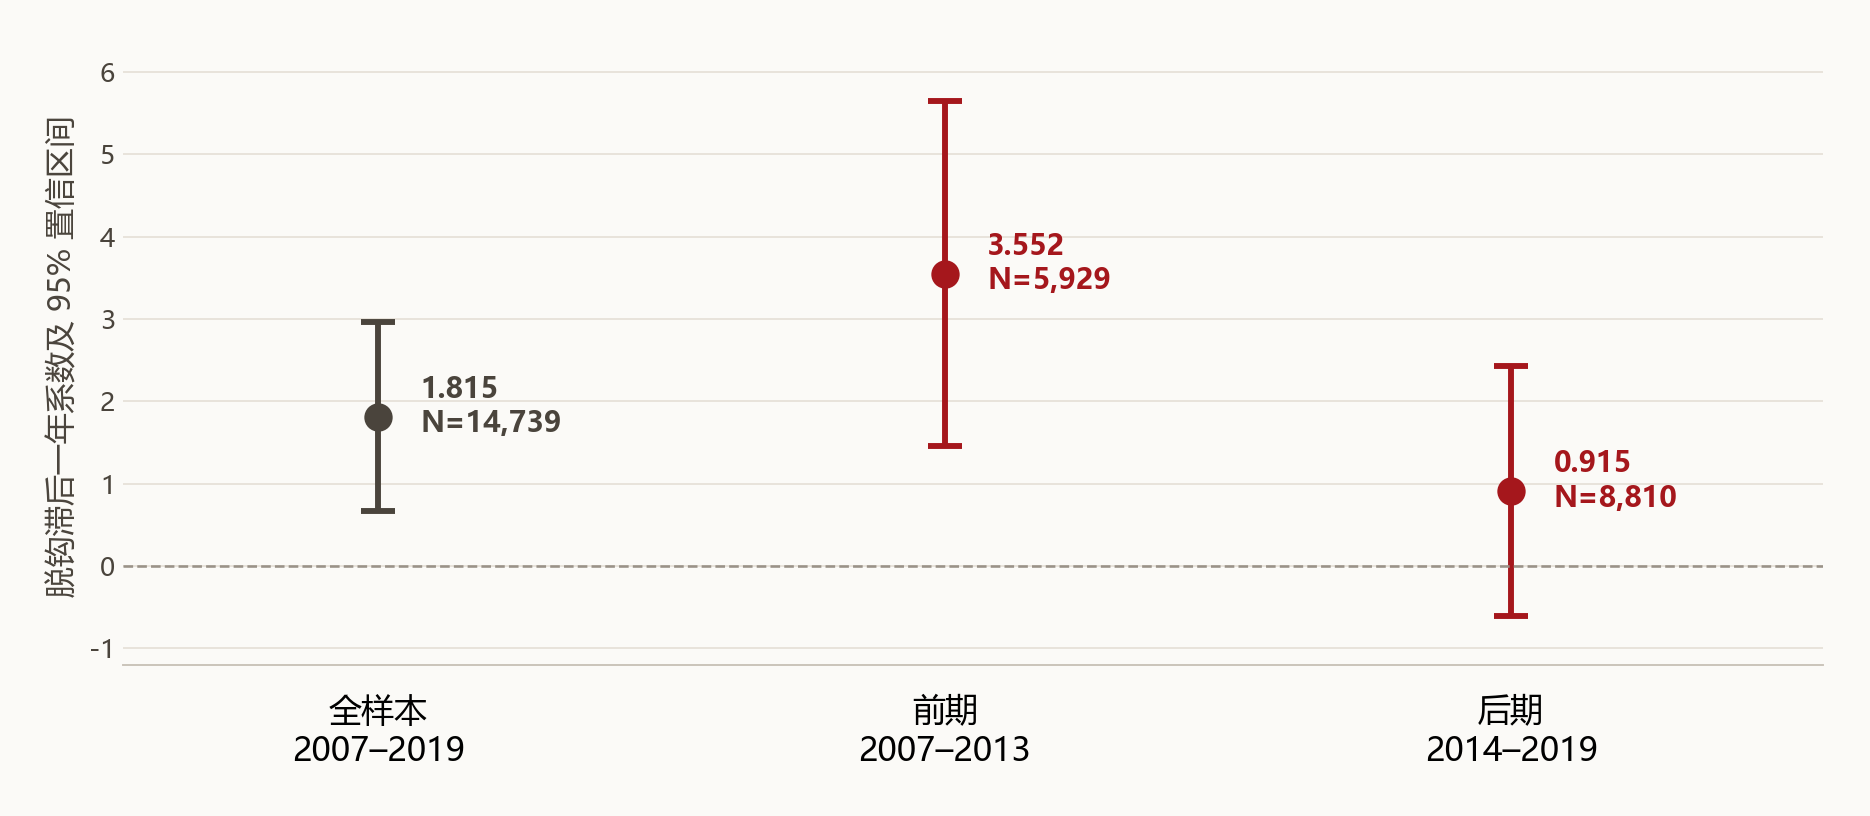
IV真实数据重新绘图
点估计变了,也要看不确定性
前期 3.552N=5,929;稳健标准误 1.068
后期 0.915N=8,810;稳健标准误 0.775
还需检验差异不能凭一组显著、一组不显著判断两期斜率不同
本机 Stata/MP 17 运行;图仅使用聚合系数与标准误
IV系数差异要单独检验
前后期点估计不同,交互项 p=0.190
−1.466
全样本交互模型中,滞后一期脱钩 × 2014 年后的估计
p = 0.190
当前检验没有足够证据断言两期斜率不同
可以说后期的点估计较小。不能说后期关系已经显著减弱,也不能将这一差别直接归因于制裁。
本机 Stata/MP 17 运行,Table 1 规格加时期交互项;交互模型与完全分组模型的控制变量斜率设定不同
晚间练习 · 两件事先让 AI 会跑 Stata,再用它复现 Table 1
装上能力,再跑通一张表
1装上 skill
把包里的 pystata 拷到本机 skills 目录,重开会话让它生效。
2冒烟测试
用 Stata 自带数据跑一个回归,看它能不能把结果说清楚。
3搭工作区
从作者包里挑出 Table 1 那几样,另建自己的目录,作者包只读。
4跑通并出表
自己写代码,逐格对上论文,再导成 RTF、Markdown 与 LaTeX。
对不上不要改数字去凑。按数据版本 → 变量构造 → 估计命令的顺序查,改一处重跑一次。
收尾 · 国庆期间
把今晚的方法,用在你自己选的论文上
| 顺序 | 产出 |
|---|
| 确认可行 | 论文、代码和公开数据能取得;写下核心表的样本与模型 |
| 完成复现 | 至少核对样本与描述统计、核心结果及一项稳健性或异质性结果 |
| 有余力再拓展 | 可补充公开数据或自己整理数据;说清新增工作、结果和局限 |
| 10 月 10 日 18:00 | 按平台现行三文件位提交报告、展示页和含代码的会话记录包 |
报告写清真实数据来源与使用权限。代码旁附 README,说明软件版本和运行顺序。
课后继续看
从报道回到原始论文与产品页面
新闻帮助你发现问题;复现时回到原论文、数据附录与作者代码。看视频时也要区分 AI 提议、仪器执行和人工验证。
下次课见
第 4 次课 · 多子代理与上下文管理
个人作业一
10 月 10 日 18:00 前在课程平台提交
张一帆 · 中山大学岭南学院 · 金融 AI 智能体设计与应用