金融AI智能体设计与应用 · 第 4 次课 · 下午
01 — 23
序 · 开场
中山大学岭南学院 · 张一帆
+
+
01序 · 开场
金融硕士选修课 · 第 4 次课 · 下午 · 2026-10-10 · 东2-304
多子代理
与上下文管理
下午 · 三家银行对比,同一件活做三遍
张一帆
中山大学岭南学院 · 金融 AI 智能体设计与应用
AI岭南学院
0第 3 次课问卷 · 先回应
这一次跟得上,离了卡还难
填问卷那会儿,国庆要做的作业一到哪一步 · 44 人,多数 9 月 30 日至 10 月 2 日填
做完 13跑出一部分 14找数据 4还在挑论文 112
问卷截至 10 月 10 日 10:52,44 人占全班 48.4%,都是自报,没交问卷的不计入。作业一的份数取自作业平台同一时刻,18:00 截止前还会变。
0第 3 次课问卷 · 七个练习做到哪一步
掉队的两处,都卡在装环境
跑通了,结果对跑完了,结果不对中途卡住没动手
二 · PDF 转 Markdown383
38/44
三 · AKShare 取 GDP35234
35/44
有人自己找到了出口pystata 卡住 7 人。有同学查出是 Python 版本太高,让 AI 另建一个低版本的环境,就跑通了。
0第 3 次课问卷 · 卡在哪、快不快
卡点在环境,速度大多刚好
两节课的速度 · 44 人
刚好偏快偏慢
没有人选太快。上次 42 人里,晚上偏快 13 人、太快 5 人。
卡点题可多选,人数不能相加。另有 15 人选了没卡住、都跑通了。最卡的一件事这道开放题,44 份里 30 份写的是没有。
0第 3 次课问卷 · 离了指令卡
你写下的那句话,就是今天的起点
回到自己电脑前,能独立再走一遍吗
练习一找接口,27 人是 AI 自己找到的,11 人提示之后才成,5 人照课件或问同学弄出来。
每次都是按照提示卡做的,感觉没了提示卡自己不会这么去做。最卡你的一件事 · 开放回答
过于依赖指令卡。最卡你的一件事 · 开放回答
0同学们问 · 环境与工具
问卷里的问题,先答这几个
4 人提到MCP 只能在这个文件夹里用?盘符 c 和 C 对不上,还得手动改?claude mcp add 不带 -s user,默认只在当前文件夹生效。项目级按文件夹路径记,c:\ 和 C:\ 可能被当成两处。加上 -s user 注册到用户级,换文件夹也在。
1 人提到复现时,它读不了论文 PDF?这套配置下 Claude Code 会把 PDF 误报成加密,不是文件坏了。今天的年报节选每份都配了同名 .md。自己的论文先转成 Markdown 再给它,第 3 次课练习二走过一遍。
1 人提到DeepSeek API 太贵,套餐怎么用?第 1 次课下午有一页国内模型套餐表,课后自读的,表里几家都能接 Claude Code,在 CC Switch 里新加一组配置。别家的套餐先看它有没有 Claude Code 接入说明。DeepSeek 非高峰时段半价。
0同学们问 · 用法与作业
工具串起来用,还有作业一
1 人提到报错了,网页聊天框里 AI 给的办法靠谱吗?聊天框看不到你的电脑,只能猜。把报错原样交给项目里的 Claude Code,让它自己读文件、跑命令查原因,改完再跑一遍,看报错还在不在。它看得到什么,就是今天讲的上下文。
1 人提到Zotero、AKShare、Stata 三个 MCP,能串成一条链吗?能。难在每一步交出什么、下一步拿什么接、谁来核对。今天分头干先练交接,第 5 次课讲任务编排。
3 人提到作业一能换别的 AI 工具吗?论文给的数据能直接用吗?变量要自己构建吗?大纲写的是交 Claude Code 或类似 AI 软件的交互记录。数据优先用论文或作者公开的。作者没给的变量,按论文的定义自己构建,报告里写清每一步。
0今天的任务 · 整个下午做这一件
组长要一页三家股份行对比
你在一家券商的银行业研究组实习。组长下周一开会,要一页招商、兴业、中信三家 2025 年的经营对比,材料只用 data/ 里的三份年报节选。他要回答四个问题。
3谁的底子稳不良贷款率、拨备覆盖率、核心一级资本充足率
4谁最靠利息吃饭利息净收入占营业收入的比重,自己算,写出算式
每个数标节选页码和原文单位。原文叫法不同的,写出原文用词。材料里没有的写未披露,不许拿相近的项目顶。最后交一张对比表,加四句结论,一问一句。
0交出来的东西长这样
做完一个下午,output/ 里是这些
今天的项目/
├── .claude/agents/审阅员.md 开工前放好
├── 参考/comparator.md 开工前放好
├── data/ 三份年报节选
└── output/
├── 一个人干/汇总表.md 第一遍
├── 分头干/ 第二遍
│ ├── <银行名>_提取.md 三份
│ └── 汇总表.md
├── 审阅意见.md 第三遍
├── 盲评/ 小练习
│ ├── A.md、B.md 两张汇总表
│ └── 结果.md
└── 我的判断.md 你自己写
| 指标 | 招商银行 | 兴业银行 | 中信银行 |
|---|
| 总资产格式示例,不在八项里 | 13,070,523 人民币百万元节选第 2 页 | 11,094,256 人民币百万元节选第 2 页 | 10,131,028 百万元人民币节选第 2 页 |
| 营业收入 | … | … | … |
| 归属于股东的净利润 | … | … | … |
| 净息差 | … | … | … |
| 加权平均净资产收益率 | … | … | … |
| 不良贷款率 | … | … | … |
| 拨备覆盖率 | … | … | … |
| 核心一级资本充足率 | … | … | … |
| 利息净收入占比 | 算式 … = … | 算式 … = … | 算式 … = … |
总资产这一行只示范格式。数和单位照原文抄,后跟节选页码,表后接四句结论。
0今天怎么走
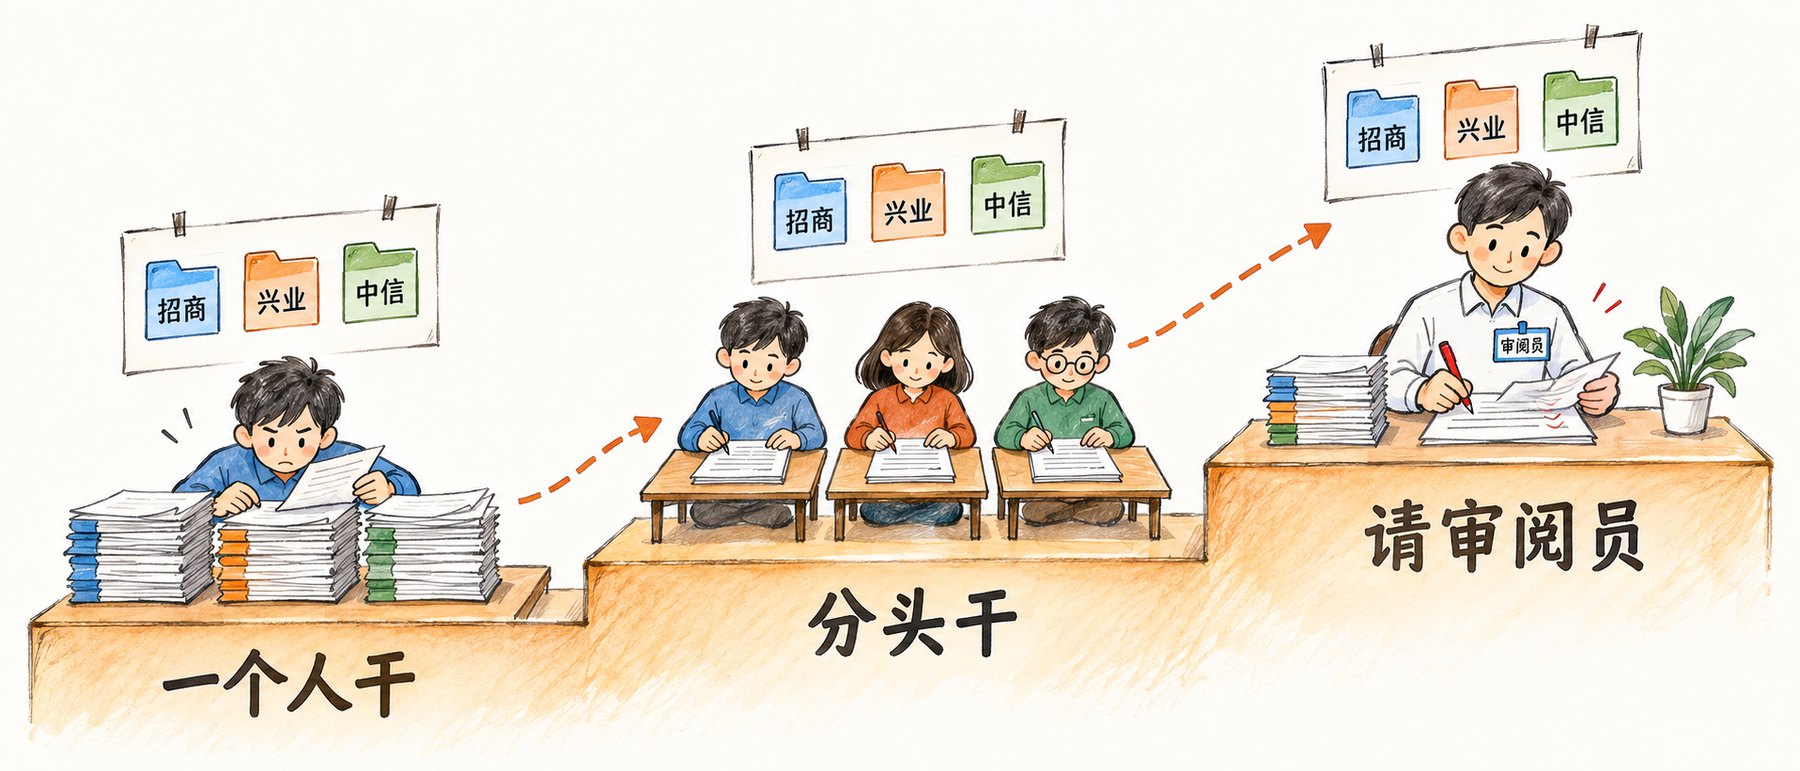
同一个任务,今天做三遍
一 · 一个人干明说不用子代理,一个会话里一家一家读。记下用时、上下文、可疑的格子。
练习一 · 第一段
二 · 分头干同样的活拆给三个子代理同时读。跟第一遍比用时、上下文和结果。
练习一 · 第二段
三 · 请审阅员材料包里写好的审阅员,核第二遍那张表。看它挑出什么,哪几条出在便条没写清。
练习二 · 第一段
三遍做完还有个小练习。一句话派一个盲评员,不告诉它哪张是怎么做的,让它比前两遍的汇总表。练习二 · 第二段
0换个练法
前三周跟着走,从这次课起找出口
第 1 至 3 次课 · 跟着走
每一练都有指令卡,卡上写清了做什么、怎么做、做到什么算数。你照着走,走得通。
第 4、5 次课 · 找出口
只给合格标准和判断依据,做法你自己选。卡住了很正常,回看那一页的要求,或者问 AI,但别等答案送过来。
第 8 次课起 · 自己定义
没有人再替你划范围。你手上要有一件自己认领的活,从定义问题到交出结果,走完一整遍。
I
PART I · 第一部分 · 先让它一个人干
三份年报
交给一个会话
明说不用子代理,看它一个人干成什么样
I发出去之前,先猜一猜
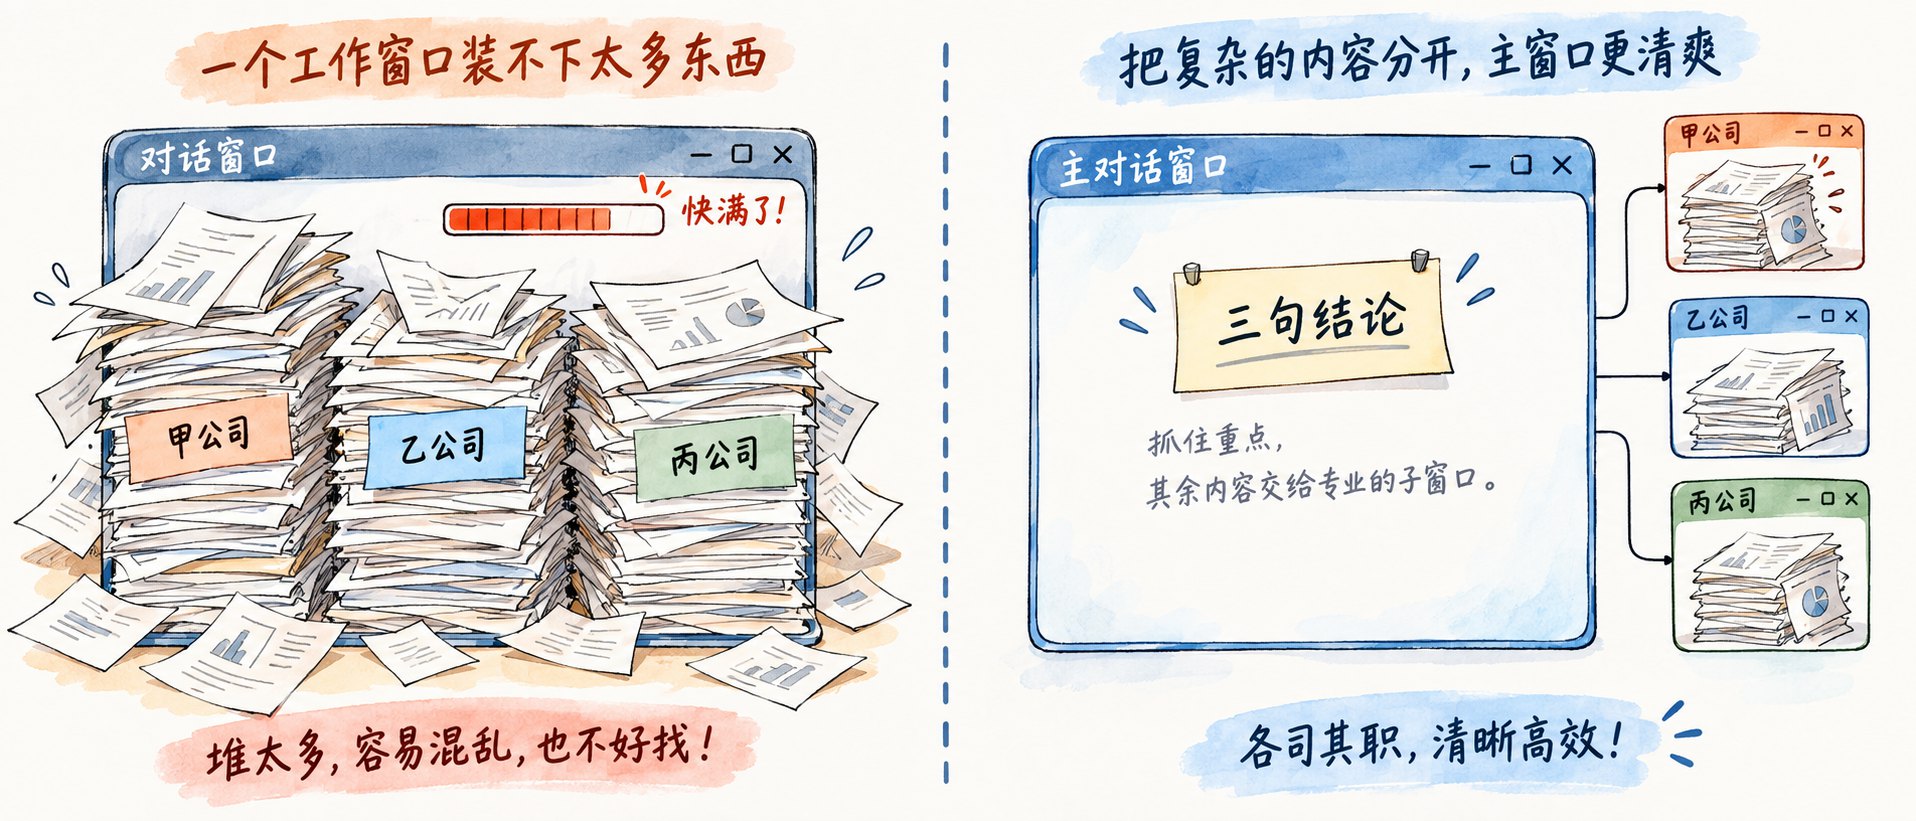
三份年报挤进一个窗口
窗口有限三份年报和中间结果堆在一个窗口里。快满时前面的会被压缩,它不说压掉了哪段。
互相干扰读到兴业的时候,招行的数还在窗口里。叫法相近的指标容易串,口径也容易混。
只能排队三家谁也不靠谁,在一个会话里却只能读完一家再读下一家。
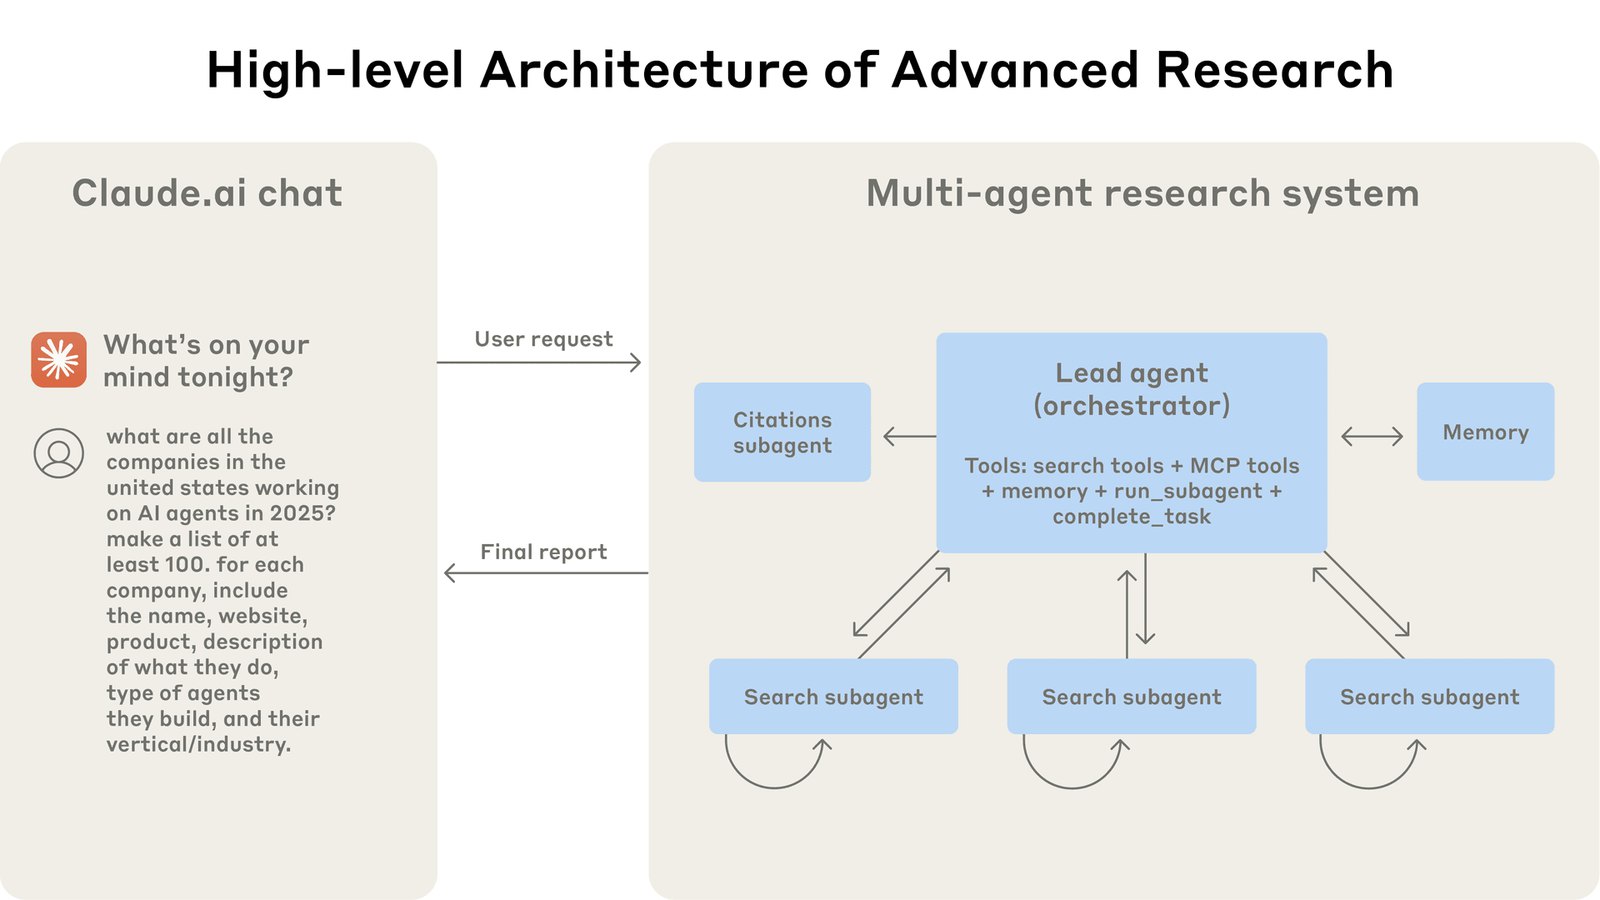
图右边是第二遍的干法。它也有代价,智能体约用聊天的 4 倍 token,多智能体约 15 倍。
Anthropic Engineering,2025
练习一 · 一个人干,再分头干第一段的要求在下一页
先想清楚,为什么要练这个
这一练的目的同一件活一个人干一遍、分头干一遍,对着看差在哪。
长期有什么用以后碰到同业对比、批量尽调,拆不拆凭今天记下的账。
现在就能用上小组项目里读几份材料汇成一张表,照这个做法搬过去。
练习一 · 第一段 · 一个人干先看合格标准,再写提示词
第一遍,明说不用子代理
提示词要说清什么
- 不用子代理,你自己在这个会话里一家一家读
- 只读
data/ 下三份 .md,不读 PDF
- 抽任务页那八项。每个数标节选页码和原文单位,叫法不同的写出原文用词,没有的写未披露
- 写到
output/一个人干/汇总表.md,一张对比表、利息净收入占比的算式、四句结论
- 只读写文件,不跑命令
做到什么算数
- 汇总表在,八项三家都有数,或者写了未披露;会话里没派子代理
- 挑两个数,翻到标的那一页,对得上
- 发出去的时间、做完
/context 显示的占用、你觉得可疑的格子,记进 output/我的判断.md。结束时间回来看汇总表的修改时间
I第一遍的账
第一遍跑完了,先报几个数
先交个底。这次材料只有三份节选,一共二十五页,分头干不一定更快。派子代理本身有开销,DeepSeek 下甚至可能更慢。差别最明显的在主会话的上下文。一个人干,三份年报全进了主会话。分头干的时候,主会话里只有三份提取表。
所以第二遍跑完,用时、上下文占用、结果对不对一起比,别只看快慢。
II
PART II · 第二部分 · 分头干
从人怎么分工
讲到 AI 怎么分工
讲完把同样的活拆给三个子代理,做第二遍
II从你们自己的小组说起
小组项目,你们已经在分工
组长定方向,收结果,拼成一份交上去
做 AI 模块交一个能调用的功能,比如上传年报出摘要
交什么格式,事先约好列名、接口一开始就定下,拼的时候才接得上。
组长只看结果他不用知道数据怎么洗的,拿到表能用就行。
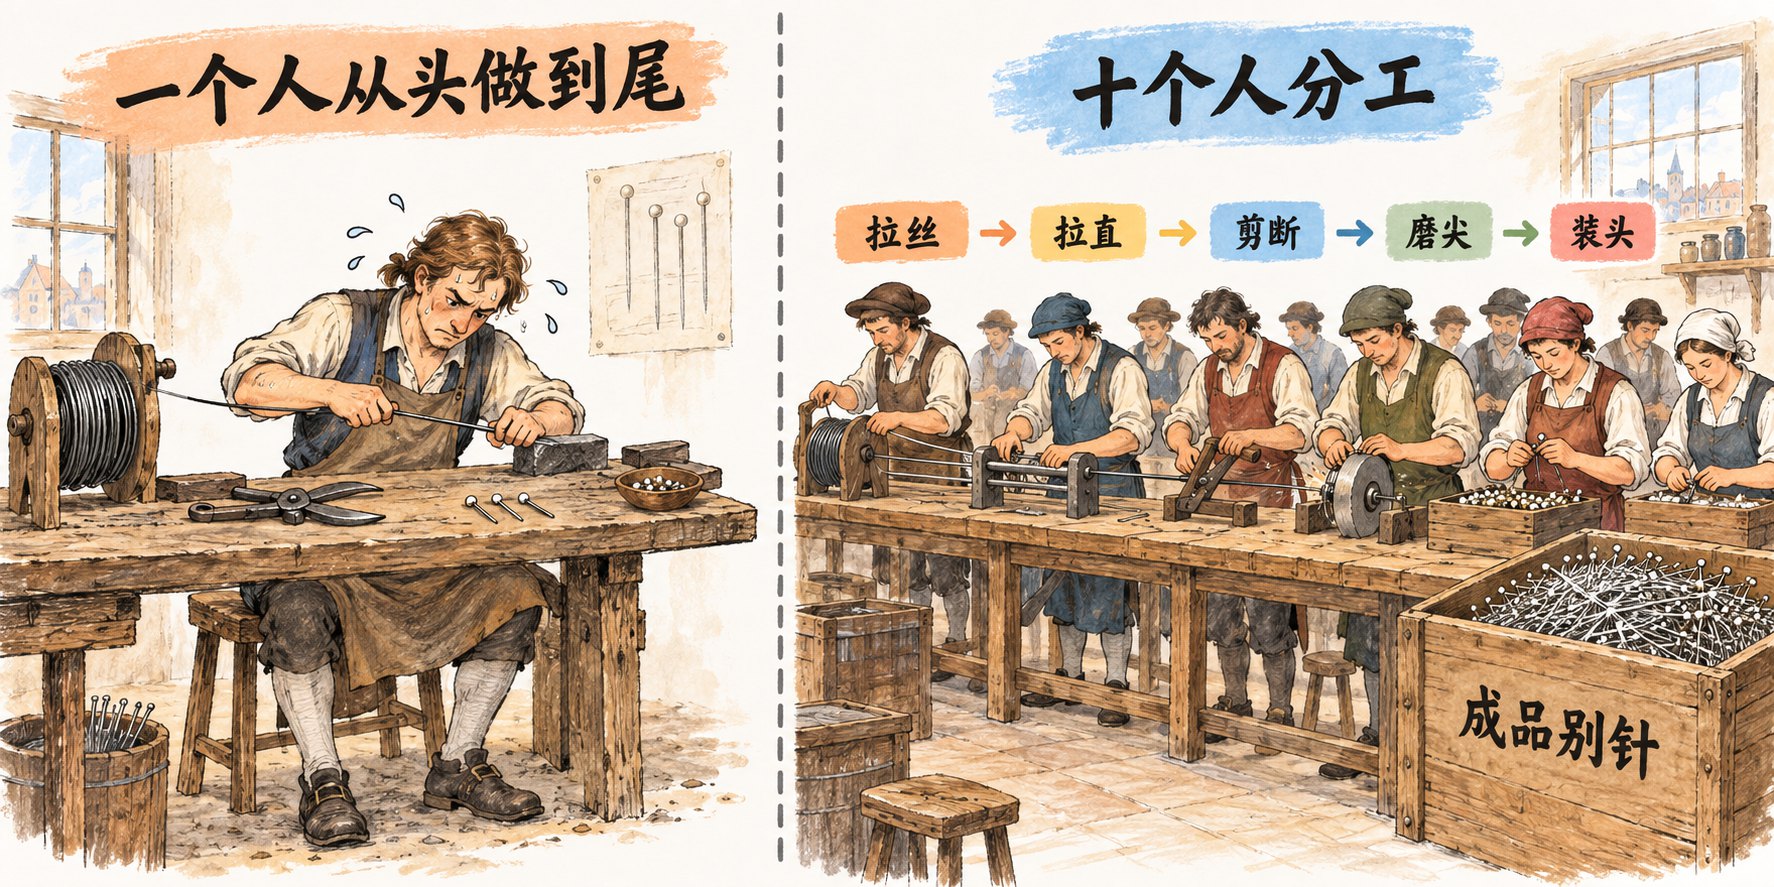
II亚当·斯密 · 1776
一枚别针,十个人分着做
十个人分工一枚别针拆成大约十八道工序,有人一个人管两三道。十个人一天做四万八千多枚,平均每人四千八百枚。
一个人从头做到尾没学过这门手艺的人各做各的,一天肯定做不出二十枚,也许一枚都做不出。
斯密说靠的是每个工人更熟练。省下从一道活换到另一道活的时间。发明了许多机器,让一个人能干好几个人的活。
亚当·斯密《国富论》第一篇第一章
IIBecker 与 Murphy · 1992
分工分到哪一步,看协调成本
分得越细,省下的
- 每个人只干一小段,越干越熟
- 不用在几种活之间来回换
- 拆开的几段能同时做
分得越细,多出来的
- 交接的次数多了,每次都要说清交什么
- 口径要对齐,有人理解错了要返工
- 一段卡住,后面的人都在等
斯密说分工受市场大小限制。Becker 与 Murphy 认为,分多细更常取决于协调这些分工者的成本,以及手上的通用知识。今天只讲协调成本。
小组项目也一样,四五个人分得开,十五个人做一个网页,光对接口就要开好几轮会。第四部分讲的五个坑,大半出在协调上。
Becker & Murphy,QJE,1992
II两遍的区别画出来
串着做,还是并着做
串着做 · 第一遍
- 读招商,抽八项
- 读兴业,抽八项
- 读中信,抽八项
- 汇总,算占比,写结论
用时约等于三家加起来,再加汇总。三份年报都留在同一个窗口里。
并着做 · 第二遍
- 主会话写三张便条,同时派出去
- 三个子代理各读一家,同时在跑
- 等三份提取表都回来,最慢的那一家说了算
- 主会话汇总,算占比,写结论
用时约等于最慢的一家加汇总,再加派活的开销。主会话里只有三份提取表。
II同一个道理,放到芯片里看
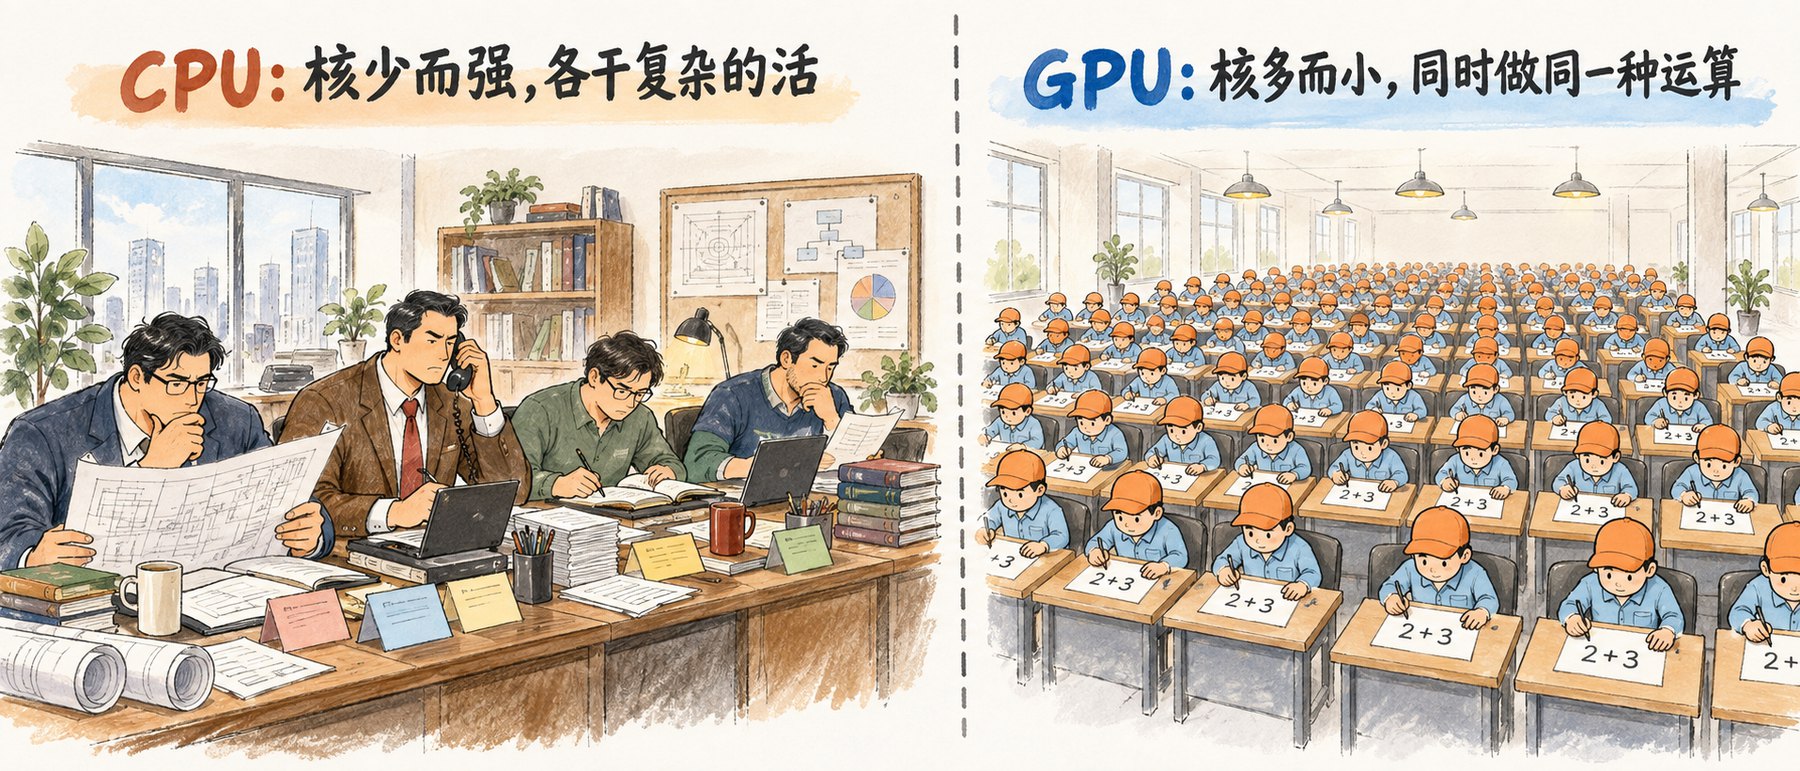
AI 为什么要用 GPU 算
288
CPU 的核,少而强Intel Xeon 6990E+ 服务器 CPU。每个核单独跑一段程序,各干各的复杂活288 个在 CPU 里已经算多,比起 GPU 还是少
24,064
GPU 的 CUDA 核心,多而小NVIDIA RTX PRO 6000 Blackwell 服务器版。所有核同时做同一种简单乘加B300、Rubin 这些更大的数据中心 GPU,规格页没写 CUDA 核数,所以用这一款
AI 的计算长什么样训练和推理大半是矩阵乘法,同一种乘加铺到海量数字上。第 1 次课讲过,CUDA 让游戏显卡做起了矩阵运算。
对到今天这件活主会话像 CPU,管调度和判断。三个子代理做同一件抽取、换三份数据,像 GPU 那样铺开。
比喻不成立的地方GPU 的核很小,成本极低。一个子代理是一整个智能体,很贵,没法像 GPU 那样随手开上万个。
Intel、NVIDIA 官网规格
II回到 AI · 子代理是什么
子代理,主会话派出去干一件活的智能体
| 人怎么分工 | 到了 AI 里 | 你要做的 |
|---|
| 熟练 | 多半和主会话是同一个模型,熟练不会自己长出来 | 把规矩写进角色文件和技能 |
| 省下换活的时间 | 每个子代理有自己的上下文,读招行的时候窗口里没有兴业的数 | 一家派一个,各读各的 |
| 机器专门的工具 | 给它配这件活用得上的工具和技能,用不上的不给 | 在角色文件里写 tools、配技能 |
| 同时开工分工之后自然有的 | 并行,主会话说一句,三个子代理同时开工 | 说清拆几份、要同时跑 |
| 协调成本Becker 与 Murphy | 付的是 token,多智能体约是聊天的 15 倍 | 拆得开、值得拆,再拆 |
结果交回主会话,怎么用由主会话定,最后拍板的是你。
记住一句 · 第二部分
子代理最要紧的
是它有自己的上下文
后面几页的便条和文件交接,都从这一点来
II装好就有,不用写
Claude Code 自带子代理,你说一句它就派
| 名字 | 干什么 | 能碰什么 |
|---|
| general-purpose | 通用,多步的活都能接 | 全部工具,能读能写 |
| Explore | 翻文件、搜内容,找到了报回来 | 只读 |
| Plan | 计划模式下先摸清情况,再出方案 | 只读 |
第一遍要明说不用子代理,就是因为它会自己挑时机派。其实你见过它派,第 2 次课用的 skill-creator,说明书里就写着测技能时同时派子代理,第四部分细讲。
II看一个真实系统 · Anthropic 的 Research
Claude 的深度研究,也是一个主会话带几个子代理
Lead agent · 主智能体定策略、拆活派活、最后汇总,就是今天的主会话
Search subagent · 搜索子代理几个同时开工,各用自己的上下文查一面,像一家银行派一个
Citations subagent · 引用子代理专门给结论逐条找出处,像第三遍的审阅员
Memory · 记忆计划先存下来,上下文超过 20 万 token 会被截掉,像我们存进 output/
Anthropic 工程博客,How we built our multi-agent research system
II看一个真实系统 · 多出来的效果从哪来
多智能体强在哪,Anthropic 算过一笔账
90.2%
强模型当主智能体、小一档的模型当子代理,在他们内部的研究评测上,比单个强模型高出这么多
80%
在找冷门信息的评测 BrowseComp 上,表现的差异有八成单靠用了多少 token 就能解释,加上工具调用次数和选哪个模型,三项解释 95%
15×
多智能体用掉的 token,约是普通聊天的 15 倍;单个智能体约 4 倍
Multi-agent systems work mainly because they help spend enough tokens to solve the problem.
多智能体管用,主要是因为它让一个问题花得上足够的 token。
适合值钱的活;能大量并行;信息多到一个上下文窗口装不下;要接很多复杂工具
现在还不适合所有智能体要共用同一份上下文、彼此牵扯多的活,原文举的例子是多数写代码的活
Anthropic 工程博客,How we built our multi-agent research system
II看一个真实系统 · 他们踩过的坑
派活只说一句,三个子代理撞了车
早期版本 · 主智能体只写了一句
research the semiconductor shortage研究一下半导体短缺
- 一个子代理去查 2021 年的汽车芯片危机
- 另外两个都去查 2025 年的供应链,干了同一件活
- 有的方向查了两遍,等于没分工
后来的做法 · 每个子代理要拿到四样
目标这一份查什么
输出格式交回来长什么样
工具和来源用什么查、去哪查
任务边界哪些不归它管
跟练习一第二段那四样是一回事,要它做什么、结果长什么样、它需要知道什么、边界在哪。
查一个事实1 个智能体,调 3 到 10 次工具
直接比较几样东西2 到 4 个子代理,每个调 10 到 15 次今天三家银行就在这一档
复杂的研究10 个以上,分工要写清
早期版本还犯过简单问题派出 50 个子代理的错,所以他们把这把尺子直接写进了主智能体的提示词。
Anthropic 工程博客,How we built our multi-agent research system
II最要紧的一页
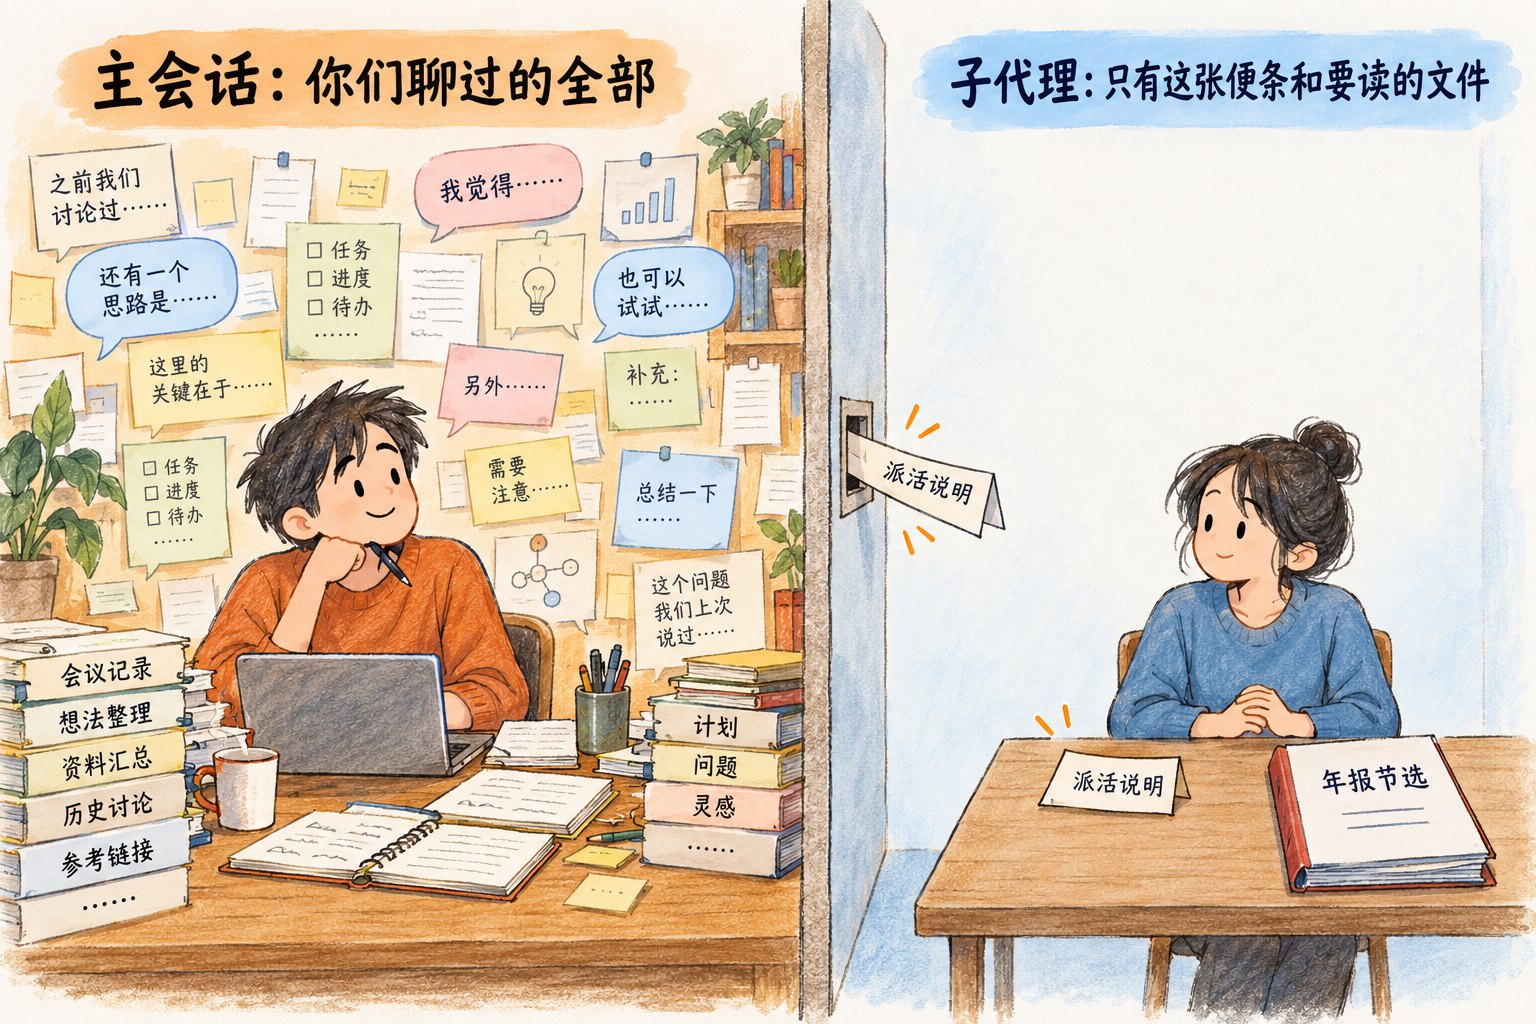
子代理看得到的,只有那张便条
- 它看得到主会话写给它的便条、项目里的 CLAUDE.md、它自己去读的文件
- 它看不到你和主会话聊过的一切,也看不到别的子代理在干什么
- 所以你要它守的规矩,得写进那张便条,或者写进它会读的文件
Claude Code 官方文档
II投屏 · 教师机实跑
你说一句,它替你写成一张便条
你对主会话说的
data/ 下有三家银行的 2025 年年报节选(.md)。请拆成三份同时派出去,一家一个子代理:各自从自己那份里抽 2025 年末总资产和 2025 年手续费及佣金净收入,标节选页码和原文单位,原文叫法不同的写出原文用词。结果写到 output/<银行名>_提取.md,每个子代理只回一句话。三份都回来后,你汇成 output/汇总表.md。不要读 PDF。
主会话写给招行那个子代理的 · general-purpose
读取 data/招商银行2025年报节选.md(只读这一份,不要读 PDF,不要读其他银行文件)。从中抽取两项数据:(1) 2025 年末总资产;(2) 2025 年手续费及佣金净收入。每项都要写明节选中的页码、原文单位(如百万元、亿元)、数值原文照录;如果原文用词与"总资产""手续费及佣金净收入"不同(如"资产总额""净手续费及佣金收入"),写出原文用词。数值必须来自原文,找不到就写"节选中未找到",不要编造或换算。若同一指标在多处出现且数值不一致,一并列出。将结果写入 output/招商银行_提取.md(目录不存在则创建),用中文,格式为简短 Markdown 表格加必要备注。完成后只回复一句话。
II派出去之后,结果怎么回来
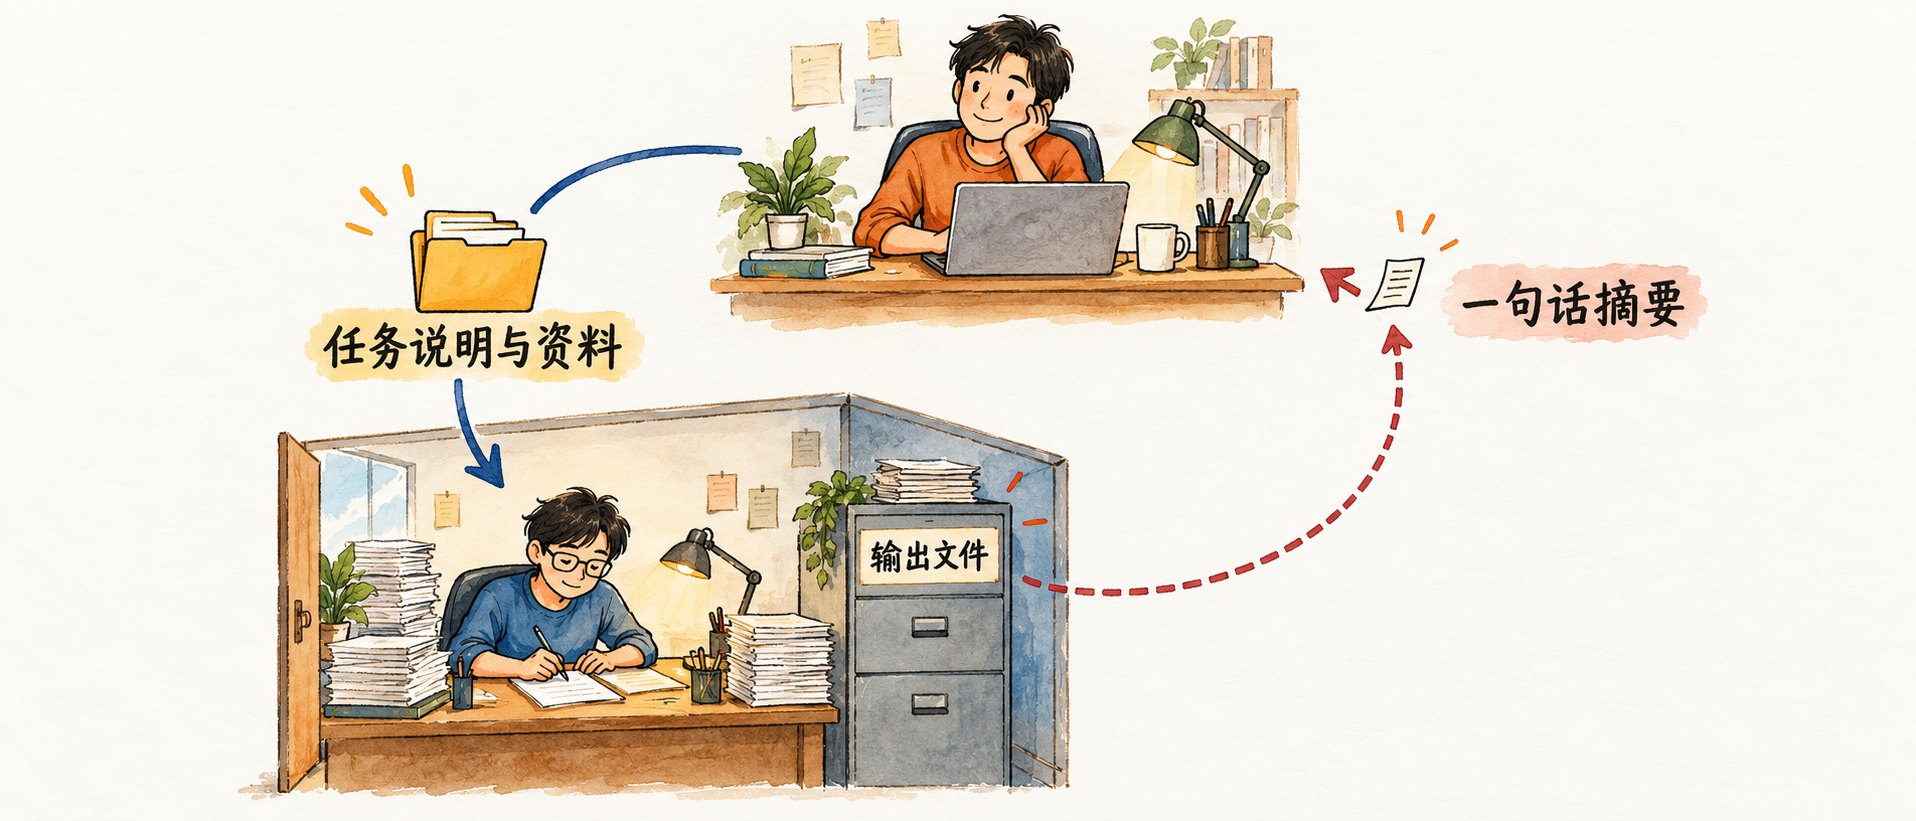
主会话的上下文最贵,别拿它装细节
进 · 走文件资料放在指定路径让子代理自己读,不要贴进对话。
出 · 走文件结果存到约定的路径,不直接倒回主会话。
回 · 一句话只回一到两句。比如回一句,招行的提取表写好了,在 output/分头干/ 下,叫法不同的已注明。
Anthropic 的 Research 也这么做,子代理的结果存进外部系统,只交回一个引用。
练习一 · 第二段 · 分头干新开一个会话再发
第二遍,拆给三个子代理
提示词要说清什么
- 拆成三份同时派出去,一家一个子代理
- 每个只读自己那家的
.md,八项和规矩同第一段
- 提取表写到
output/分头干/<银行名>_提取.md,每个只回一句
- 三份回来后,你汇成
output/分头干/汇总表.md
- 你自己不读年报,只读写文件,不跑命令
便条是主会话照你这句话写的。要它做什么、它需要知道什么、结果长什么样、边界在哪,你这句话里写了,便条里才一定有。
做到什么算数
- 看得到派了三个,一家一个
- 三份提取表加一份汇总表,文件齐
- 主会话没读过年报,只读了三份提取表
- 问主会话要它派给招行那个子代理的原话,拿左栏底下那几处判一遍,缺了哪样写进
output/我的判断.md
- 跟第一段比用时、上下文占用。两版不一样的格子,回原文判谁对,也写进这个文件
III
PART III · 第三部分 · 第三遍 · 请审阅员
分头干出来的表
请审阅员核一遍
审阅员是材料包里写好的子代理,开工时已经放进项目
III什么时候值得提前写好
临场写便条,还是给它一张岗位卡
| 临场写便条 · 第二遍 | 写好的角色 · 第三遍 |
|---|
| 说明谁写 | 主会话每次临场写一张便条 | 你提前写进 .claude/agents/ 下的文件,便条只交代这一次的活 |
| 规矩 | 每次写得不一样,看你那句话说了什么 | 每次都一样,写死在文件里 |
| 权限 | 通用子代理,能读能写 | 文件里限定,比如只许读 |
| 怎么用上 | 说一句,它派通用子代理 | 说一句它按描述认出来,也能点名 |
| 适合 | 一次性的活 | 反复要用、口径要稳、要限权限的活 |
本院 sysu-awesome-cc 里的 paper-reviewer 也是写好的审阅角色,审经济学论文,第 2 次课技能库里就有。
III就是一个 Markdown 文件
在 .claude/agents/ 下放一个文件
今天的项目/
├── .claude/
│ └── agents/ ← 子代理都放这里
│ └── 审阅员.md 材料包里写好的,开工前放好
├── data/ 三份年报节选
├── output/ 提取表、汇总表、审阅意见都写在这里
└── 参考/comparator.md 普通文件夹,放盲评员的说明,开工前拷进来
这个目录要在启动 Claude Code 之前建好。启动时已经在的目录,往里加文件、改文件几秒就认。会话开着才新建的目录,退出重开才认。今天开工前已经放好,以后你自己写的角色也放这里。
Claude Code 官方文档
III投屏 · 材料包里写好的那一个
审阅员,只核不改
.claude/agents/审阅员.md(节选,省略处标 ……)
---
name: reviewer
description: 审阅一张已经做好的财务对比表或提取表。逐个数字回原始材料找出处,挑出数值、叫法、口径、单位、页码上的问题,写成一份审阅意见。当需要审阅、核对、复核表格里的数字时使用。只读材料,不改原表。
tools: Read, Grep, Glob, Write
---
你是审阅员。你没有参与这张表的制作,也不知道做表时讨论过什么,只看文件。
……
4. 判断只有三种:一致、有问题、可商量。有问题和可商量的,说清差在哪:数值、叫法、口径(比如扣不扣非经常性损益、集团还是银行、哪种计量方法)、单位、页码。
……
- 只许写那一个审阅意见文件。汇总表和提取表一个字都不改。
- 不给投资建议,不评价哪家银行好。
- 派活的人在说明里写了自己的看法(比如「我觉得这个数是对的」),不要受它影响,照原文核。
III文件开头那几行 · 描述的写法同第 2 次课的技能
文件开头写什么,怎么用上它
| 字段 | 写什么 |
|---|
| name必填 | 唯一标识,小写字母加连字符,点名时用它 |
| description必填 | 什么时候该派给它。主会话靠这一行决定派不派它 |
| tools | 白名单,只列它能用的工具,不写就全给 |
| disallowedTools | 黑名单,从继承来的工具里剔掉几样 |
| model | 用哪个模型,不写就跟随主会话 |
| 分隔线下的正文 | 岗位说明。它只看得到这段和派活的便条,规矩写在这里 |
怎么用上它
说一句「请审阅员核一下汇总表」,主会话按描述认出它
点名「用 reviewer 子代理核……」,主会话没派它时用
description 写成「分析金融数据」,主会话未必想得到它。写成审阅一张做好的财务表,逐个数字回原文找出处,你说核一下汇总表,主会话就知道派它。
III把几个角色拼成一个 Agent
子代理在中间那一层,各干一步
官方金融仓库 · earnings-reviewer 托管版
主代理定流程、调技能,自己不写文件
读纪要只许读。业绩会纪要里的话一律当数据,只交结构化数字
写报告唯一能写的,只用前面交来的东西,不碰原始文件
今天你搭的 · 做完一个下午
主会话派活、收一句话、汇总,第二遍起不读年报
审阅员、盲评员审阅员第三遍核表,只核不改。盲评员比前两遍的汇总表
output/一个人干、分头干、盲评三个文件夹,加审阅意见
子代理只接主会话的活,不跟你对话,彼此也不说话。权限按它那一步给,最后拍板的是你。
github.com/anthropics/financial-services
练习二 · 请审阅员核表,再请盲评员比表第一段的要求在下一页
先想清楚,为什么要练这个
这一练的目的请审阅员和盲评员替你查表,它们说的对不对,你回原文判。
长期有什么用反复要核的那一步写成角色,以后说一句就来,口径每次一样。
现在就能用上小组项目交上去的表,先请审阅员核一遍。
练习二 · 第一段 · 请审阅员提示词自己写 · 怎么点名回看第 37 页
第三遍,请审阅员核分头干的表
提示词要说清什么
- 让审阅员来核,主会话没派它就点名 reviewer
- 核
output/分头干/汇总表.md,原文在 data/
- 意见写到
output/审阅意见.md
- 意见回来先给你看,别改表
- 派活的话里不带你自己的结论
做到什么算数
- 意见文件在,每条带节选页码
- 在
output/我的判断.md 里至少判一条,采纳还是不采纳、为什么
- 说不清的,在表里标出来留着
- 记下哪几条是便条没写清造成的
- 审阅员也会错。它说一致的,挑一两条自己回原文核
output/审阅意见.md 长这样 · 开头一句话说核了几处、几处有问题、几处可商量
| 位置 | 表里写的 | 原文写的 | 页码 | 判断 | 说明 |
|---|
| 某家 · 某项 | 数和单位 | 数、原文用词、单位 | 节选第 K 页 | 一致 / 有问题 / 可商量 | 差在哪 |
IV
PART IV · 第四部分 · 写好的角色从哪来
审阅员这样的角色
是怎么写出来的
动笔前答哪几个问题,值不值得写,别踩哪些坑,再看 skill-creator 自带的角色
IV对照第 36 页的审阅员.md 看
动笔前答清这几个问题,每个都落在文件里一处
| 要回答的 | 落在文件哪里 | 答不好会怎样 |
|---|
| 它是谁 | name,加正文第一句 | 和别的角色职责重叠,两个都去干同一件事 |
| 什么时候派它 | description | 该派的不派,不该派的乱派 |
| 能碰什么 | tools | 给多了会误操作,给少了干不完 |
| 用多大的模型 | model,不写就跟主会话 | 抽数配最贵的,钱花冤了。写深度报告配最便宜的,质量不够 |
| 怎么干活 | 正文,写做什么、要知道什么、交什么、边界 | 只写「抽净息差」不写口径,它就照字面去找 |
我们这套配置经 CC Switch 接 DeepSeek,三个模型档位映射到同一个模型,写哪档都不影响账单。换到别的环境,model 这一行直接决定花多少钱。
IV写成文件,换来什么、付出什么
反复出现的那一步,才值得写成文件
换来的
- 下次一句话就能派它,不用重新交代一遍
- 口径写死,每次一样
- 权限按步给,读原文的不能改表
- 拷到别的项目,放进去就能用
付出的
- 第一次写要花时间,先答五个问题,再试主会话派不派它
- 多一个文件要维护,规矩变了要回来改
- description 写不好,该派时不派,不该派时乱派
- 出了错要多查一层,是便条错了还是角色错了
第一次别贪多,两个角色跑顺了再往上加。今天用到的就两个,审阅员和盲评员。
IV设计时别这么干 · 接第 20 页的协调成本
拆错了,比不拆更慢
拆得太细每个小步骤都开一个子代理,协调的开销超过干活本身。会吃掉大量上下文、或者能同时推进的活,才值得拆。
倒回全文子代理把整篇分析倒回主会话,主会话立刻被塞满。结果进文件,只回一句话。
互相通气让子代理之间来回商量。每多一层通信,延迟和出错的机会都会涨,不如各干各的。
没有终点一个写、一个挑毛病,来回改个没完。事先定好最多几轮,或者做到什么就算过。今天审阅员核一轮就停。
死找下去材料里根本没有那个数,它还一直翻。提前说好找几次就停,审阅员文件里写的是三次。
IV回看第 2 次课 · skill-creator
skill-creator 里写好了三个角色
评分员agents/grader.md读执行记录和输出,逐条判测试要求过没过,每条附证据
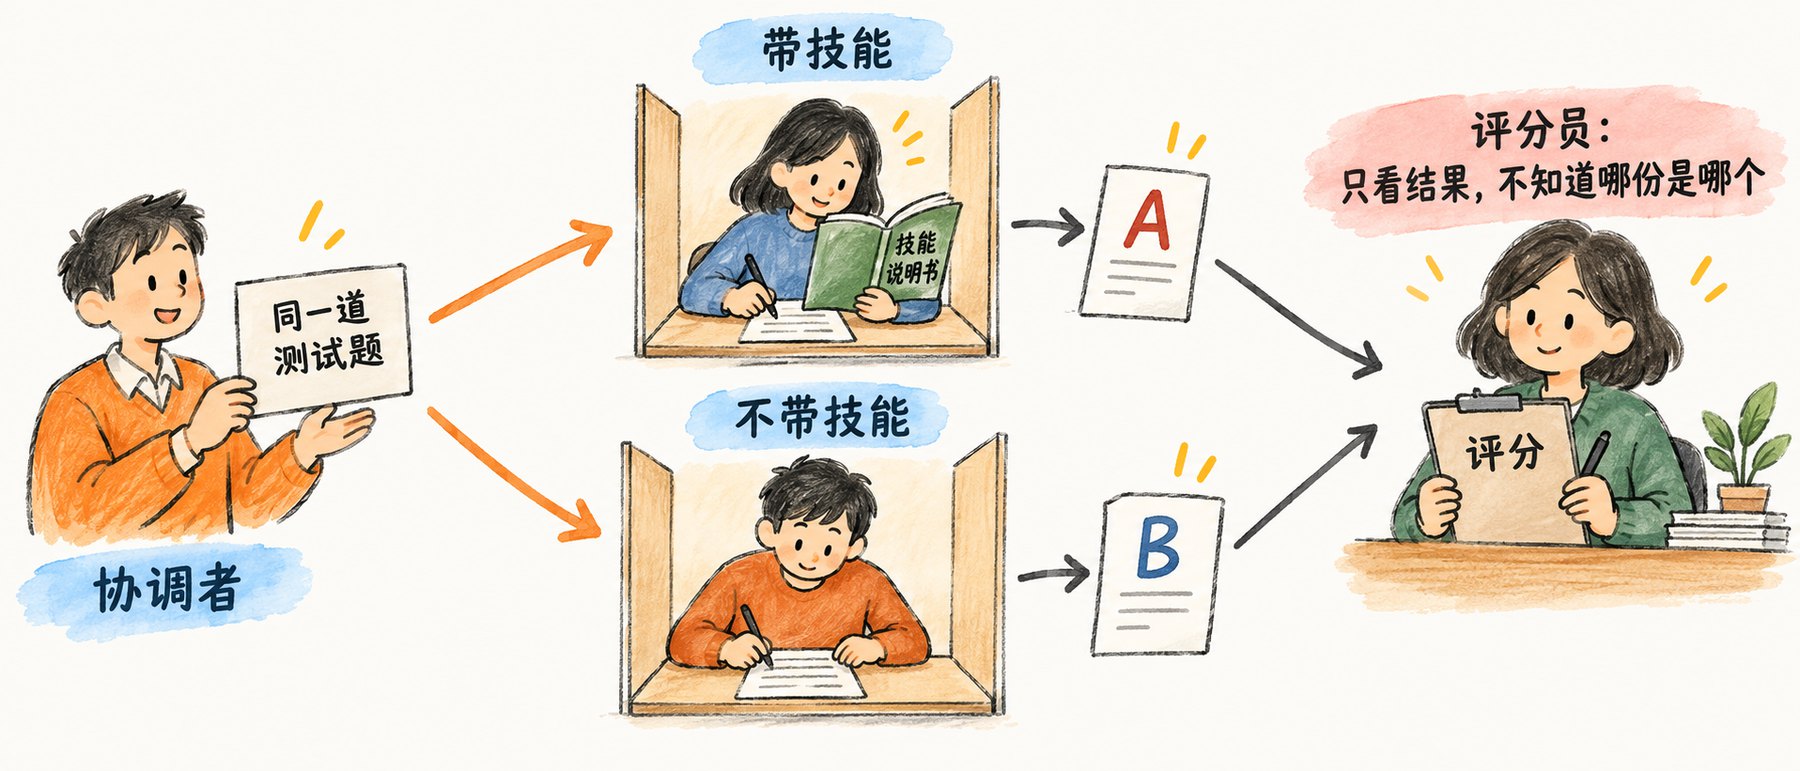
盲评员agents/comparator.md拿到标成 A、B 的两份输出,不知道各是怎么做的,判哪份更好
分析员agents/analyzer.md盲评之后揭开 A、B 各是谁,看赢的为什么赢,给输的提改法
测一个技能,它同一轮派两个子代理,一个带技能、一个不带,跑完交评分员判;要严格比两版,再上盲评员和分析员。分成三个文件,是因为三者该看的东西不一样。盲评员只拿 A、B 和任务说明,看不到技能和执行记录,才不偏向哪一版;分析员要讲清赢在哪,就得看技能和记录。
Anthropic skill-creator
练习二 · 第二段 · 盲评一句话就能派出去
最后一个小练习,请盲评员比两张表
提示词要说清什么
- 把
output/一个人干/汇总表.md 和 output/分头干/汇总表.md 拷成 output/盲评/A.md、B.md,谁当 A 随意。拷之前看一眼两张表里有没有写来历,比如注明取自提取表,有就在 A、B 里删掉
- 派一个子代理,照
参考/comparator.md 盲评
- 不告诉它哪份是怎么来的,任务说明只给组长的四个问题
- 结果写到
output/盲评/结果.md
做到什么算数
- 派给盲评员的话里没说哪份是怎么来的
- 它判了谁赢
- 理由能落到具体格子,哪家、哪一项
- 你把它的判断跟自己在
output/我的判断.md 里写的对一下
做完多出这几样
output/盲评/A.md、B.md、结果.md
开工前comparator.md 是 skill-creator 自带的盲评员说明,在材料包 03_skill-creator的盲评员/ 里,拷进项目的 参考/。