金融AI智能体设计与应用 · 第 6 次课 · 下午
01 — 23
序 · 开场
中山大学岭南学院 · 张一帆
+
+
01 序 · 开场
←
→
金融硕士选修课 · 第 6 次课 · 下午 · 2026-10-21 · 东2-304
两种知识库
下午 · 问的时候去找,还是来的时候就编
张一帆
AI 岭南学院
序 开课先说清楚 · 今天怎么走
下午讲两种知识库 ,晚上让它自己动
I
文字怎么变成数
词向量、余弦,拿笔跟着算
机器比的不是字,是一串数之间的夹角 。会算夹角,后面的 RAG 就看得懂。
II
第一种知识库 · RAG
问的时候去找
资料平时切好堆着,你一问,才去捞最像的几段 。
练习一 · 30 家银行年报
III
第二种知识库 · LLM Wiki
来的时候就编
资料一来就编进条目、改好索引,问的时候顺着索引翻 。
练习二 · 个人知识库
序 今天的例子反复用到两个指标
净息差和净利差,差一个字,不是一回事
净息差
也叫净利息收益率 · NIM
利息净收入 ÷ 生息资产平均余额
农行 2025:5,695.94 亿 ÷ 44.63 万亿 ≈ 1.28%
每 100 元生息资产(贷款、债券、存在央行和同业的钱),一年净赚多少利息。
净利差
Net interest spread
生息资产平均收益率 − 付息负债平均付息率
农行 2025:2.69% − 1.53% = 1.16%
收进来的平均利率减去付出去的平均利率,只比利率,不管规模。
净息差比净利差高,是因为农行付息负债平均 41.35 万亿,比生息资产少 3 万多亿。差的这块靠股东的钱和不付息的负债撑着,不用付利息 。
巨潮资讯网 农业银行 2025 年年报,原报告第 11 页(指标注释)、第 25 页(利息净收入)、第 26 页(平均余额与收益率表)
序 先看今天的资料有多大
资料多到放不进去,更麻烦的是每次从头读
334万字
30 家 A 股上市银行 2025 年报
250万 token
用 bge-m3 的分词数,是约数
放不进 约 250 万 token,比主流模型的窗口都大。就算放得下,放得越多,注意力摊得越薄 。
有截止日 2025 年报是 2026 年才披露的。训练之后才出来的,它不知道 ,只能你给。
每次从零读 今天翻完 30 份找净息差,明天新开会话问不良率,又得从头翻一遍 。
巨潮资讯网 30 家银行 2025 年报,原报告第 3 页到财务报告之前 · token 数与段数:bge-m3 建库,教师机 2026-10-19 实测 · Liu et al., Lost in the Middle, TACL 2024
序 读过的东西怎么攒下来 · 两种办法
两种知识库:问的时候去找,来的时候就编
RAG · 问的时候去找检索增强生成 · 第二部分,练习一
LLM Wiki · 来的时候就编像百科那样一页一页 · 第三部分,练习二
什么时候干活
你问的那一刻,现去捞
资料进来的时候,就编好
怎么找到
比像不像,挑出和问题最像的几段
先读索引,顺着目录翻到那一页
放进来的是什么同一问 · 农业银行 2025 年的净息差是多少?
农业银行 2025 年报 · 第 26 页 · 相似度 0.777 ……净利差 1.16 1.27 净利息收益率 1.28 1.42……
农业银行 2025 年报 · 第 25 页 · 相似度 0.776 ……净利息收益率1.28% ,净利差1.16%……
原文切下来的碎片。第 26 页那段是半张表,哪个数才是要的净息差,它当场判断 。
条目 · 净息差 · 整页
农业银行 1.28% 原文叫净利息收益率[第 25 页]
……其余 29 家,一家一行,每个数带页码
事先编好的一页。叫法不同也归到这一页,农行那行写明原文叫什么、在第几页 。
左栏两段取自练习一 检索.py 按意思检索的真实输出(BAAI/bge-m3),输出里叫余弦,这里先叫相似度,教师机 2026-10-19 实测;右栏是示意
I
PART I · 第一部分 · 文字怎么变成数
文字怎么
机器比的不是字,是一串数之间的夹角
I 计算机只认数
一段话,就是 one-hot 加起来
词典 5 个词 · 每个词换成 5 个数,只有自己那一位是 1
货币政策 稳健 灵活 适度 利率
货币政策 1 0 0 0 0 稳健 0 1 0 0 0 灵活 0 0 1 0 0 适度 0 0 0 1 0 利率 0 0 0 0 1
只是编了号 这叫 one-hot。中文常用词五到十万个,每个词就是五到十万个数,几乎全是 0。哪两个词像,这张表里看不出来。
两段央行摘要 · 分好词
文档 1 货币政策 稳健 灵活 适度 货币政策 稳健
文档 2 利率 稳健 适度 利率 利率
每个词一行 one-hot,竖着加,就是矩阵的一行
文档-词矩阵 货币政策 稳健 灵活 适度 利率
文档 1 2 2 1 1 0 文档 2 0 1 0 1 3
词序丢了 央行 降息 和降息 央行 加出来是同一串数。所以这种表示叫词袋 ,词倒进袋子里只数个数,不管先后。
I 两串数像不像
比两支箭头的夹角
cos(a , b ) =a · b ‖a ‖ ‖b ‖
点积 a · b = a 1 b 1 + a 2 b 2 + … + an bn 对应位置相乘,再相加
模长 ‖a ‖ = √a 1 ² + a 2 ² + … + an ² 各位平方,加起来,再开方
词频向量只在这一块
a
b
同向 · 0°
cos = 1
垂直 · 90°
cos = 0
反向 · 180°
cos = −1
词频向量落在 0 到 1 词频都不小于 0,箭头全在第一象限,夹角不超过 90°,余弦就在 0 和 1 之间。
只看方向,不看长度 一篇报告整篇复制一遍,词频全部翻倍。箭头变长,方向没变,余弦不变 。长报告和短报告能放在一起比。
模长是 1,距离和余弦一回事 ‖a − b ‖² = ‖a ‖² + ‖b ‖² − 2a ·b = 2 − 2cos(a , b ) 。按距离排和按余弦排,顺序一样 。bge-m3 给的向量,模长就是 1。
I 手算一 · 拿笔跟着算
两段央行摘要,余弦 0.286
把上一页两行抄下来,再添三行
货币政策 稳健 灵活 适度 利率 加起来
d 1 2 2 1 1 0 d 2 0 1 0 1 3 d 1 × d 2 0 2 0 1 0 3 d 1 ²4 4 1 1 0 10 d 2 ²0 1 0 1 9 11
1 点积 2×0 + 2×1 + 1×0 + 1×1 + 0×3 = 3
2 模长 ‖d 1 ‖ = √4+4+1+1+0 = √10 ≈ 3.162 ‖d 2 ‖ = √0+1+0+1+9 = √11 ≈ 3.317
3 余弦 3 ÷ (√10 × √11) = 3 ÷ √110 ≈ 3 ÷ 10.488 ≈ 0.286
换成 one-hot,再算一对词 货币政策 [1,0,0,0,0],稳健 [0,1,0,0,0]。点积 1×0 + 0×1 + 0×0 + 0×0 + 0×0 = 0,余弦 0 ÷ (1×1) = 0。货币政策和美食算出来也是 0。任意两个不同的词,都一样不像。
I 词袋哪里会看错
只认字面,三种情况会看错
哪一种 甲 · 分好词 乙 · 分好词 实际 词袋余弦 嵌入 · 待揭晓
同义不同词 线上 信贷 撮合 风控 服务 网络 借贷 信用 风险 管理 平台 同一门生意 0没有一个词相同 ? 同一指标换叫法 农业银行 净息差 收窄 农业银行 净利息收益率 下降 说的是一件事 0.3331 ÷ (√3 × √3) ? 语序 经济 增速 放缓 但 通胀 可控 通胀 放缓 但 经济 增速 可控 意思不同 1.000六个词一个不差 ? 否定 央行 不会 降息 央行 将会 降息 意思相反 0.6672 ÷ (√3 × √3) ?
今天的真问题就是第二行 农业银行 2025 年年报里,净息差一次都没出现 ,只写净利息收益率。30 份年报里 27 份写了净息差。农业、光大、杭州三家一次没写。沪农商行只在第 23 页讲行业形势时提过一次,自己的指标叫净利息收益率。按字面找净息差,这几家都对不上。
30 家银行 2025 年年度报告原文,巨潮资讯网;教师机 2026-10-20 核对原件
I 换个思路 · 看邻居
遮住一个词,让模型从邻居猜它
J. R. Firth · 1957
You shall know a word by the company it keeps.
一个词的意思,看它常和哪些词一起出现。
例句 · 农业银行 2025 年年报第 25 页
…… 受 LPR 下调 、 市场利率 低位运行 等 ……
遮住下调,你也猜得出来 前面是 LPR,后面是市场利率低位运行,空里多半是下调。Word2Vec 学词,学的就是这种猜法。
邻居差不多的词,数也调得差不多 词向量就是这么猜出来的。
怎么学出来 · Word2Vec 的 CBOW
1 先发一串随机的数 词表里每个词先随手给几百个数,这时谁跟谁都不像。
2 遮住一个,用邻居猜 受 LPR ? 市场利率 低位运行 → 猜 下调
3 猜错了就调 把这几个词的数往猜对的方向挪一点。读完几十亿个词才算调好。
Skip-gram 反过来 拿下调去猜四个邻居。慢一些,生僻词学得更好。
Firth, A Synopsis of Linguistic Theory 1930–1955, 1957;Mikolov et al., Efficient Estimation of Word Representations in Vector Space, 2013
I 点一个词试试
每个词,是意思地图上的一个点
第一维 12.1%
第二维 7.7%
降息 加息 降准 宽松 紧缩 央行 美联储 逆回购 净息差 净利息收益率 净利差 不良贷款率 拨备覆盖率 资本充足率 信用风险 违约 逾期 坏账 商业银行 证券公司 保险公司 基金公司 大模型 人工智能 智能风控 数字化转型 苹果 香蕉 足球
两维只留了约 20% 的差异,图上挨着的不一定真近,远近以右边的余弦为准 。
选中的词
净息差
1024 维里离它最近的三个 · 余弦
1 净利差 0.89
2 净利息收益率 0.81
3 不良贷款率 0.69
银行指标 货币政策 风险 金融机构 科技 无关
加息和降息,反义词也挨着 · 0.69 它们常出现在一样的句子里。近,不等于同义 。
苹果离人工智能最近 · 0.59 足球离人工智能也有 0.57。单个词的余弦差零点零几,别读太多。
教师机 2026-10-19 实测,BAAI/bge-m3;29 个词各 1024 维,用 PCA 压到两维画图;重合的点错开了一点
I 练习一第一步的预告
净息差离净利差,比离它的同义词还近
终端 · 练习1_RAG
$ python 相似度.py 净息差 净利息收益率 净利差 不良贷款率 拨备覆盖率 降息
净息差 净利息 净利差 不良 拨备 降息
净息差 1 0.812 0.892 0.690 0.540 0.684 净利息收益率 0.812 1 0.731 0.664 0.543 0.641 净利差 0.892 0.731 1 0.616 0.491 0.577 不良贷款率 0.690 0.664 0.616 1 0.626 0.670 拨备覆盖率 0.540 0.543 0.491 0.626 1 0.562 降息 0.684 0.641 0.577 0.670 0.562 1
终端 · 练习1_RAG
$ python 相似度.py 净息差 净利息收益率 --细节
每个词换成了 1024 个数。
「净息差」前 5 个数:
  -0.0428,-0.0130,-0.0149,-0.0226,-0.0241 ……
「净利息收益率」前 5 个数:
  -0.0612,-0.0041,-0.0054,-0.0050,-0.0451 ……
点积 = 对应位置相乘再加起来 = 0.8120
模长 = 各位置平方和再开方:
  |净息差| = 1.0000,|净利息收益率| = 1.0000
余弦 = 点积 ÷ (模长 × 模长) = 0.8120 ÷ (1.0000 × 1.0000) = 0.8120
0.892 比 0.812 还近 净利息收益率才是净息差的同义词。净利差离净息差反而更近,多半因为年报里这两个词常并排出现。模长都是 1,余弦就是点积 。
材料包预先算好的向量(BAAI/bge-m3),没有 key 跑出来数一字不差;有 key 现算,第三位小数可能差 1
I 方向也带意思
词向量还能做加减
man
woman
king
queen
woman − man
同一支箭头,挪到 king 上
king − man + woman ≈ queen
右边是 bge-m3 实测。三个向量加减,结果单位化,再和候选池里 30 个词逐个算余弦,式子里用过的三个词不算 。
央行 − 中国 + 美国
美联储 0.690 日本央行 0.652 欧洲央行 0.639
第一就对
北京 − 中国 + 日本
东京 0.701 大阪 0.651 日本央行 0.582
第一就对
人民币 − 中国 + 日本
美元 0.662 日元 0.651 日本央行 0.636
日元第二
降息 − 宽松 + 紧缩
降准 0.655 加息 0.527 缩表 0.456
加息第二
Mikolov, Yih & Zweig, Linguistic Regularities in Continuous Space Word Representations, NAACL 2013;Mikolov et al., arXiv:1301.3781, 2013;右栏为教师机 2026-10-19 实测,BAAI/bge-m3
I 从词到一段话
取平均有硬伤,句向量每段各编一次
老办法 · 取词向量的平均
d =1 n v 1 + v 2 + … + vn )
一段话是一片词云,取平均就是取质心。
三个硬伤,顺序丢了,否定几乎看不出,长段被稀释 。
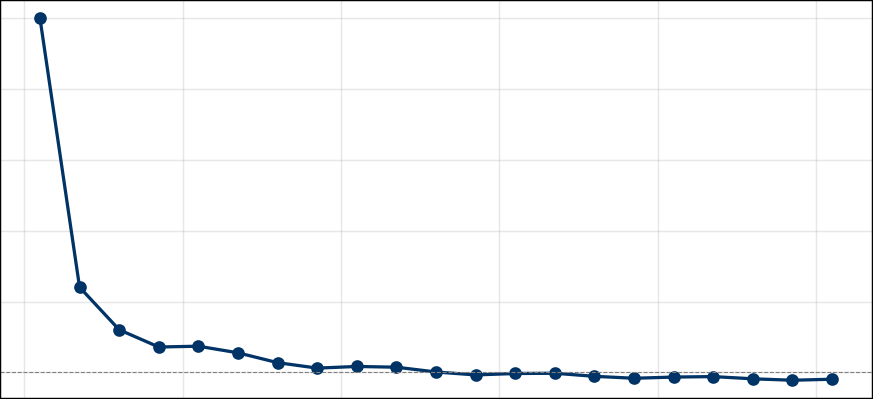
和宽松的余弦
1.0 0.9 0.8
0.7 0.6 0.5
0 20 40
60 80 100
文档里的词数
从宽松一个词起步,和宽松的余弦是 1。每加 5 个无关高频词,余弦一路掉,约 100 个词时约 0.49。
原始 BERT · 两句拼起来一起过模型
句 A + 句 B → BERT → 一个分数
一万句里找最像的一对,要比约 5000 万对,约 65 小时 。
SBERT · 每句各自编码一次
句 A → BERT → 向量 A
句 B → BERT → 向量 B
算余弦
向量存起来,比的时候只算余弦。同样的活,约 5 秒 。
今天的嵌入接口都走第二条路 · 以 bge-m3 为例
一段最长8192 token,换成1024 个数,模长1
农业银行 2025 年净利息收益率为 1.28% → [−0.0471, 0.0002, …]
本科《经济金融文本分析》第 8 章实验,Word2Vec 词向量取平均;Reimers & Gurevych, Sentence-BERT, EMNLP 2019;BAAI/bge-m3 模型卡;向量为教师机 2026-10-19 实测
I 揭晓词袋那页的最后一列
同义好多了,语序和否定没修好
哪一种 甲 乙 词袋 嵌入 · bge-m3
同义不同词 线上信贷撮合风控服务 网络借贷信用风险管理平台 同一指标换叫法 农业银行净息差收窄 农业银行净利息收益率下降 语序 经济增速放缓但通胀可控 通胀放缓但经济增速可控 否定 央行不会降息 央行将会降息 对照 央行将会降息 今天食堂的米饭很好吃
同义好多了 没有一个词相同的两句,从 0 升到 0.681。净息差对净利息收益率那一对,从 0.333 升到 0.809。
语序、否定没修好 意思不同、甚至相反的两句,嵌入给出 0.991 和 0.859。它只管意思挨得近不近。
只看排序 不相干的两句也有 0.452。余弦的绝对值没有统一刻度,谁排在前面才有用 。
教师机 2026-10-19 实测,BAAI/bge-m3;词袋按前面三种失效那页的分词算
I 本课实测 · 一段该切多长
段太长,对的那段就挑不出来
0.40
0.45
0.50
0.55
0.60
0.65
0.70
209
300
600
1000
1500
2500
4000
6000
段的字数(对数刻度)
和问题的余弦
练习一每段约 600 字
0.666
0.427
0.643
0.568
差 0.24
差 0.08
含答案的段
不含答案的段
含答案的段 农行第 25 页利息净收入那段,连小标题 209 字,里面有净利息收益率1.28%。后面接上同一份年报里不带息字的文字,一直接到 6000 字。
切成约 600 字一段的一个理由 209 字时两段差 0.24,6000 字时只差 0.08。段越长,对的那段越难跟别的段拉开。
教师机 2026-10-19 实测,BAAI/bge-m3
I 金融研究里的余弦
年报文字里,读得出谁和谁是同类
上海 中信 中国 交通 光大 兴业 农业 北京 华夏 南京 宁波 工商 常熟 平安 建设 成都 招商 杭州 民生 江苏 沪农商行 浙商 浦发 渝农商行 苏州 邮储 重庆 长沙 青岛 齐鲁
渝农商行 点一家看近邻 重庆银行0.559 沪农商行0.410 农业银行0.281
六大行 股份行 城商行 农商行
JPE 2016 Hoberg & Phillips · 用 10-K 找同业(TNIC) 左图拿 30 家银行照做。每家段落向量取平均,减去 30 家的平均 ,再两两比。
JFE 2025 Breitung & Müller · GPT-3 写的业务描述换成嵌入
三个检验 嵌入 作者的词袋
按同业做多空,等权月度七因子 α(美国) 146 bps 119 bps 10-K 写明的竞争者,前 100 家找回几成(美国) 47.7% 32.8% 后来的并购对象,落在前 100 家里几成(全球) 49.7% 17.7%
用整份 10-K 做的 TNIC,在美国仍略胜。嵌入的长处是能做到全球 。
Hoberg & Phillips, JPE 124(5), 2016;Breitung & Müller, JFE 166 (2025) 104007,第 2.5 节、第 3 节、表 4、6、7、图 7,检验一栏嵌入是 OpenAI 的大号嵌入模型;地图为教师机 2026-10-19 实测,BAAI/bge-m3,两维只留约 16% 的差异,重合的点错开了一点
II
PART II · 第二部分 · 第一种知识库
RAG
问的时候去找。资料平时切好堆着,你一问,它才去捞最像的几段
II RAG 是什么 · 用练习一的数走一遍
搭一个 RAG,五步
资料进来时,做一次
每问一次,做一遍
01 · 切块
7638段
30 份年报先按页分开,长的页再切成约 600 字一段。前后两段重叠两行 ,免得一句话被切断。
每段前面加一行哪家银行、第几页 ,切开也认得出是谁家。这是 Anthropic 上下文检索最省事的版本。
02 · 嵌入
1024个数
每段发给硅基流动的 bge-m3,换成 1024 个数。全库约 250 万 token,335 秒 ,模型免费。
库是哪个模型建的,问题就用哪个模型换向量 。
03 · 入库
26MB
向量存进 向量.f16,15.6 MB。原文存进 段落.json,10.5 MB。两个文件就是向量库。
04 · 检索
前 5段
问题也换成 1024 个数,和 7638 段逐一算余弦 ,取最像的 5 段。约 2 秒。
05 · 增强与生成
5 段+问题
把这 5 段拼进提示词,让模型照着答、标出处 。练习一里这一步交给 Claude Code。
Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, NeurIPS 2020;Anthropic · Introducing Contextual Retrieval,2024-09-19
II 检索.py 能怎么找
同一批段落,两种排法
按意思 默认
python 检索.py "问题"
问题 → bge-m3 换成 1024 个数 → 和 7638 段各算余弦 → 最大的 5 段
余弦 = a ·b ÷ (‖a ‖ × ‖b ‖)就是第一部分那个夹角,越接近 1 越像
比意思像不像。 换个叫法也找得到,要 key。
按字 BM25
python 检索.py "问题" --按字
问题 → 拆成两字一组 → 数每组在段里出现几次 → 得分最高的 5 段
得分 = Σ 稀有度 × 出现次数越少段落有这组字,稀有度越高;次数越多,加得越慢
比字面重不重合。 不用向量、不要 key,字面不同就找不到。
两种都能加 --公司 招商银行 先圈出这一家再排-k 8 取 8 段,默认 5 段
练习1_RAG/检索.py;BAAI/bge-m3 模型卡;Robertson & Zaragoza, The Probabilistic Relevance Framework: BM25 and Beyond, 2009
II 检索 · 第一问,按意思
问净息差,捞回来的是净利息收益率
终端 · 练习1_RAG
> python 检索.py "农业银行 2025 年的净息差是多少?"
问题:农业银行 2025 年的净息差是多少?
找法:按意思(BAAI/bge-m3 余弦) | 范围:全部 7638 段 | 取前 5 段 | 用时 1.7 秒
[1] 余弦 0.777 | 出处:农业银行 2025 年年度报告 · 原报告第 26 页
……净利差 1.16 1.27 净利息收益率 1.28 1.42……
[2] 余弦 0.776 | 出处:农业银行 2025 年年度报告 · 原报告第 25 页
…… 净利息收益率1.28% ,净利差1.16%,分别下降14 个和11 个基点……
[3] 余弦 0.761 | 出处:农业银行 2025 年年度报告 · 原报告第 25 页
[4] 余弦 0.745 | 出处:农业银行 2025 年年度报告 · 原报告第 10 页
[5] 余弦 0.742 | 出处:农业银行 2025 年年度报告 · 原报告第 39 页
读进向量库 7638 段原文,每段 1024 个数问题换成向量 发给硅基流动,一次请求,回来 1024 个数逐一算余弦 在你自己电脑上,问题和 7638 段各比一次排序取前 5 连同出处打印出来,交给 Claude Code 去答
终端输出摘录,段落正文截短 · BAAI/bge-m3(硅基流动),教师机 2026-10-19 实测
II 先猜再看 · 同一问,换成按字找
不按意思,按字能不能找到?
终端 · 练习1_RAG
> python 检索.py "农业银行 2025 年的净息差是多少?" --按字 按字(BM25):问题拆成两字一组,去每段里数。
农业 业银 银行 2025 年的 的净 净息 息差 差是 是多 多少
先猜一下
按字排出来的前五段里,有几段是农业银行的?
五段都是 两三段 一段也没有
1 ??? 原报告第 ? 页 2 ??? 原报告第 ? 页 3 ??? 原报告第 ? 页 4 ??? 原报告第 ? 页 5 ??? 原报告第 ? 页
点一个答案揭晓
揭晓 · 一段农行都没有
1 上海银行 · 第 24 页 关于净息差,本集团 1.16% 17.314 2 民生银行 · 第 19 页 本集团净息差 1.40% 16.965 3 华夏银行 · 第 10 页 注释,净息差又名净利息收益率 15.829 4 建设银行 · 第 16 页 董事长致辞 15.369 5 渝农商行 · 第 73 页 关于净息差 14.898
农行年报里一次都没写净息差。
检索输出与余弦:BAAI/bge-m3,教师机 2026-10-19 实测;各家写法:巨潮资讯网 30 家银行 2025 年报原件
II 第二问 · 招商银行 2025 年末信用卡贷款不良率是多少
找对了银行,不等于拿到答案
按字--按字 · BM25 得分
第 5
招行第 32 页,这张表被切断的后半段 。
按意思bge-m3 余弦
第 1
招行第 32 页,讲的是零售贷款 1.06% 。
本集团 · 按产品类型 2025 年 12 月 31 日 2024 年 12 月 31 日 金额 占比% 不良额 不良率% 金额 占比% 不良额 不良率%
个人住房贷款 1,425,236 19.64 7,231 0.51 1,417,450 20.58 6,840 0.48 信用卡贷款 939,115 12.94 16,373 1.74 947,843 13.76 16,560 1.75 消费贷款 426,653 5.88 4,349 1.02 396,161 5.75 4,116 1.04
人民币百万元
检索输出:教师机 2026-10-19 实测 · 表:招商银行 2025 年度报告(A 股)第 32 页,巨潮资讯网
II 第三问 · 30 家里,2025 年末不良贷款率最低的是哪家
要比 30 个数,前 5 段装不下
按意思捞回来的前 5 段,30 家里只碰到 4 家
工商 农业 中国 建设 交通 邮储 招商 兴业 中信 浦发
民生 光大 平安 华夏 浙商 北京 上海 江苏 宁波 南京
杭州 成都 长沙 重庆 青岛 苏州 齐鲁 渝农商 沪农商 常熟
只凭这 5 段,会答成杭州 0.76% 或邮储 0.54%,都错 。
答案是成都银行 0.68%。
找片段这件事,有三个天生的毛病
切块断裂 一张表切成两段,后半段看不出是哪一类、哪一年 。
检索输出:BAAI/bge-m3,教师机 2026-10-19 实测 · 各家不良贷款率:巨潮资讯网 30 家银行 2025 年报原件
II 回头看 · 你天天用的 Claude Code
Claude Code 自己,不用向量检索
Boris Cherny · Claude Code 作者 · X · 2026-02-01
Early versions of Claude Code used RAG + a local vector db, but we found pretty quickly that agentic search generally works better. It is also simpler and doesn't have the same issues around security, privacy, staleness, and reliability.
Claude Code 早期版本用过 RAG 加本地向量库,我们很快发现,让它自己去搜(agentic search)总体效果更好。这样也更简单,没有安全、隐私、内容过时、可靠性那些麻烦。
它自己 grep、翻文件,再靠一份目录
CLAUDE.md 每次启动全文读总规矩,目录的封面
子目录的 CLAUDE.md 碰到那个目录的文件时才读翻到哪一章,才看那一章的导语
Claude Code 不做向量化。Anthropic 不提供嵌入模型 ,DeepSeek 的接口文档里也没有嵌入(embeddings)接口。
Boris Cherny,X,2026-02-01,x.com/bcherny/status/2017824286489383315;Hacker News 2025-02-24,item 43164253
II 你手边的 RAG · 嵌入放在哪做
这些软件的知识库,五步藏在界面后面
软件 五步在哪 按字还是按意思
Cherry Studio 新建知识库时选嵌入模型,切块、嵌入、入库它替你做 选了嵌入模型,按字和按意思一起找,再合并 Dify 分段就是切块,高质量索引就是嵌入加入库 高质量档按意思找,经济档按关键词找 扣子 第 5 次课那张扣子画布上,有一个知识库节点,管检索资料 打开它的知识库设置,对着今天的五步认一认
嵌入这一步放在哪做
云端 · 硅基流动 BAAI/bge-m3课上用
不装包,注册、实名认证、建 key。免费模型,30 家全量 335 秒 ,约 250 万 token。
本机 · fastembed、Ollama、sentence-transformers
要装包、下模型,模型小的约 0.09 GB,大的几百 MB 起。课上不装 ,91 人同时下模型,教室网络扛不住。
2026-10-20 查:Cherry Studio 文档「知识库」「嵌入模型」;Dify 文档「指定索引方式与检索设置」;硅基流动价格页(BAAI/bge-m3 免费)、限速说明(实名认证后使用全部的免费模型);fastembed Supported Models;Ollama library qwen3-embedding
练习一 · RAG · 30 家银行年报 练习页 · 提示词见学员实操页
用 RAG 答这几问,每个数带出处
热身 净息差和哪个词最近? 净利差、净利息收益率、不良贷款率……
第一问 农业银行 2025 年的净息差是多少? 按字、按意思各找一次,哪种找得到?
第二问 招商银行 2025 年末信用卡贷款不良率是多少? 找回来的那段里,有没有答案?
第三问 30 家里,2025 年末不良贷款率最低的是哪家? 检索为什么答不了?换什么办法?
加一份 招行 2026 半年报来了,追加进库要多久? 和建库那次比一比
II 练习一讲评 · 教师机的结果
和你的结果对一对
问题 检索排名 Claude Code 怎么答 答案,回原文核过
第一问 按字前五没有农行,加 --公司 也没有答案页。按意思,农行第 26、25 页排前三 约 30 秒,答 1.28%,说明原文叫净利息收益率 1.28%(第 11、25、26 页) 第二问 按字第 5,加 --公司 升到第 1。按意思第 32 页排第 1,但那段讲零售贷款 1.06%,1.74 在第 3 段(第 49 页) 答 1.74%,第 32、49 页两种口径都是 1.74% 1.74%(第 32 页表) 第三问 按意思前五只碰到 4 家,按字前五没有成都 约 85 秒,先说检索答不了,再搜 30 份文件,答出成都 0.68% 成都银行 0.68%(第 6、9 页)
第五步 --加 半年报节选,9 段、4772 字,约 1 秒、2826 token。建库那次是 335 秒、约 250 万 token。资料来一份加一份,不用重建。
教师机 2026-10-19 实测;Claude Code 一列是教师机试跑记录,秒数只作参考 · 答案:巨潮资讯网各家 2025 年报原件
III
PART III · 第三部分 · 第二种知识库
LLM Wiki
来的时候就编。资料一来就编进条目、改好索引,问的时候顺着索引翻到那一页
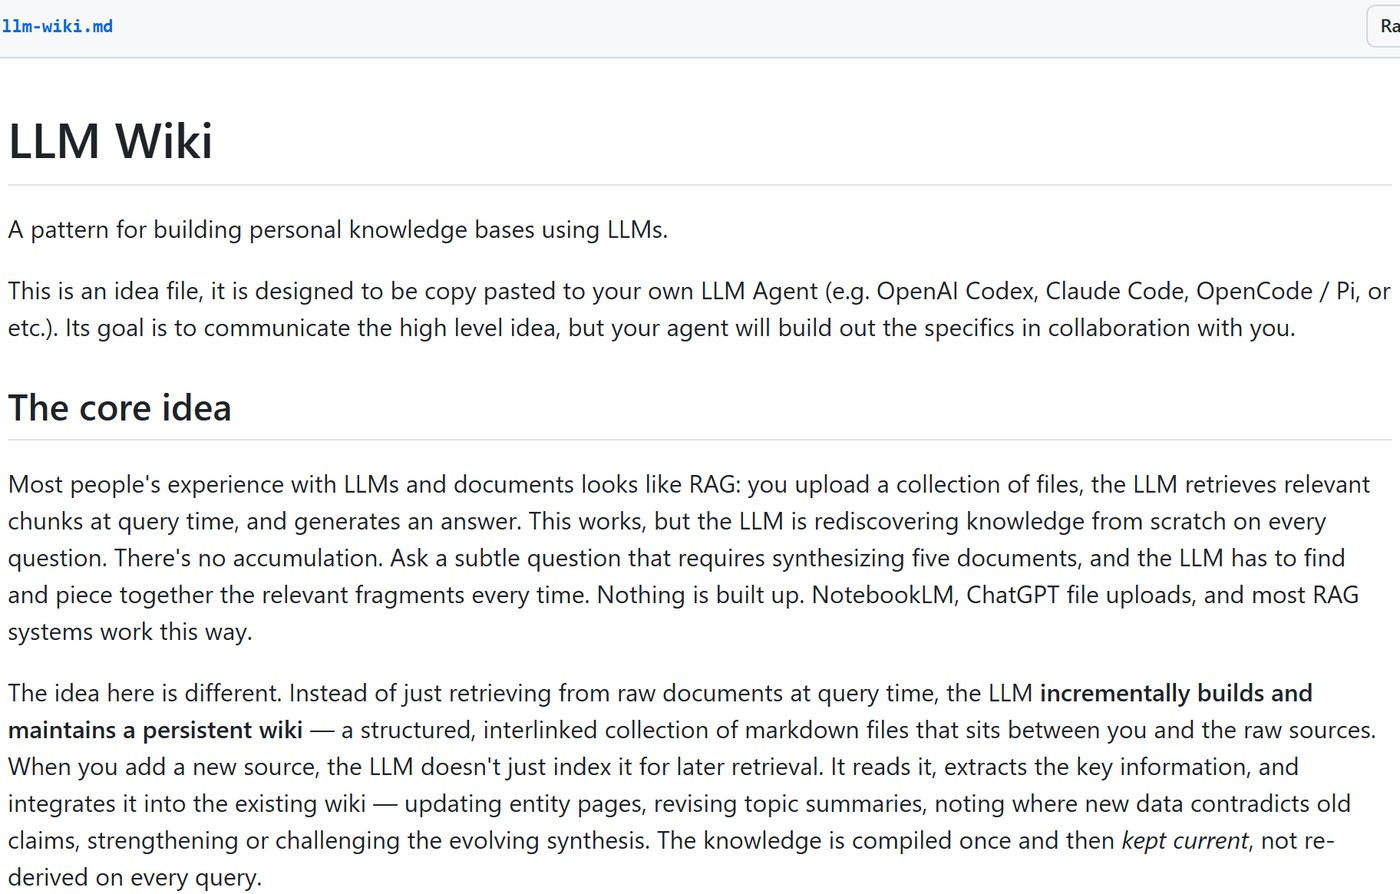
III 原始资料 · Andrej Karpathy
别每次现找,让它把资料编成一本 wiki
Andrej Karpathy · X · 2026-04-02
a large fraction of my recent token throughput is going less into manipulating code, and more into manipulating knowledge
我最近的 token,越来越少花在写代码上,越来越多花在整理知识上
~100 articles and ~400K words … I thought I had to reach for fancy RAG
一百来篇、四十万词,原以为得上一套正经的 RAG,结果没用上
约 2200 万次浏览,截至 2026-10-16
gist · karpathy/llm-wiki · 2026-04-04
The LLM is rediscovering knowledge from scratch on every question. There's no accumulation.
每问一次,模型都从头重新找一遍知识,什么也没攒下
This is an idea file, it is designed to be copy pasted to your own LLM Agent.
这是一份思路文件,直接贴给你自己的智能体用
两天后写成这份文件,后面几页的三层、三个动作都出自它
Karpathy 是 OpenAI 创始成员、前特斯拉 AI 负责人,LLM Wiki 这个叫法就从这里来。今天的 personal-wiki 技能,就是照这个思路写的 。
Karpathy, LLM Knowledge Bases, X, 2026-04-02, https://x.com/karpathy/status/2039805659525644595(浏览数截至 2026-10-16);Karpathy, llm-wiki, GitHub Gist, 2026-04-04, https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f;截图 2026-10-17
III 为什么以前做不成
难的不在读和想,在记台账
Karpathy · llm-wiki.md
The tedious part of maintaining a knowledge base is not the reading or the thinking — it's the bookkeeping.
维护知识库最烦人的,不在读,也不在想,在记账这类杂活。
以前 · 人来维护 上完一次课,得改好几处 第 6 次课讲完,课程安排那页添上今天两个练习,工具与操作那页添上硅基流动怎么建 key,作业与考核不变也得核一遍,索引跟着改,日志记一笔。维护的活比好处涨得快,人坚持不下去
现在 · AI 来维护 一份资料进来,改十几页也不烦 原文说一份资料可能牵动十到十五页,AI 来做,维护成本几乎是零。人挑资料、提问题、想清楚这些说明了什么,其余交给它
Karpathy, llm-wiki, GitHub Gist, 2026-04-04(Humans abandon wikis because the maintenance burden grows faster than the value;A single source might touch 10-15 wiki pages)
III LLM Wiki 长什么样
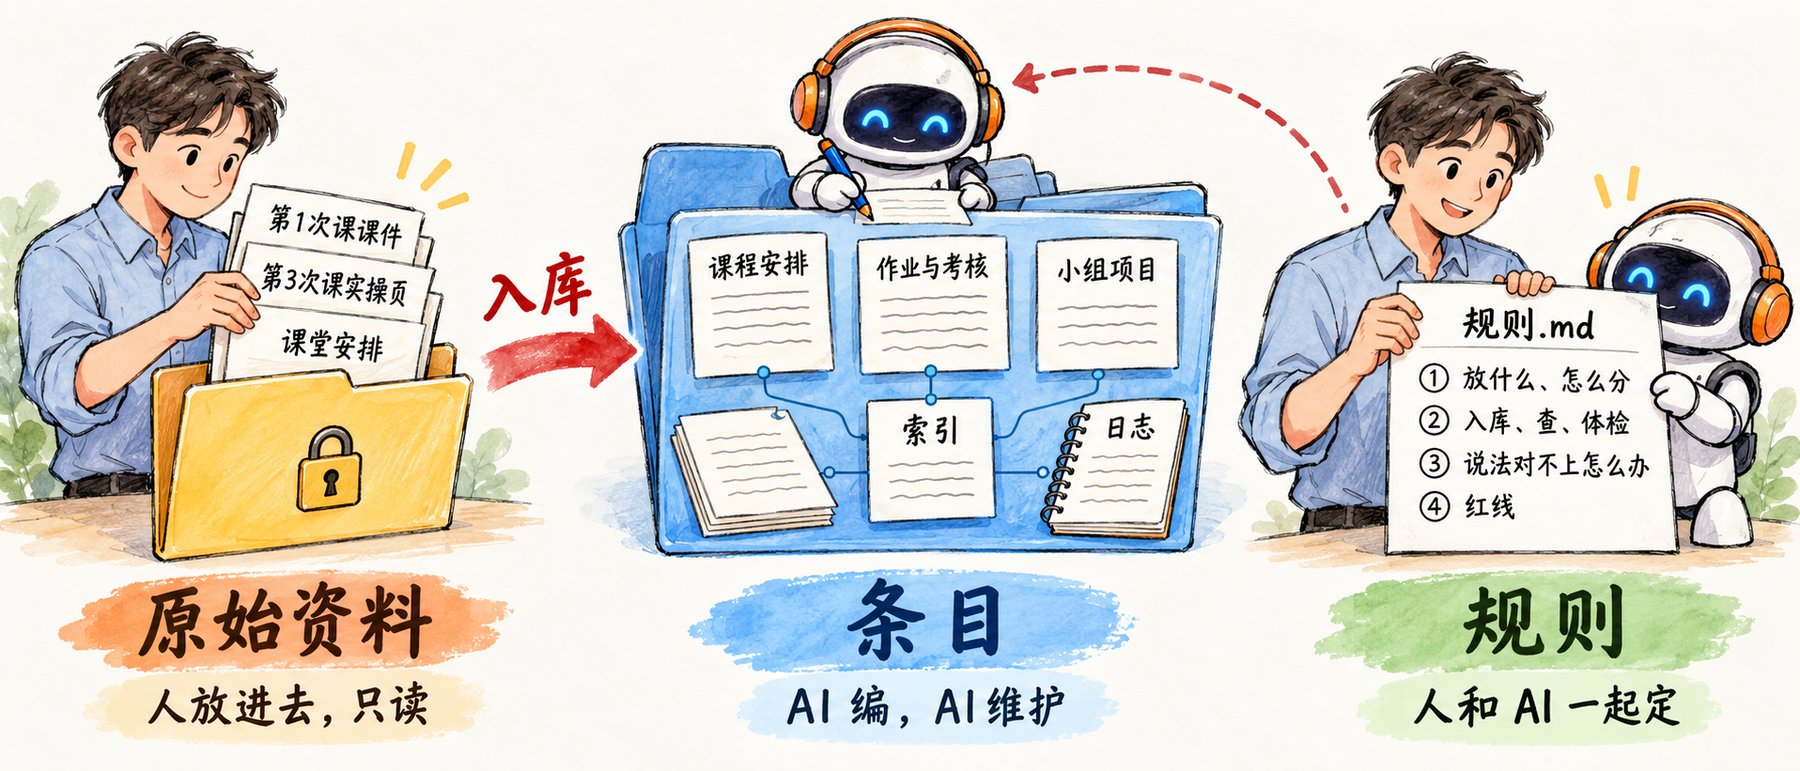
资料人放,页面它编,规矩一起定
原始资料(原件)· 只读 人放进去,AI 只读不改。今天是十份课程网页快照。怀疑哪句,回这里核
条目 · AI 编、AI 维护 Karpathy 叫它 wiki。按事一页一页写,比如课程安排、作业与考核,每句标出处。外加索引 每页一行,日志 按时间记每次改了什么
规则 · 一起定 CLAUDE.md 讲哪个文件夹放什么,规则.md 定条目怎么分、对不上听谁的。Karpathy 说,有了这份说明,AI 才像个守规矩的档案员
Karpathy, llm-wiki, GitHub Gist, 2026-04-04(Raw sources / The wiki / The schema;index.md、log.md)
III 日常就三个动作
入库、查询、体检
入库 · INGEST
来了一份新资料 读完,更新它牵动的每一页 ,和旧说法对不上的标出来,更新索引,在日志里记一笔
2-1、2-3 整理收件箱,2-4 记一下。第 1 次课课件写 19 组,第 5 次课课件写 21 组,整理时该标出来
查询 · QUERY
有人来问 先读索引,找到相关页面再答,标出处。答得好的,存回 wiki 里
2-2、2-5 新开会话问。库里没有的,要说没有
体检 · LINT
隔一阵扫一遍 找页面之间的矛盾、被新资料推翻的旧说法、没人引用的孤页 、提到了却没建页的
课上不做。课后说一句体检 ,它只列清单,不动手改。personal-wiki 的体检还查没写出处的句子
Karpathy, llm-wiki, GitHub Gist, 2026-04-04(good answers can be filed back into the wiki as new pages)
III 编出来的一页 · 2-1 之后
一页条目,句句指得回原件
学习/AI学习/金融硕士智能体课/课程安排.md 节选
# 课程安排
> 这页管什么:九次课各在哪天、讲什么。原件分了下午、晚上的才分开写
> 最近更新日期:2026-10-21
> 依据了哪几份原件:第1次课_课件.md、第4次课_课件.md、第5次课_课件.md 等
……第 1 到 5 次课五行略
- 第 6 次课 · 10 月 21 日 · 个人知识库与常驻智能体 [第1次课_课件.md 第 7 页]
- 第 8 次课 · 11 月 4 日 · 金融投资专题 [第1次课_课件.md 第 7 页]
- 第 9 次课 · 11 月 11 日全天 · 小组终期展示 [第1次课_课件.md 第 7、12 页]
- 上课地点东2-304 [第5次课_课件.md 第 1 页]
## 变更记录
(还没有)
问的时候先读索引,再翻到那一页
索引.md 一个条目一行
条目 一句话
课程安排.md 九次课各讲什么、哪天。第 8 次课 11 月 4 日…… 作业与考核.md 个人 50、小组 50…… 小组项目.md 带 AI 模块的网页,每组 4 到 5 人…… 工具与操作.md 练习里的命令和结果……
问第 8 次课做什么,它先读索引,找到课程安排那一行,再整页读。答 11 月 4 日,金融投资专题。课堂安排还没进库,答的是旧说法
III 新资料进来 · 2-3
一份课堂安排进来,改了哪几处
2-3 之前
课程安排.md
- 第 8 次课 · 11 月 4 日 · 金融投资专题 [第1次课_课件.md 第 7 页]
## 变更记录
(还没有)
索引.md · 同一次改了两行
| 课程安排.md | ……第 8 次课下午改企业讲座 | 10-21 |
| 小组项目.md | ……查资料的 AI 模块按三个问题选 | 10-21 |
日志.md · 末尾多一笔
## 2026-10-21 · 整理收件箱
读了:第6次课_课堂安排.md,挪进 原始资料/
改了:课程安排.md、小组项目.md、索引.md
对不上:第 8 次课,旧说法进变更记录
2-3 之后
课程安排.md 改了
- 第 8 次课 · 11 月 4 日 · 下午改为企业讲座分享,晚上照常上课 [第6次课_课堂安排.md]
## 变更记录
1. 第 8 次课
- 旧说法:8 | 11/4 | 金融投资专题 | 量化投资中的智能体;投资顾问与行业研究中的智能体与技能 [第1次课_课件.md 第 7 页]
- 新说法:第 8 次课(11 月 4 日)下午改为企业讲座分享,晚上照常上课。 [第6次课_课堂安排.md]
- 哪份改的:第6次课_课堂安排.md,10 月 21 日第 6 次课课上公布
变更记录只写三样,旧说法原话和出处,新说法原话和出处,哪份改的 。不写作废、应为这类判断。
III 说法对不上 · 技能里写好了
知识库的规则,不用你手写
.claude/skills/personal-wiki/SKILL.md 入库第 4 步
4. 说法对不上,分三种情况:
- 同一类来源,后发的改了先发的 (后一次课改了前一次课说的安排,新通知改了旧通知):正文改成新的,旧说法挪到这页末尾的「变更记录」。变更记录只写三样:旧说法原话和出处……、新说法原话和出处、哪份改的。
- 来源分高低 (规则.md 里写了以哪份为准):正文照高的写,低的写进「待核」。
- 分不出谁对 :不替用户挑,两种说法都写进「待核」,各写出处。
后发的改先发的 · 今天就碰上 第 6 次课课堂安排改了第 1 次课课件里第 8 次课的安排。正文写新的,旧说法进变更记录,写清哪份改的
来源分高低 · 收研究资料会碰上 规则.md 里写了,年报、公告原文高于券商研报,研报高于公众号转述。两份对不上,正文照原文,转述那句记进这页末尾的待核
分不出谁对 · 收研报会碰上 两家券商研报对同一家银行明年净息差的预测不一样。它不替你挑,两种都进待核,等你拍板
这类文件不用自己手写。技能里写好了通用做法,材料包里的规则.md 我起了头,以后加主题由它起草,你看过说可以再加。你不用会写员工手册的排版,但得知道手册里该有岗位职责、工作流程和红线 。
III 换成金融的例子 · 30 份年报
30 份年报,编成一张指标页
研究/上市银行2025年报/不良贷款率.md 示例 · 节选 · 按指标分页,要先在 规则.md 加一条
> 最近更新 2026-10-21 · 依据 30 份年报 · 从低到高排 [成都银行2025年报.md 第 17 页] ;各家取年报主要指标里的数,多数是集团口径
名次 银行 2025 年末 上年末 出处
1 成都银行 0.68% 0.66% [成都银行2025年报.md 第 6、9、16 页] 2 宁波银行母行口径 0.76% 0.76% [宁波银行2025年报.md 第 10、18 页] 2 杭州银行母行口径 0.76% 0.76% [杭州银行2025年报.md 第 15、17 页] 2 常熟银行 0.76% 0.77% [常熟银行2025年报.md 第 16、37 页] ⋯ 8 招商银行 0.94% 0.95% [招商银行2025年报.md 第 16、19 页] ⋯ 22 农业银行 1.27% 1.30% [农业银行2025年报.md 第 11、77 页] ⋯ 30 华夏银行 1.55% 1.60% [华夏银行2025年报.md 第 9、17 页]
宁波银行的表里叫不良贷款比率 [第 10 页]
招商银行本公司口径 0.93% [第 45 页]
第三问一眼答出 最低成都银行 0.68%,宁波、杭州、常熟 0.76% 并列其次,最高华夏银行 1.55%。RAG 答不了的比大小,编好一张表就答得了
RAG 为什么答不了 30 个数比大小,前 5 段装不下 。检索只管像,不管全
代价在编的那一次 30 份各翻一遍、各核一次,叫法和口径当场记下。新年报一来,这页跟着改
III 编出来的东西,也会错
编错一句,以后一直错
arXiv 2604.15597 · 2026-04-17
LLMs Corrupt Your Documents When You Delegate
Laban, Schnabel & Neville · 微软研究院
约四分之一
让前沿模型连着多轮改文档,结束时平均改坏约四分之一的内容 。
研究/上市银行2025年报/净息差.md 假设的例子
- 农业银行 2025 年净息差 1.16% [农业银行2025年报.md 第 25 页]
原始资料/…/农业银行2025年报.md · 原报告第 25 页 顺着出处一翻
……净利息收益率1.28%,净利差1.16% ,分别下降14 个和11 个基点……
这是假设的例子。1.16% 是净利差。前面讲过,净利差和净息差的向量挨得近。写进条目以后,每次问农行净息差,它都照这句答。
原件只读 出了事有底可查每句带出处 一翻就知道错在哪对不上进待核 不替你挑定期体检 扫矛盾、扫旧说法你来抽查 越笃定越要核
Laban, Schnabel & Neville, LLMs Corrupt Your Documents When You Delegate, arXiv 2604.15597, 2026-04-17;农业银行 2025 年年度报告第 25 页
III 真在用的
我的计量经济学 wiki,就是一个文件夹
我的《高级计量经济学》课程 wiki
我把 Karpathy 的原文交给 AI,让它自己搭
18 份课件 PDF,一次入库
43 页:讲次 17、概念 15、方法 11
1 份规则,照 Karpathy 的写
目录和规则我都没手写。
体检时
它指出两页写的同一个门槛数字不一样
一个是经验值,一个是查表值。它没替我判,只提醒我去核。
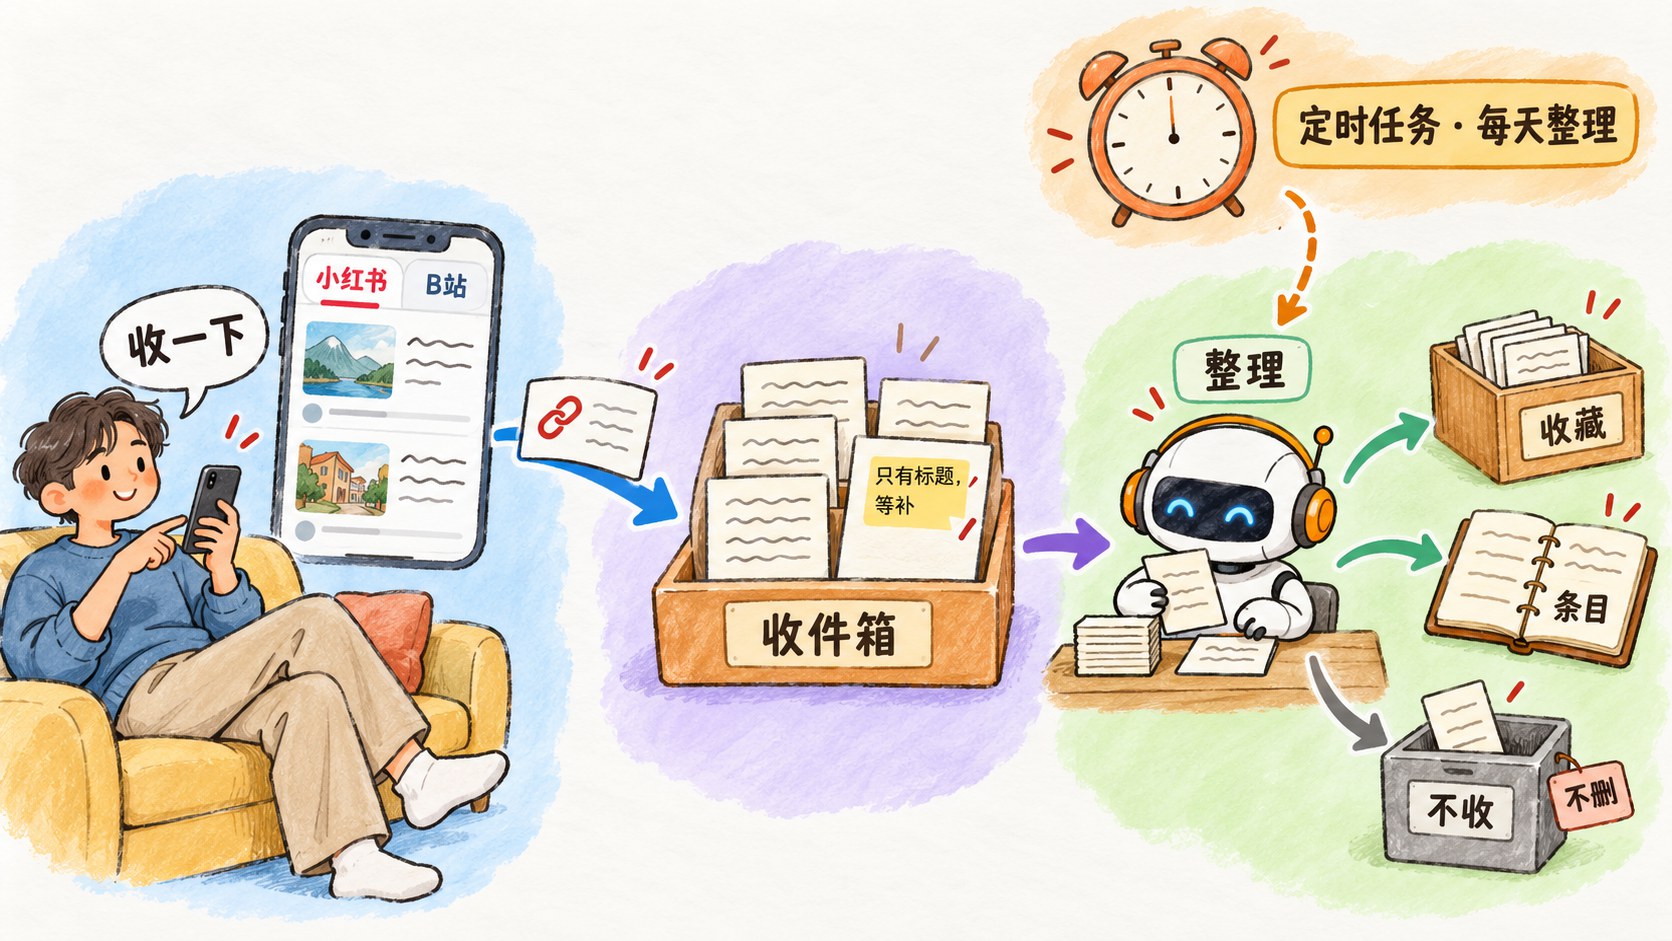
III 收件箱
刷到的先收进收件箱,整理交给它
链接.txt 里放了两条,课后说一句收一下试试
先用 Claude Code 自带的 WebFetch 写明要正文全文、不要总结。公众号文章它常读不到
读不到,换第 5 次课装好的 Playwright MCP 开浏览器去读。小红书、B 站常常只给标题、简介,或者一页安全验证,这是平台限制,不是出错
还读不到,复制正文或截图给它 全部读得到。读到什么存什么,读不到就说读不到
收进来的东西每次读都会发给模型。自己的材料脱敏再进,实习单位的内部材料和客户信息不进 。
III 放在一起比
两种知识库,差在什么时候干活
比什么 RAG · 问的时候去找 LLM Wiki · 来的时候就编
活干在哪头 每问一次,现找一次 每来一份资料,编一次 怎么找到 比夹角,问的是哪段文字和这句话最像 ,捞回几段。第一问靠意思找到农行第 25、26 页 先读索引,问的是按条目怎么分,答案应该在哪一页 。问第 8 次课做什么,就在索引里找到课程安排那一行,整页读 比大小、汇总 第三问答不了,前 5 段装不下 30 个数 一张指标页,30 行排好,成都银行 0.68% 在第一行 对不上怎么办 两段都捞回来,靠模型当场判断 入库时就标出来,写进变更记录或待核 会错在哪 捞错了段,照着错的答 编错一句,以后一直错 。微软研究院 2026 年让前沿模型连着多轮改文档,结束时平均改坏约四分之一的内容适合多大 几千到几百万份,问法五花八门 约一百份资料、几百页条目。再大,Karpathy 自己也说要加检索
不管哪种,原件都要留着、都要能核 。
Karpathy, llm-wiki, GitHub Gist, 2026-04-04;Laban, Schnabel & Neville, LLMs Corrupt Your Documents When You Delegate, arXiv 2604.15597, 2026-04-17
练习二 · 个人知识库 练习页 · 提示词见学员实操页 · 全程不联网
资料先进收件箱,整理交给它
2-1 收件箱里的课程资料,它编成了哪几页? 每句都指得回原件吗?
2-2 新开会话问:第 8 次课上什么? 查资料模块按什么选?库里没有,它会不会编?
2-3 新的课堂安排进库,旧说法去哪了? 进了变更记录吗?
2-4 记一条心得,RAG 和 Wiki 各适合什么 存成原件、补进条目了吗?
2-5 关掉重开再问,这回都答得上吗? 出处是哪一份?
收尾 怎么选 · 三个问题挨个问
挨个问,对上哪条选哪种
资料多到读不过来问法五花八门
几百上千份,同一件事有好几种说法,谁也说不准会怎么问。
选 RAG。 年份、公司这类条件,先用元数据筛,别交给相似度打分。
今天 30 家年报全文;练习一的 --公司 就是元数据过滤
要长期跟要知道哪里说法打架
同一批公司、同一门课,资料隔几天来一份,新的常常改旧的。
选 Wiki。 编一次,以后每次问都用上前面的积累。
今天 练习二这门课的知识库;30 家银行的一张指标页
两样都不是就几十份,结构清楚
资料不多,各管一块,查完就算。
写一份目录,让它整份读。 什么都不用装。
今天 Claude Code 读 CLAUDE.md、技能只露名字,走的就是这条路
记住一句 · 下午
RAG 每次现找,Wiki 平时就记好
资料常被问、要长期跟的,编成条目才划算;查一次就扔的,问的时候捞回几段就够了
晚上见
晚上讲常驻智能体 · 不开对话,它也按时干活
张一帆 · 中山大学岭南学院 · 金融 AI 智能体设计与应用
 1.00.90.8
0.70.60.5
02040
6080100