经济金融 AI 智能体设计与开源 · W08 01 — 57
开场 中山大学岭南学院 · 李学恒 / 张一帆
+ +
☰ ↑ ↓
中山大学岭南学院 · 经济金融 AI 智能体设计与开源 · 第八周
知识库设计 Agentic Search、RAG 与 LLM-wiki
李学恒
08 第八周
开场
回到两个底层约束
一 上下文的字数有限 每次大语言模型的输入和输出,能放的字数有上限。几百份资料放不进一次输入;上一次说过的话,这一次它看不到。
二 输入输出只能是字符串 它读进来的是字,写出去的也是字。读文件、改文件、查资料,都是它写出一张请求单,由 Claude Code 或 WorkBuddy 去执行,结果再变成字送回来。
所以“懂你”这件事,最后落在一个问题上:这一次,把哪些字放进它的输入 。
开场
这门课在做什么:一个懂你、能干、可控的数字人
懂你 记得你的目标、你的项目、你的身份情况 本周:知识库
能干 会用 Skill、会分工、接上工具能查能算 W04 · W06 · W07
可控 先问再动手, 贯穿每一周
整门课的目的,是带大家自己做一个理想的数字人。前几周讲能干,这周讲怎么让它懂你 。
I 懂你
没有记忆的它,如何懂你?
大语言模型没有记忆:每一次,它只看得到这一次输入里的东西。基于它的智能体要懂你,靠两件事。
一 写下来
关于你的事:专业、年级、在修的课、在做的项目
要它记住的事:项目进展、定下的决定
做事的规矩:先做什么、哪些事先问你
写成文件,放进一个属于你的文件夹 二 需要时找得到
每次干活前,先读规则文件
要用哪份材料,顺着目录和索引找到
找到的读进这一次的输入,也就是上下文
找到了、读进来,它才“想起来” 缺第一件,它没东西可找;缺第二件,写下来的它也看不到。
I 懂你
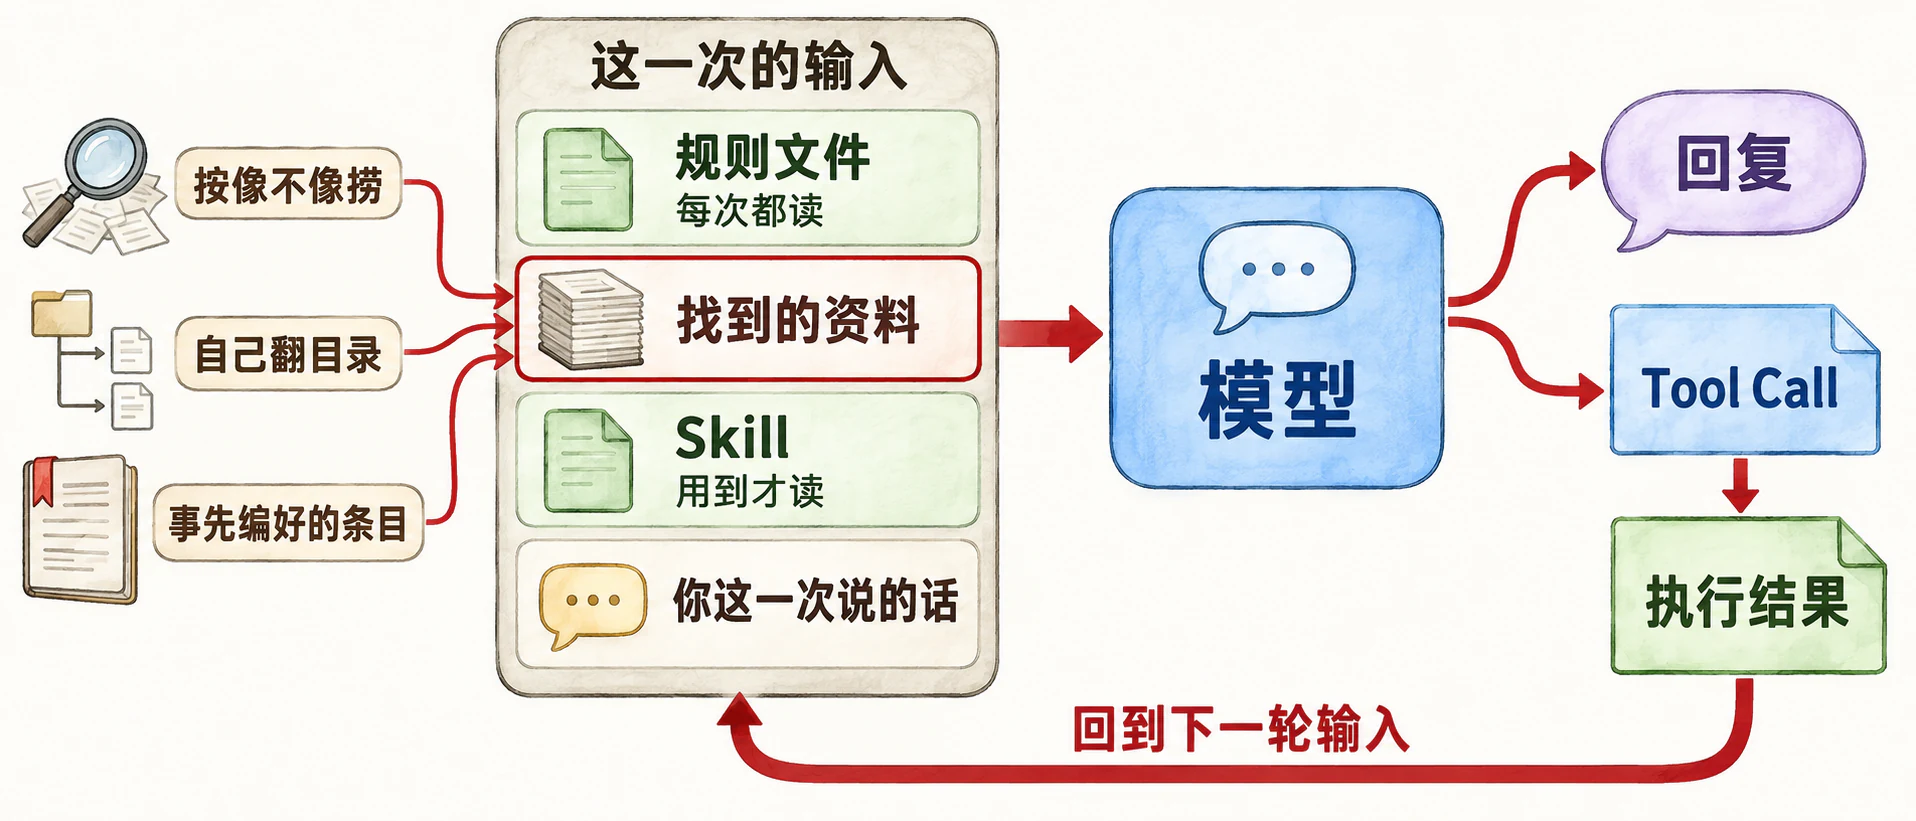
回到第一周那张图
Tool Call 是一张请求单,由 Claude Code 或 WorkBuddy 按权限去执行,结果回到下一轮输入。这一次,把哪些资料放进输入?
核心观点
不是 AI 记得,精准找到 刚好需要它知道的信息 。
I 懂你 · 我的信息中台
我的信息中台,由哪几样东西组成
目录结构 按研究、教学、会议、项目、人名等分区规则文件 这个库做什么、每个目录放什么、怎么处理新内容、哪些事先问我文件索引 每个文件夹一份,写清这里有什么几个 Skill 记一下、研究并保存、维护索引等固定动作
我用了两年的库,就是这几样东西。先看有它和没它差在哪,再拆开讲、动手搭你的。
I 懂你 · 看差别
演示:同一趟课程录音,交给两个地方
I 懂你 · 看差别
差在五个动作
动作 聊天框 课程知识库规则文件要它做的事 理解 照字面整理,转写里认错的词照抄 对照术语词典,更正认错的专有名词,注明原记 归档 笔记只在聊天窗口里 存进这门课对应周的文件夹 连接 只看眼前这一段 翻出前几周的课程笔记和课程日历,补出“上次讲的”是哪一周 记录在哪 没有地方可补 对不上的列进“待确认”,那个文件夹的索引多一行 复用 靠人翻聊天记录 下次问这门课,顺着索引就找到
差别不在模型强弱,在于有没有一个属于你的文件夹,以及这个文件夹有没有规则 。聊天框只做第一个动作。
I 三种技术路线
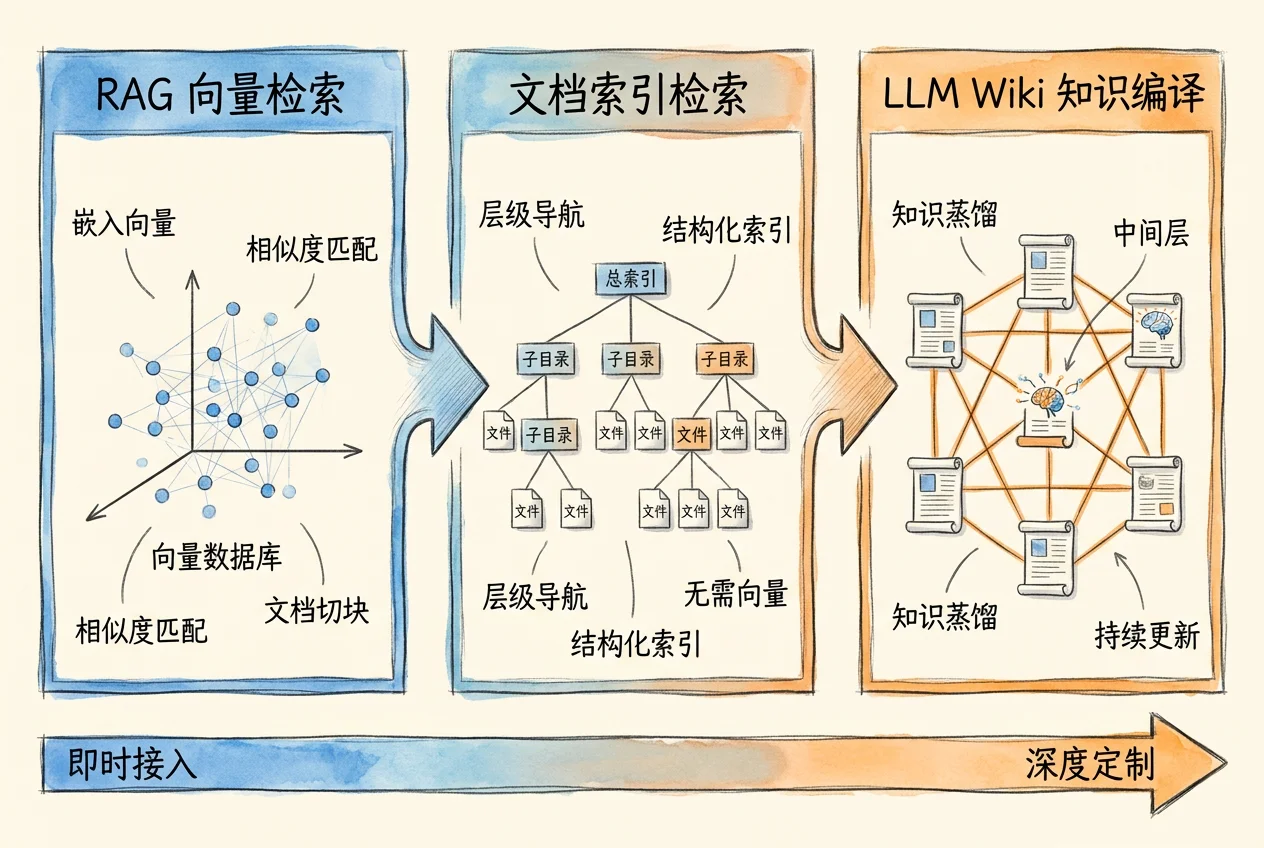
知识库的三种技术路线
三种差在
谁来挑 程序还是模型
什么时候挑 问的时候,还是资料来的时候
按什么挑 像不像,还是按目录推理
从第一类讲起:文档索引检索。
思考一个问题
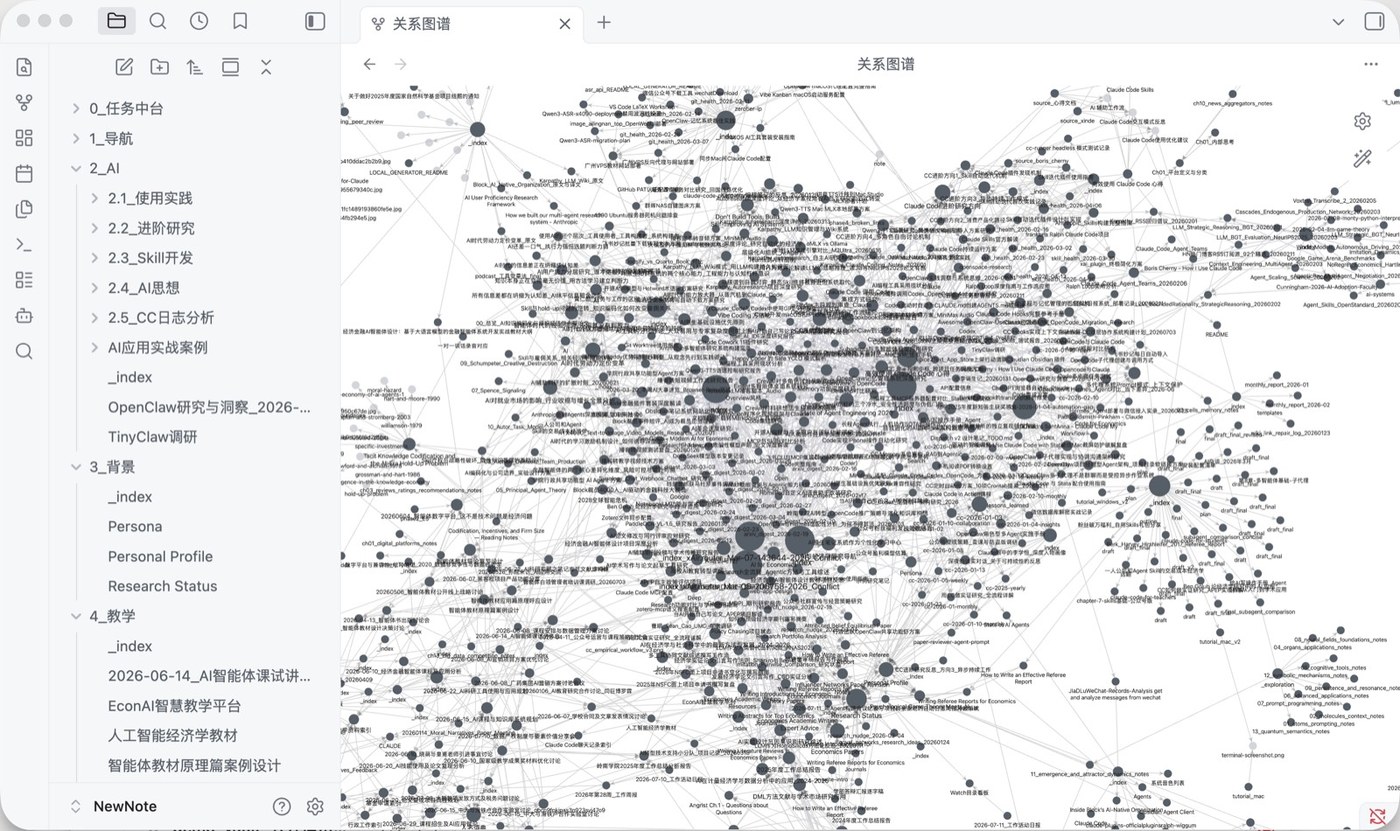
为什么不能简单把所有资料都扔到一个文件夹下面? 我的 AI 笔记库,就是电脑上的一个文件夹。
II Agentic Search
一个每天在用的真实库
我的笔记库 · 一级目录(节选)
0_任务中台/AI 任务的过程记录
2_AI/AI 实践与案例
4_教学/课程
5_会议/纪要,按周分
6_研究/研究方向
7_行政/行政事务
9_学习笔记/读书与课程笔记
2000 多篇 笔记100 多份 索引
每天有定时任务往里写;只展示目录,不展示笔记内容
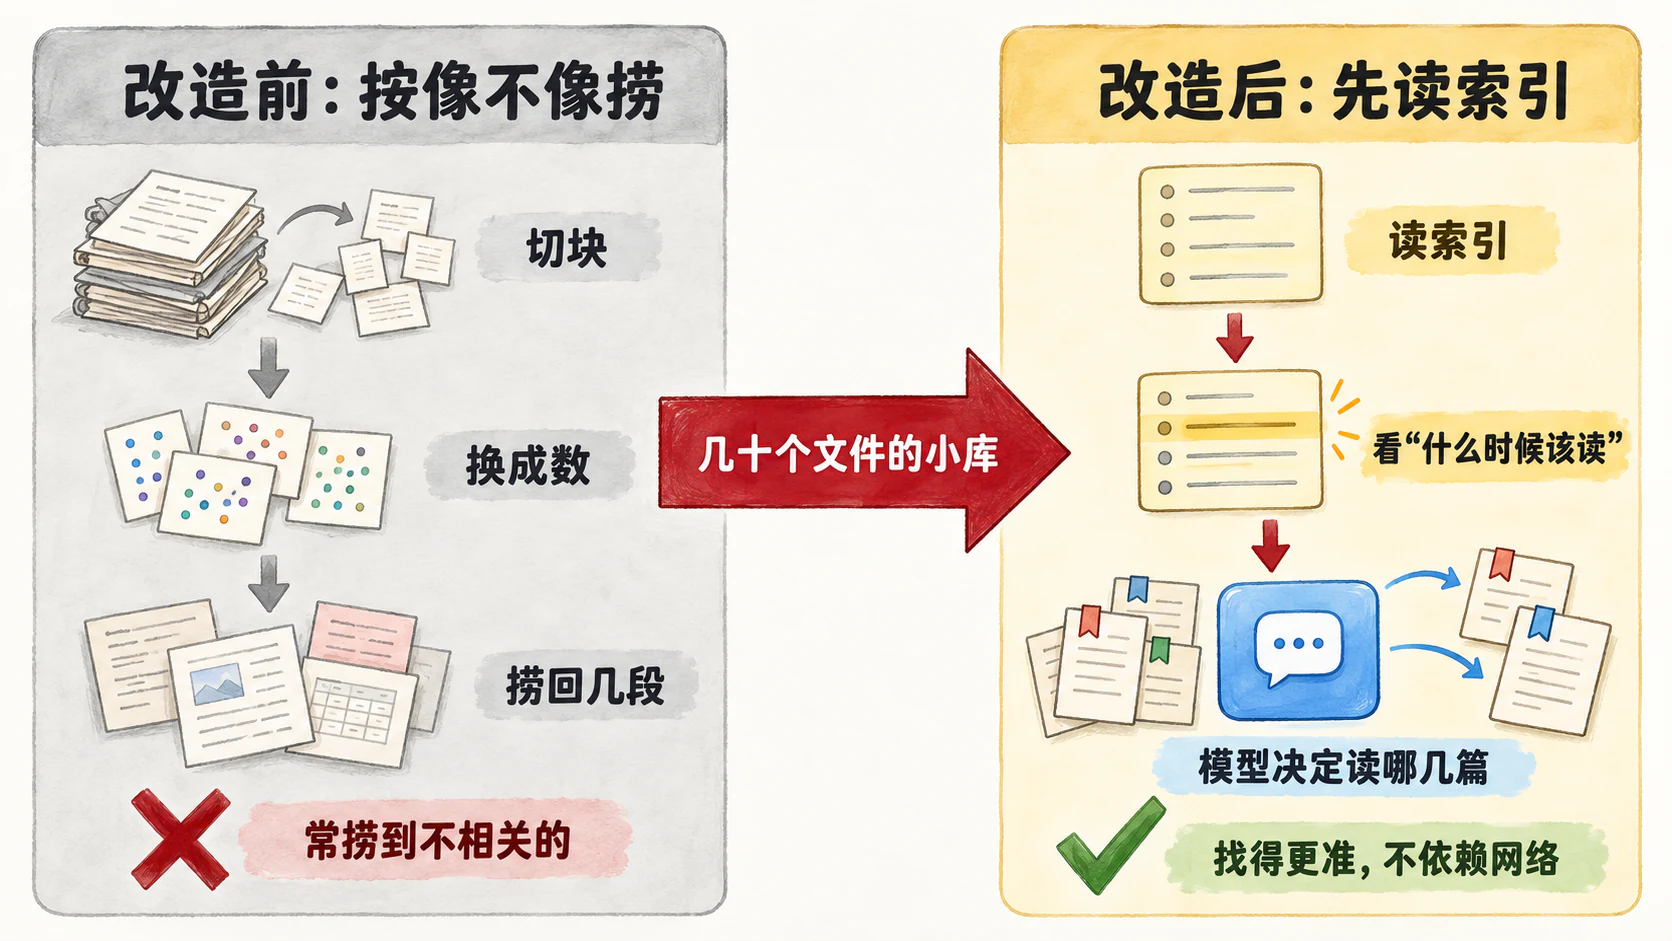
我还把 Claude Code 的“经验记忆”从向量检索改成了读索引:几十个文件的小库,先读索引里“什么时候该读这篇”的一句话,再让模型自己决定读哪几篇 ,找得更准,也不依赖网络。
统计口径:Markdown 文件数与 _index.md 份数(不含原始转写)
II Agentic Search · 三个组件
让它懂你的,是三样东西
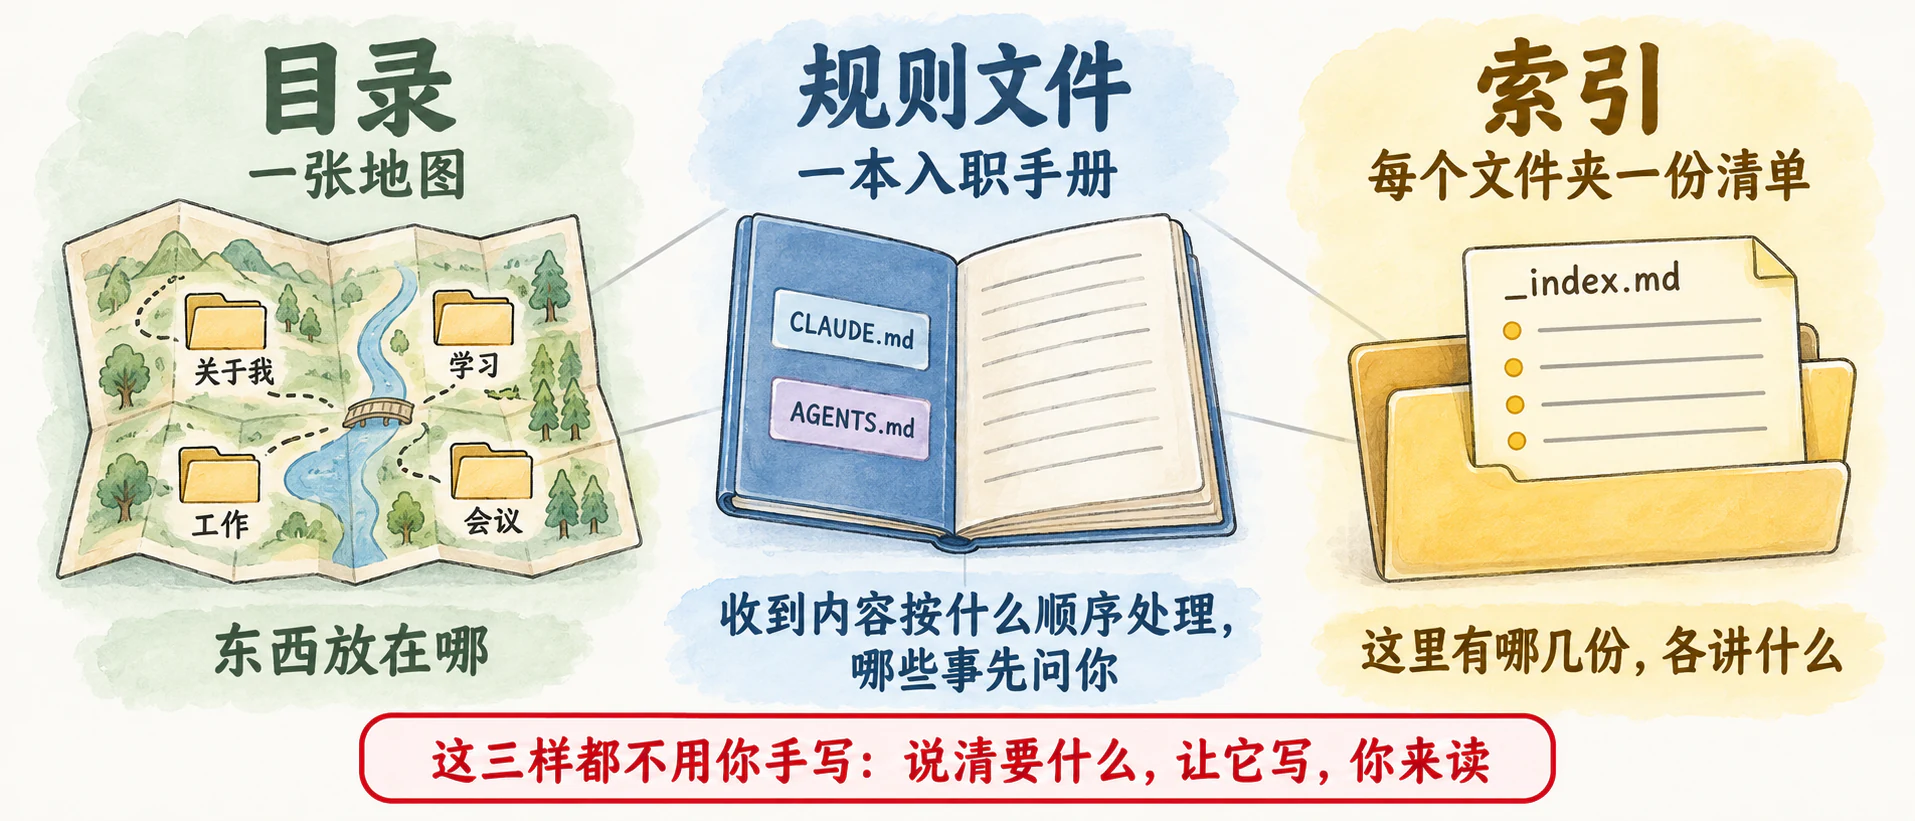
组件 它管什么 课程录音例子里 一 目录结构 找得到 :光看文件夹名,就知道东西该放哪笔记存进这门课第几周的文件夹 二 规则文件 CLAUDE.mdAGENTS.md写下来 :这个库服务谁、收到内容按什么顺序处理、哪些事先问你打开文件夹就读进来;按术语词典更正认错的词,对不上的列进“待确认” 三 文件索引 _index.md找得到 :每个文件夹一份,告诉它这里有什么顺着索引找到前几周的课程笔记
这三样放进它每次的输入,就是前面说的上下文 (Context)。备得越到位,它每次表现越稳。
II Agentic Search · 组件一
组件一 · 目录结构:给它画一张地图
从五到九个分区 起步,用起来再拆
名字按事说话,5_会议 比“杂项”强得多;
允许往下再分一层,如 5_会议/2026年10月_第4周/
结构按你的学习和生活来分;今天的模板用的是通用版
AiNote/
CLAUDE.md · AGENTS.md规则文件
1_关于我/你是谁、在忙什么
2_想法/判断、灵感
3_工作/小组项目、实习,一项一份
4_学习/课程与读书笔记
5_会议/讨论记录按周分;人名词典
6_研究/ … 9_代码/其余四个区
临时工作区/草稿,不放正式笔记
.claude/skills/三个 Skill
目录就是你给智能体画的一张地图。每个目录里都有一份 _index.md,是这个目录的目录页。
II Agentic Search · 组件二
组件二 · 规则文件:写什么、长这样
AiNote / CLAUDE.md(节选)
# 这个笔记库的工作规则 每次开始新任务,先读这份文件
## 这个库服务谁 一位经济学大二学生;背景见 1_关于我/
## 目录分别放什么 每个分区一行;正式笔记不放临时工作区/
## 自带的三个 Skill takenote · research-save · update-vault
## 收到一段内容时,按这个顺序处理 七步:先读对应文件夹的 _index.md 再读笔记 · 判断新建还是更新 · 写完更新 _index.md · 回报相对路径
## 写作要求 不补写没提供的事实 · 拿不准的列“待确认”
## 涉及人名和数字 人名以人名词典为准 · 数字对不上就指出,不默默采信
## 必须先问我的情况 删除、覆盖、批量移动 · 改本文件 · 对外发送 · 个人信息
脑子里的规矩写下来,就不会随对话丢;收到内容按什么顺序处理 ,也写在这里。
II Agentic Search · 组件二
这份文件,不用你手写
你以为要做的
学 Markdown 语法 学怎么写规则文件 学索引文件的格式 再学一门技术 实际要做的
一句话交办:“照我刚才说的,帮我把这个库的规则文件写出来。”
它写完,你读一遍 缺哪一块,告诉它补上
改之前让它先把要加的那句话给你看 你不用会排版,但你得知道规则里该有什么:这个库服务谁、东西放哪、按什么顺序处理、哪些事先问你。
II Agentic Search · 组件三
组件三 · 文件索引:告诉它这里有什么
5_会议/_index.md 里的两行
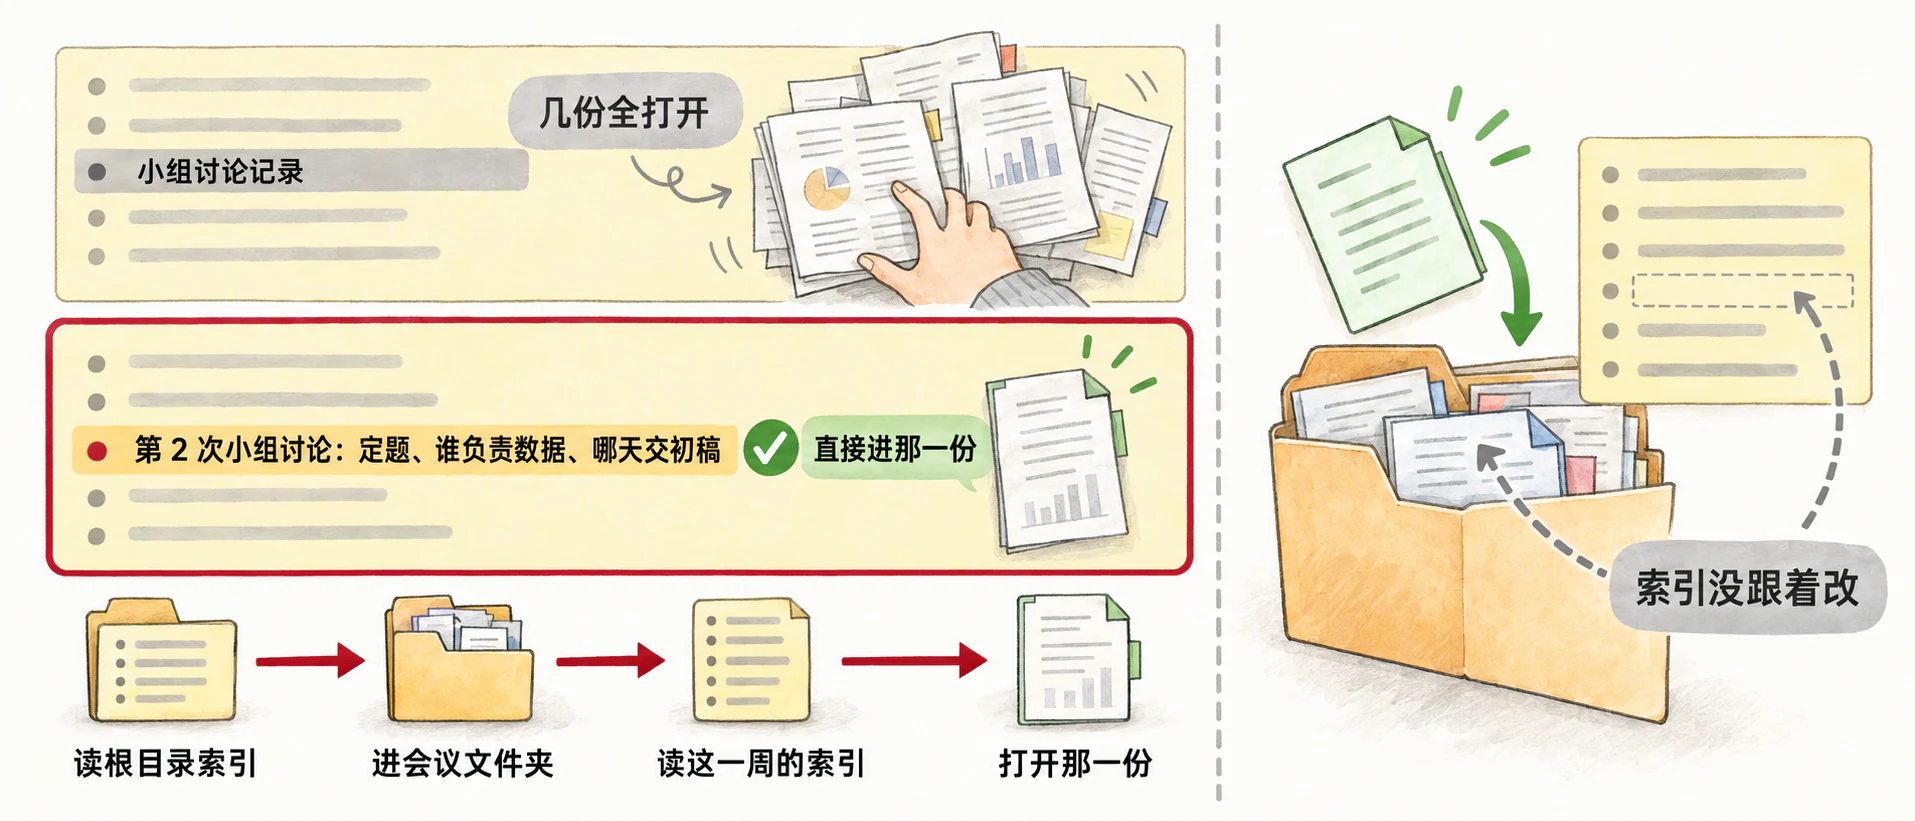
文件 讲了什么 2026年10月_第3周/第1次小组讨论.md选题三个候选:直播电商退货率、外卖平台抽成、二手车定价;数据来源未定 2026年10月_第4周/第2次小组讨论.md定题直播电商退货率;许昊天负责平台数据,苏婉清负责问卷;10 月 30 日前交初稿
它找一件事的路径
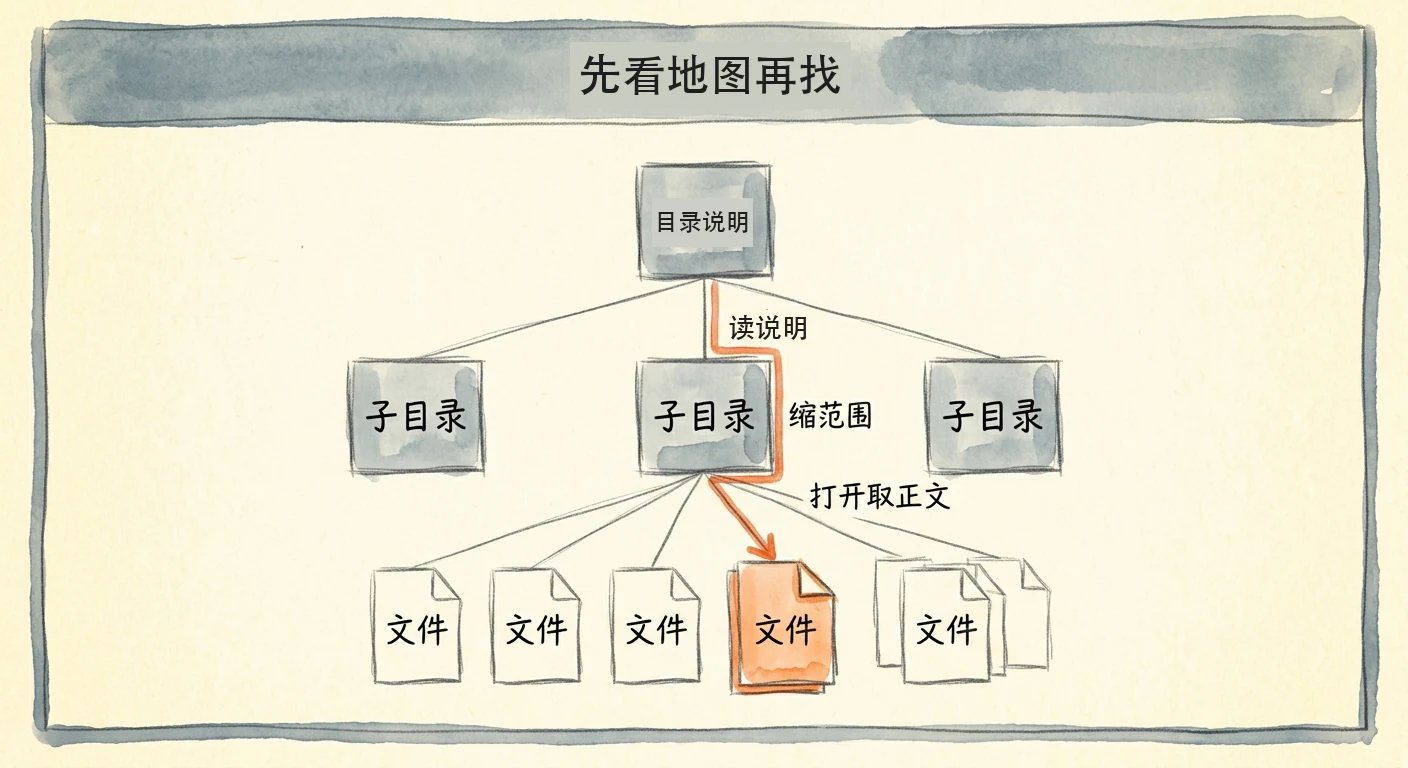
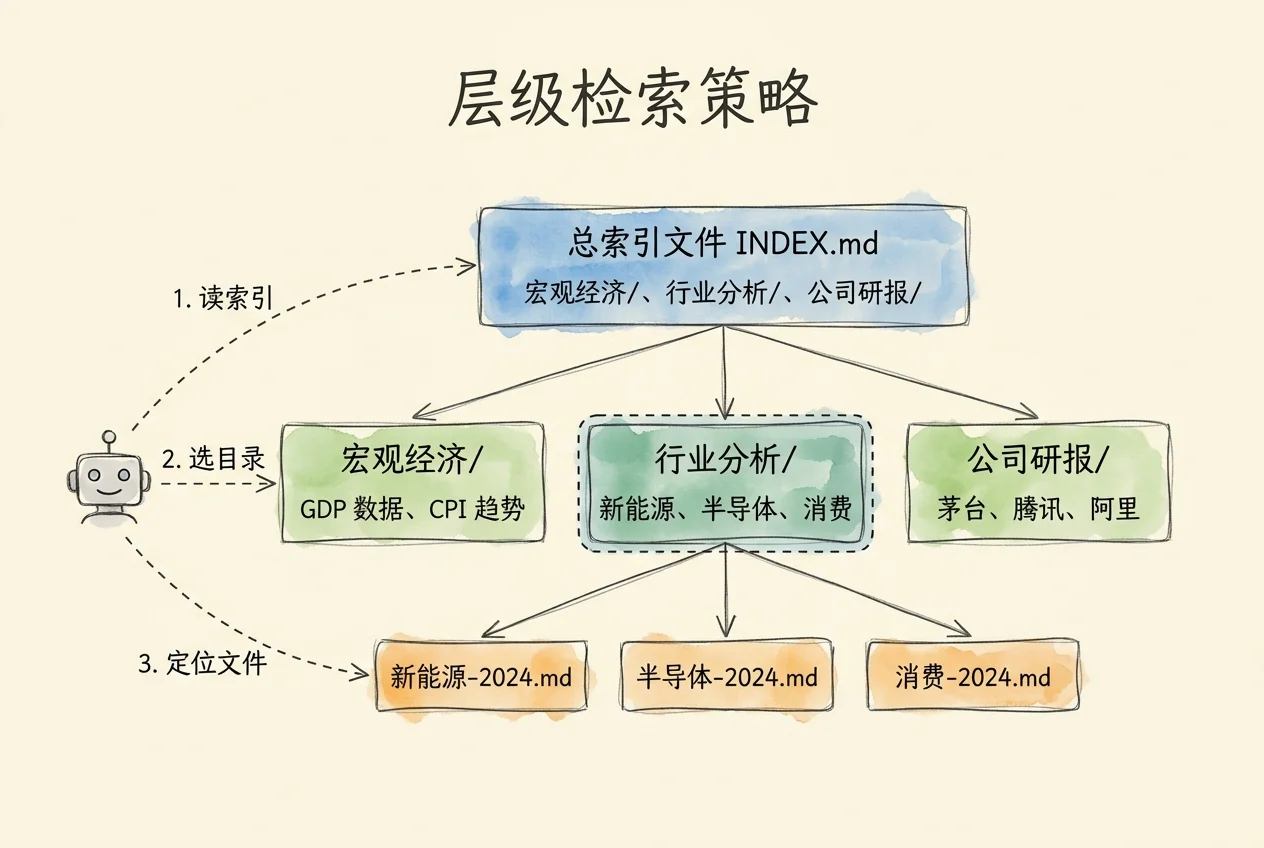
读根目录 _index.md 判断进哪个分区 进子目录读摘要 锁定那一份 打开取正文 摘要写“小组讨论记录”,它得几份全打开;写清定了什么、谁负责、哪天交 ,它直接进那一份。索引要跟着改 ,这一步写进规则、交给它做。
文件名、人名为教学虚构
II Agentic Search
目录说明与索引:一张地图,一份清单
目录说明 文件索引 写在哪 规则文件里的一节 每个文件夹一份 _index.md 回答什么 每个分区放哪类东西 这个文件夹里现在有哪几份,各讲了什么 多久变一次 加分区、改结构时才改 每记一条就多一行 谁来更新 它起草,你先看再批 它写完笔记顺手更新(规则里写明)
文件夹里有,不等于这一次看过。先看地图、再看清单、再挑着读:放进这一次输入的,是刚好需要的那几份 。
II Agentic Search · 组件四
组件四 · 配套 Skill:让每次动作都一样
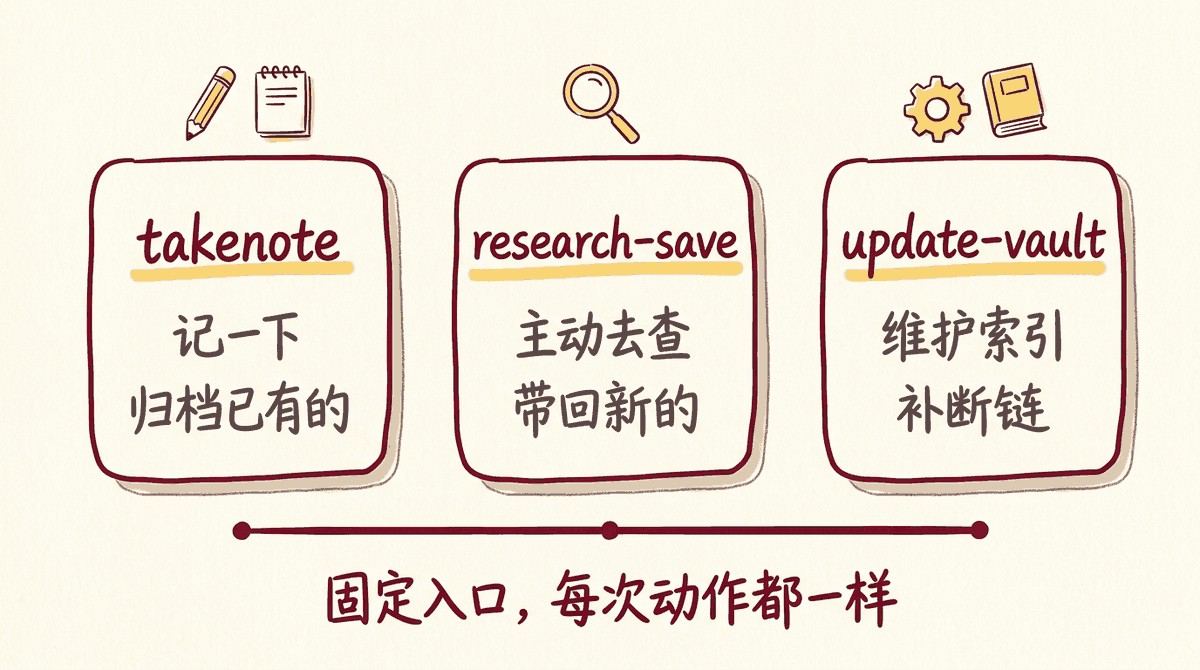
模板自带的 Skill 你说什么话,它接住 它负责什么 takenote “记一下” 把手上已有的内容归档进库 research-save “研究并保存……” 主动去外部查, update-vault “维护一下索引” 体检索引与链接,
什么时候该固定成 Skill:同一句话,连续三次结果都一样,就该固定下来了。
不用 Skill 也能跑:处理流程写在规则文件里,它照着做。Skill 接住入口,规则文件定流程 ,同一句话每次走同一套动作。
II Agentic Search
翻目录,就是一串 Tool Call
不切块、不换成向量。
1 读根目录的索引 模型写请求单,宿主执行后送回
2 读那个文件夹的索引 它判断答案多半在哪个文件夹
3 打开这一篇
每一步都是模型写的请求、宿主做的执行 ,工具记录里看得见。基于索引文档的 Agentic Search 。
II 上机
上机:四步,把这个库改成你的
第一步 让它认识这个库, 改“关于我”
第二步 记一条 看它按规则文件的流程把一段随手记记进库
第三步 关掉对话,让它重新找 不靠聊天记录,顺着目录和索引找回来
第四步 给它加一条规则 改规则文件:加一条你自己的规矩
打开材料包里的课程知识库(AiNote 学生版),工作空间选到库这一层;Claude Code、WorkBuddy 任选一端。老师做一步,你们跟一步。
四步做完,规则文件和“关于我”里有了你自己的东西。每一步只多一件新东西。
II 上机
演示:用 WorkBuddy 走一遍上机四步
II 上机 · 第一步
第一步:让它认识这个库,也认识你
指令
先读一下这个库,然后用不超过 5 个问题了解我:我的专业和年级、这学期在修哪些课、在做什么小组项目或实习、笔记喜欢怎么写、哪些事必须先问我。根据我的回答更新 1_关于我/ 里那两个文件。不要新建目录,不要动示例笔记。
新建任务,工作空间选到课程知识库这一层 整段复制上面的指令 回答它的问题,按自己的情况说;不写真实姓名、学号、手机号 自查
它问的问题,是冲着你来的吗? “关于我”里有你刚说的话, 答得越具体,后面三步的差别越大。
II 上机 · 第二步
第二步:记一条
指令
① 收件箱里有一段第 7 周的课堂录音转写,帮我整理成这节课的笔记。
素材 · 小组讨论随手记
“10 月 24 日小组碰了一下:徐浩天说平台数据周一给;问卷苏婉清发出去 80 份,林可馨又找了 40 份,一共 150 份;初稿按上次定的,11 月 2 日交。”
跑的时候盯一件事:它在动笔之前,有没有先去读索引。
随手记、人名、数字均为教学虚构
II 上机 · 第二步
对答案:这段随手记里埋了三个坑
随手记里怎么说的 它应该做到 素材自己对不上 80 份+40 份,说“一共 150 份” 指出 80+40=120,不跟着抄 150 和库里记录对不上 “初稿按上次定的,11 月 2 日交” 翻出第 2 次讨论记录:定的是 10 月 30 日;11 月 2 日进“待确认”,不替你选 人名 “徐浩天”“林可馨” 人名词典里是许昊天、林可欣:改过来,注明原记 落点也算一项 — 笔记落在 5_会议/2026年10月_第4周/,那个文件夹的 _index.md 多一条具体 摘要
抓到不到两个,多半是第一步的背景填得太空,或工作空间没选到库这一层。
随手记、人名、数字均为教学虚构
II 上机 · 第三步
第三步:关掉对话,让它重新找
指令
我们小组项目现在卡在哪?下一步谁做什么?说明你是怎么找到的。
新开一个任务 ,不要接着刚才那个对话;工作空间还选课程知识库粘贴指令,看它去哪找、怎么找 自查
答案里有刚记的那条,也有第 2 次讨论的约定,附上相对路径 它说得出读了哪几份 _index.md(根目录 → 5_会议/ → 这一周……) 它不记得刚才聊过什么,照样找到了:东西不在聊天记录里,在文件夹里 ,有索引告诉它去哪找。
II 上机 · 第四步
第四步:给它加一条规则
指令
现在我要加一条规则:以后新资料和旧笔记说法对不上时,正文写新的,旧说法连同出处挪进这页末尾的“变更记录”。这条规则加进 CLAUDE.md 和 AGENTS.md。先别动手改文件,把你打算加的那句话发给我看,我说行你再改。改完把收件箱里的“W07 主题改名”通知整理进课程笔记。
发出去,它停下来,先给你看要加的那句话 看过没问题,回一句“行,改吧。”;写得空就打回去 看它把改名通知整理进去,旧名字去了哪 自查
它先给你看,没有直接动手改 新规则具体: 旧说法进了变更记录,带出处;两份规则文件一起改了 两个动作:先看再批 、新规则管住以后。笔记库加上这条入库规则,就往第三类走了一步。
III RAG · embeddings
先把文字变成一串数:embeddings
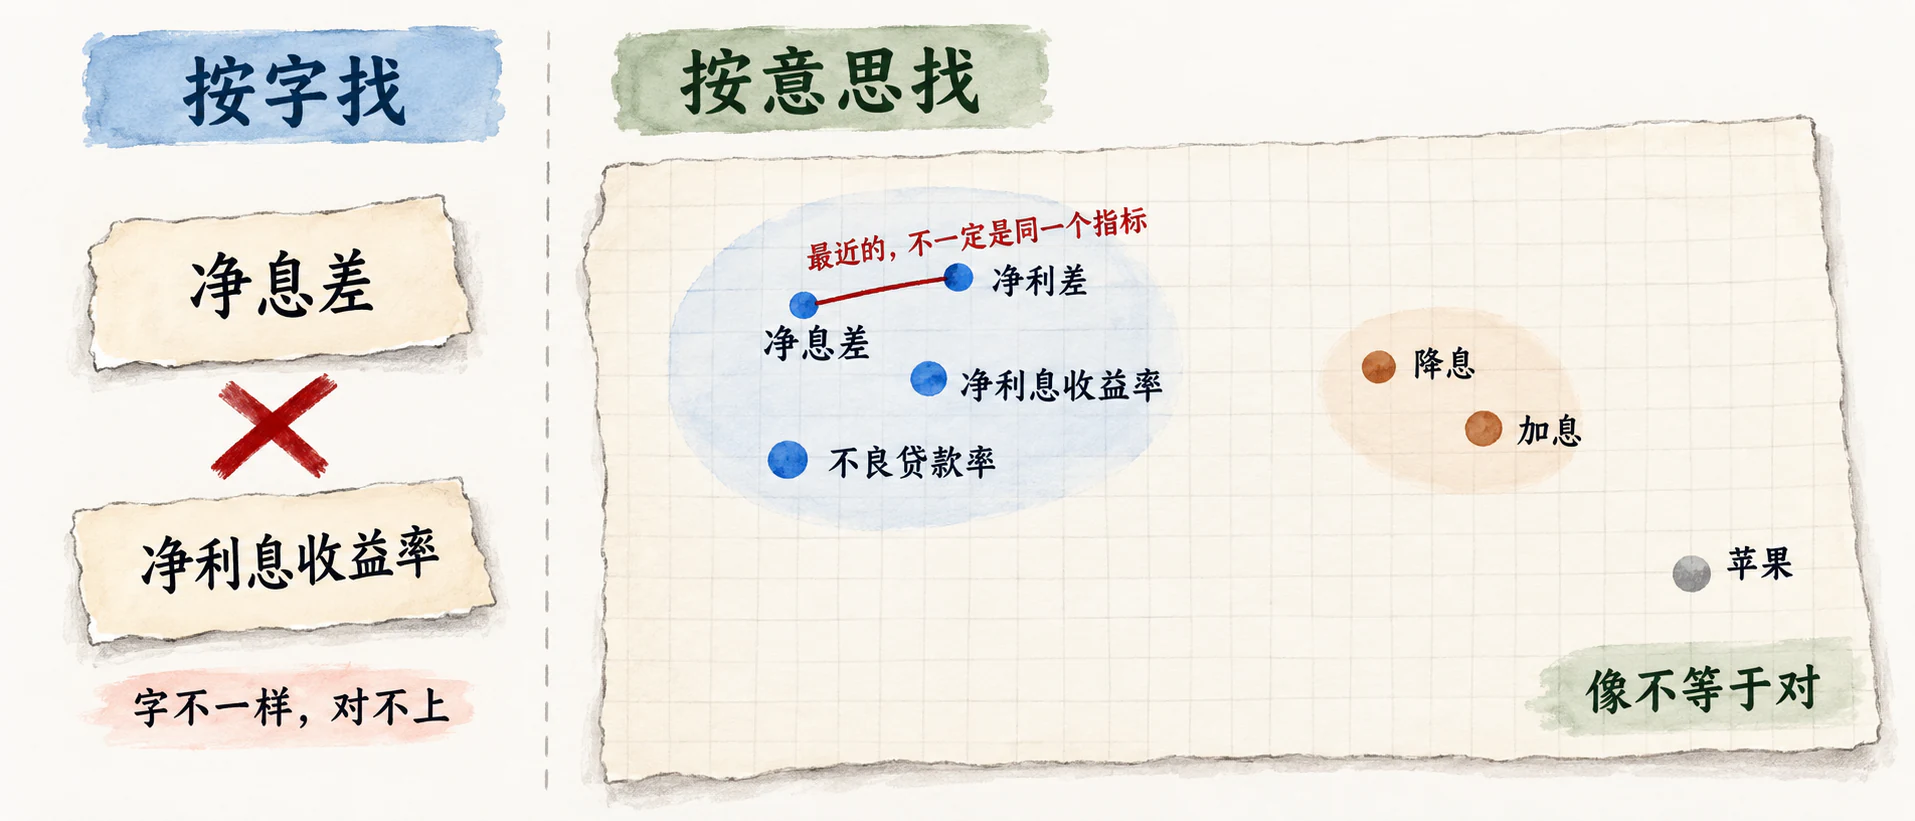
1 数字面 一段话里每个词出现几次,排成一串数(词袋)。只认字面:“净息差”和“净利息收益率”一个字面相同的词都没有,对不上。
2 看邻居 一个词常和哪些词一起出现,就近似它的意思。
3 多维空间里的一个点 这串数是一个向量,所有向量构成一个多维实数空间。比两支箭头的夹角(余弦),夹角越小越像。
把文字变成向量的这一步,叫 embedding (嵌入)。RAG 的“按像不像”,比的就是这些向量。
III RAG · embeddings
每个词,是意思地图上的一个点
第一维 12.1%
第二维 7.7%
降息 加息 降准 宽松 紧缩 央行 美联储 逆回购 净息差 净利息收益率 净利差 不良贷款率 拨备覆盖率 资本充足率 信用风险 违约 逾期 坏账 商业银行 证券公司 保险公司 基金公司 大模型 人工智能 智能风控 数字化转型 苹果 香蕉 足球
两维只留了约 20% 的差异,图上挨着的不一定真近,远近以右边的余弦为准 。
选中的词
净息差
1024 维里离它最近的三个 · 余弦
1 净利差 0.89
2 净利息收益率 0.81
3 不良贷款率 0.69
银行指标 货币政策 风险 金融机构 科技 无关
加息和降息,反义词也挨着 · 0.69 它们常出现在一样的句子里。近,不等于同义 。
苹果离人工智能最近 · 0.59 足球离人工智能也有 0.57。单个词的余弦差零点零几,别读太多。
教师机 2026-10-19 实测,BAAI/bge-m3;29 个词各 1024 维,用 PCA 压到两维画图;重合的点错开了一点
III RAG · 净息差与净利差
按字对不上,按意思对得上
净息差—净利息收益率 0.81 · 净息差—净利差 0.89 (另一个指标) · 农业银行年报只写“净利息收益率”,不写“净息差”
按字比只认字面,问“净息差”找不到“净利息收益率”。按意思比排得上来,可最近的是净利差,另一个指标:像不等于对 。
30 家 A 股上市银行 2025 年年报文字部分 · 向量模型 BAAI/bge-m3
III RAG · embeddings
年报文字里,读得出谁和谁是同类
上海 中信 中国 交通 光大 兴业 农业 北京 华夏 南京 宁波 工商 常熟 平安 建设 成都 招商 杭州 民生 江苏 沪农商行 浙商 浦发 渝农商行 苏州 邮储 重庆 长沙 青岛 齐鲁
渝农商行 点一家看近邻 重庆银行0.559 沪农商行0.410 农业银行0.281
六大行 股份行 城商行 农商行
JPE 2016 Hoberg & Phillips · 用 10-K 找同业(TNIC) 左图拿 30 家银行照做。每家段落向量取平均,减去 30 家的平均 ,再两两比。
JFE 2025 Breitung & Müller · GPT-3 写的业务描述换成嵌入
三个检验 嵌入 作者的词袋
按同业做多空,等权月度七因子 α(美国) 146 bps 119 bps 10-K 写明的竞争者,前 100 家找回几成(美国) 47.7% 32.8% 后来的并购对象,落在前 100 家里几成(全球) 49.7% 17.7%
用整份 10-K 做的 TNIC,在美国仍略胜。嵌入的长处是能做到全球 。
Hoberg & Phillips, JPE 124(5), 2016;Breitung & Müller, JFE 166 (2025) 104007,第 2.5 节、第 3 节、表 4、6、7、图 7,检验一栏嵌入是 OpenAI 的大号嵌入模型;地图为教师机 2026-10-19 实测,BAAI/bge-m3,两维只留约 16% 的差异,重合的点错开了一点
III RAG
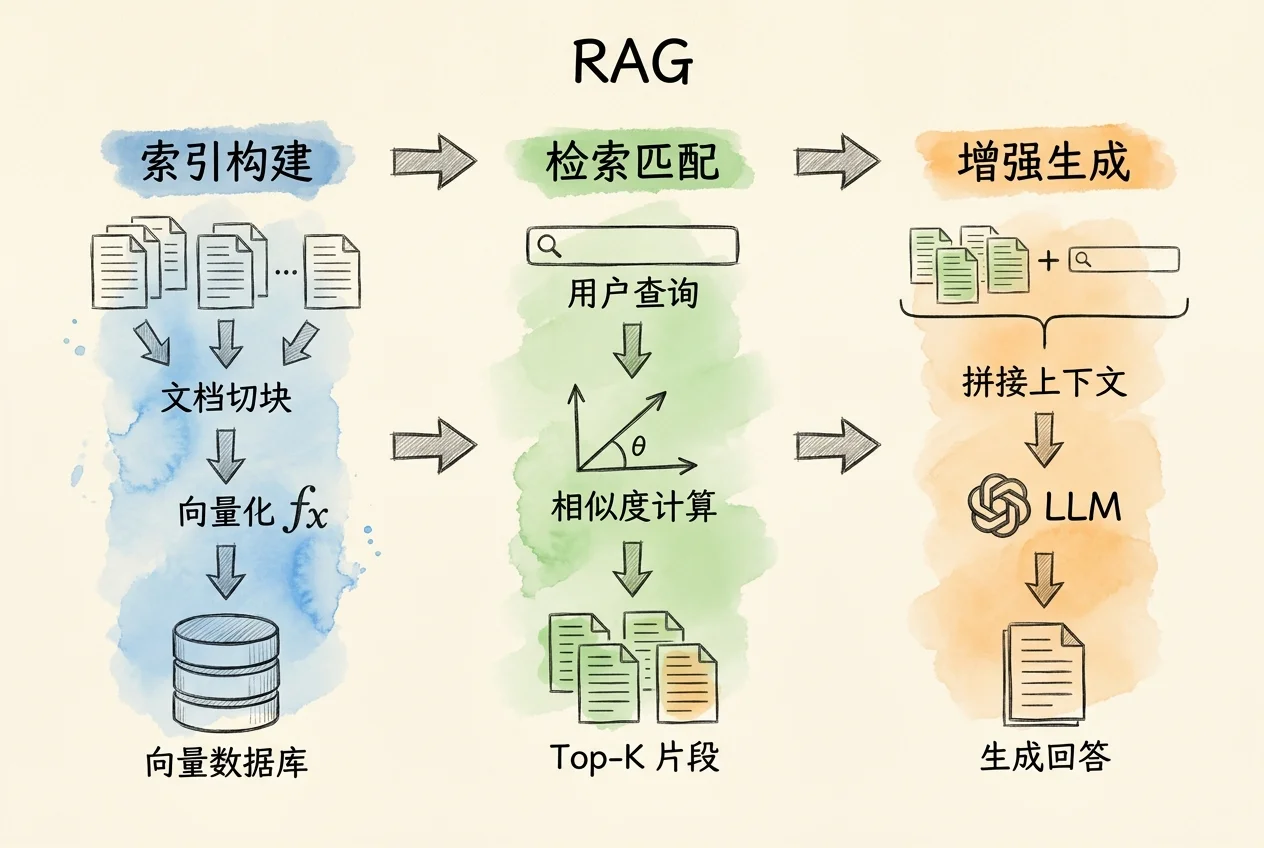
搭一个 RAG,五步
资料进来时做一次 ① 切块(每段几百字,前后重叠两行)
每问一次做一遍 ④ 把问题也换成向量,挑最像的几段
名字取自后两步:检索、增强、生成,RAG (Retrieval-Augmented Generation)。
30 家年报切成 7638 段,每段换成 1024 个数;建库约 335 秒;问一次,把问题换成向量再比 7638 段,几秒内出结果
RAG 一词出自 Lewis et al., NeurIPS 2020
III 演示 A
演示 A:按字找,按意思找,再问一个它答不了的
任务
同一个问题“农业银行 2025 年的净息差是多少?”,先
按字 找,再
按意思 找;再问“30 家里 2025 年末不良贷款率最低的是哪家”,要它只凭检索结果答
要看到
按字:前 5 段
一段农行都没有 。按意思:农行年报第 26、25 页排前两段,写的是“净利息收益率 1.28%”。第三问:前 5 段只碰到 4 家银行
怎么验收
第一问答 1.28%,说明原文叫“净利息收益率”、出处第 25 页;第三问它说“检索答不了”,换办法后答出:成都银行,0.68%
WorkBuddy 怎么做 同一个文件夹当工作空间,命令相同
检索结果 · 按意思 · 前 2 段
[1] 余弦 0.777 | 农业银行 2025 年年度报告 · 第 26 页…净利差 1.16 / 1.27 净利息收益率 1.28 / 1.42
[2] 余弦 0.775 | 农业银行 2025 年年度报告 · 第 25 页…净利息收益率 1.28%,净利差 1.16%,分别下降 14 个和 11 个基点…
按字 · 前 5 段
上海、民生、华夏、建设、渝农商行:没有农行
30 家 A 股上市银行 2025 年年报文字部分 · 检索结果为材料包复跑输出(2026-10-25)
III RAG · 看差别
演示:净息差还是净利差,用 RAG 与不用
III RAG
找片段,有三个天生的毛病
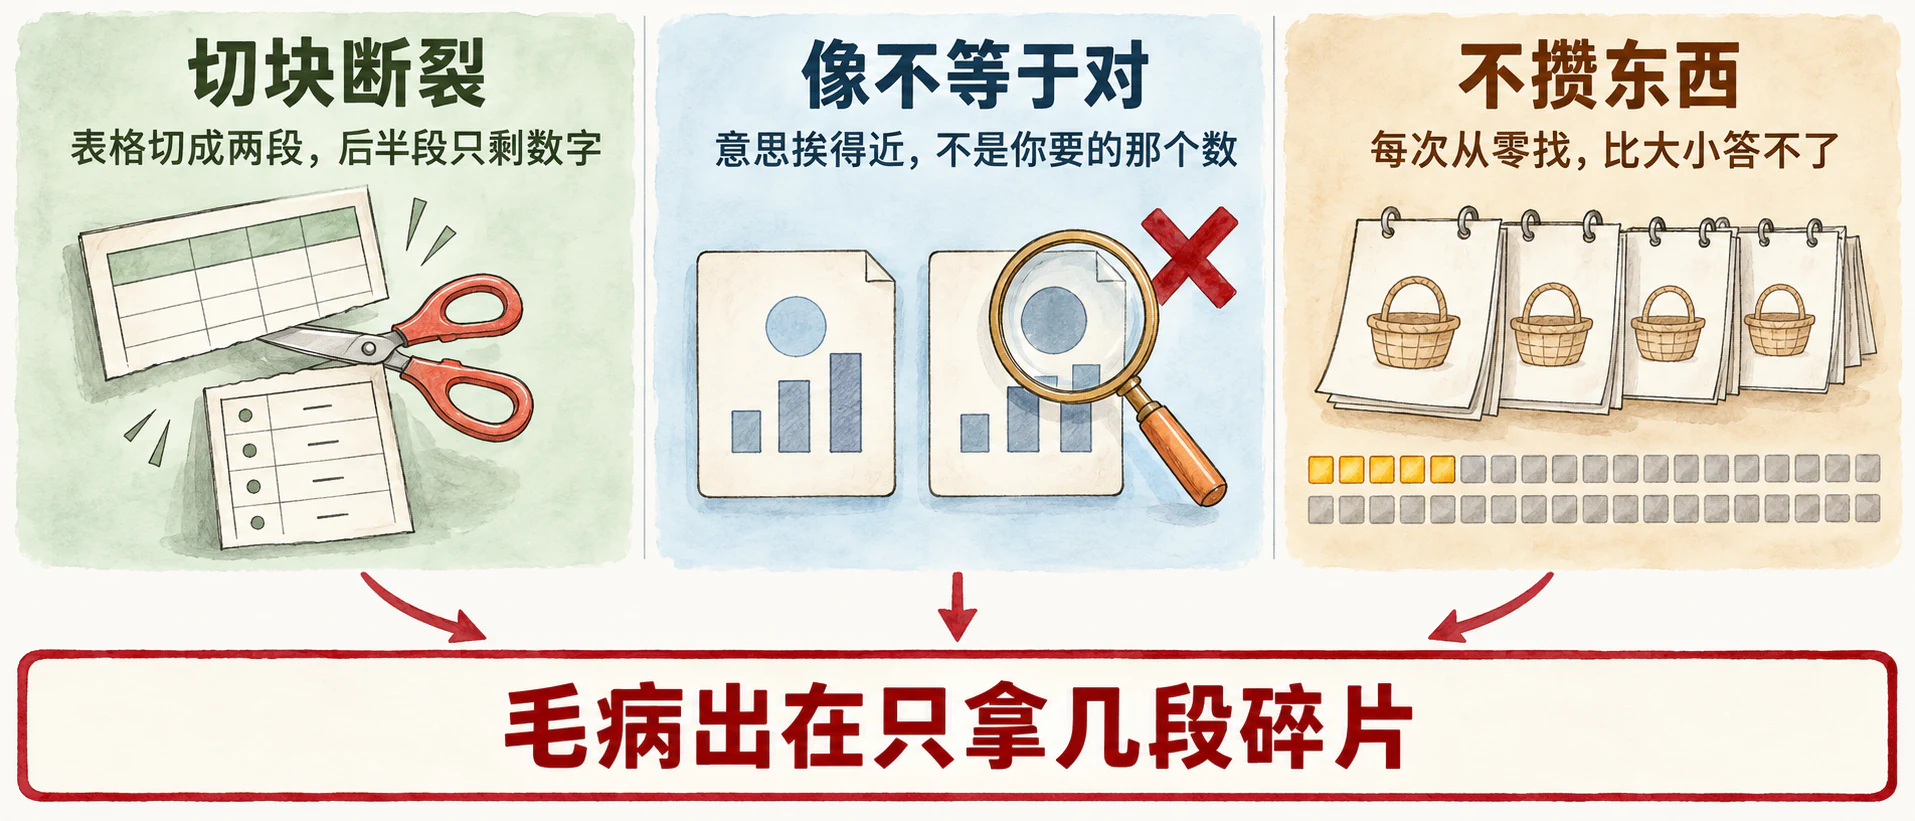
例:招商银行年报第 32 页的信用卡不良率表被切成两段 · “30 家里不良率最低是哪家”,前 5 段只落在 4 家银行(平安银行占两段)
切块断裂 :一张表切成两段,后半段只剩数字,看不出是哪一项、哪一年。像不等于对 :意思挨得近,说的不一定是你要的那个数。不攒东西 :每次从零找,比大小、列名单答不了,今天找过的明天还得再找。
Anthropic, Introducing Contextual Retrieval (2024)
III RAG
你手边的 RAG
软件 五步藏在哪 适合放什么 WorkBuddy 资料库 上传文件后它替你切块、换成向量; 量大、偶尔查的原件 ima 知识库、乐享知识库 在 WorkBuddy 资料库里授权接入,调它们自己的检索 个人收藏(ima)、 Cherry Studio 知识库 本地建库,选一个向量模型 想自己管资料、换模型 Dify、扣子的知识库节点 工作流里的一个节点:检索资料 → 交给模型写 做成固定流程给团队用
这些“知识库”就是五步藏在界面后面:适合放量大、偶尔查、团队共用的原件 ;它替你切块、换成向量,你看不到它这次召回了哪几段。
各软件官方文档 · WorkBuddy 资料库、ima、乐享的接入方式核查于 2026-10-15
III RAG · 回头看
回头看:Claude Code 自己不用向量检索
“Early versions of Claude Code used RAG + a local vector db, but we found pretty quickly that agentic search generally works better. It is also simpler and doesn’t have the same issues around security, privacy, staleness, and reliability.”
早期版本的 Claude Code 用过 RAG 加本地向量库,但我们很快发现,让它自己去搜(agentic search)总体效果更好。它也更简单,没有 RAG 在安全、隐私、内容过时和可靠性上的那些问题。
Boris Cherny,Claude Code 的作者 · X,2026 年 2 月 1 日 你们每周用的 Claude Code,找文件靠的是
列目录 看看有哪些文件夹搜关键词 看哪个文件提到它打开文件 读要的那几段每一步都是一次 Tool Call,
III 上机 · 进阶
进阶:30 家银行年报的 RAG
打开银行年报 RAG 文件夹,向量库已经算好 同一个问题跑三次:按字 、按意思 、加公司条件 ,看要的数排第几 让它只凭检索结果答一个比大小的问题,看它说不说“答不了” 没有硅基流动 key 时,只问问题清单里的原话 自查
说得出按字为什么找不到农行净息差 每个数都写了哪家银行、原报告第几页 比大小那一问, 它没有绕开检索脚本直接翻资料库 30 家 A 股上市银行 2025 年年报文字部分
IV 来的时候就编好
别每次现找,把资料编成一本百科
“The LLM is rediscovering knowledge from scratch on every question. There’s no accumulation.”
每问一次,模型都在从头重新找一遍,什么也没攒下。
“The knowledge is compiled once and then kept current, not re-derived on every query.”
知识编一次,之后一直保持更新,不用每次提问再推一遍。
前两种都是问的时候才去找,找完就散。Andrej Karpathy(OpenAI 创始成员)写了一份思路文件:资料进来的时候就读懂、编进一页页互相链接的条目 ,问的时候翻条目。他管这叫 LLM Wiki 。
Andrej Karpathy, LLM Wiki (GitHub Gist,2026 年 4 月)
IV LLM-wiki
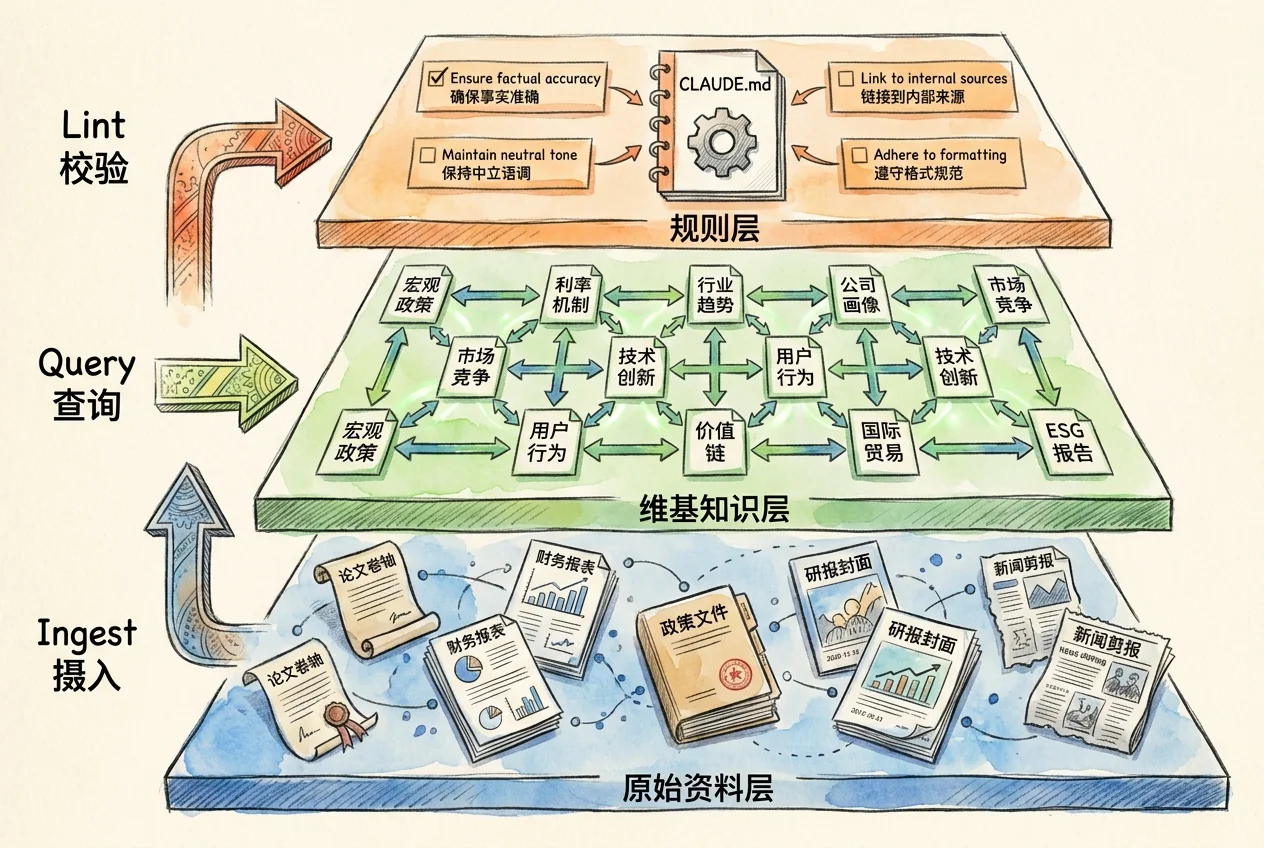
三层:原件、条目、规则
原件 论文、报告、课件,只读,怀疑哪句就回这里核
条目 模型编、模型维护,一个概念一页、一个机制一页、一场争论一页,每句标出处,外加一份索引和一份按时间记的日志
规则 一份说明文件,定条目怎么分、怎么写、说法对不上听谁的,人和模型一起改
文献维基 literature-wiki 里:原件=raw_pdfs/(转成的文本放 raw_markdown/);条目=wiki/;规则=库根目录的规则文件与 wiki/schema/
Andrej Karpathy, LLM Wiki (GitHub Gist,2026 年 4 月)
IV LLM-wiki
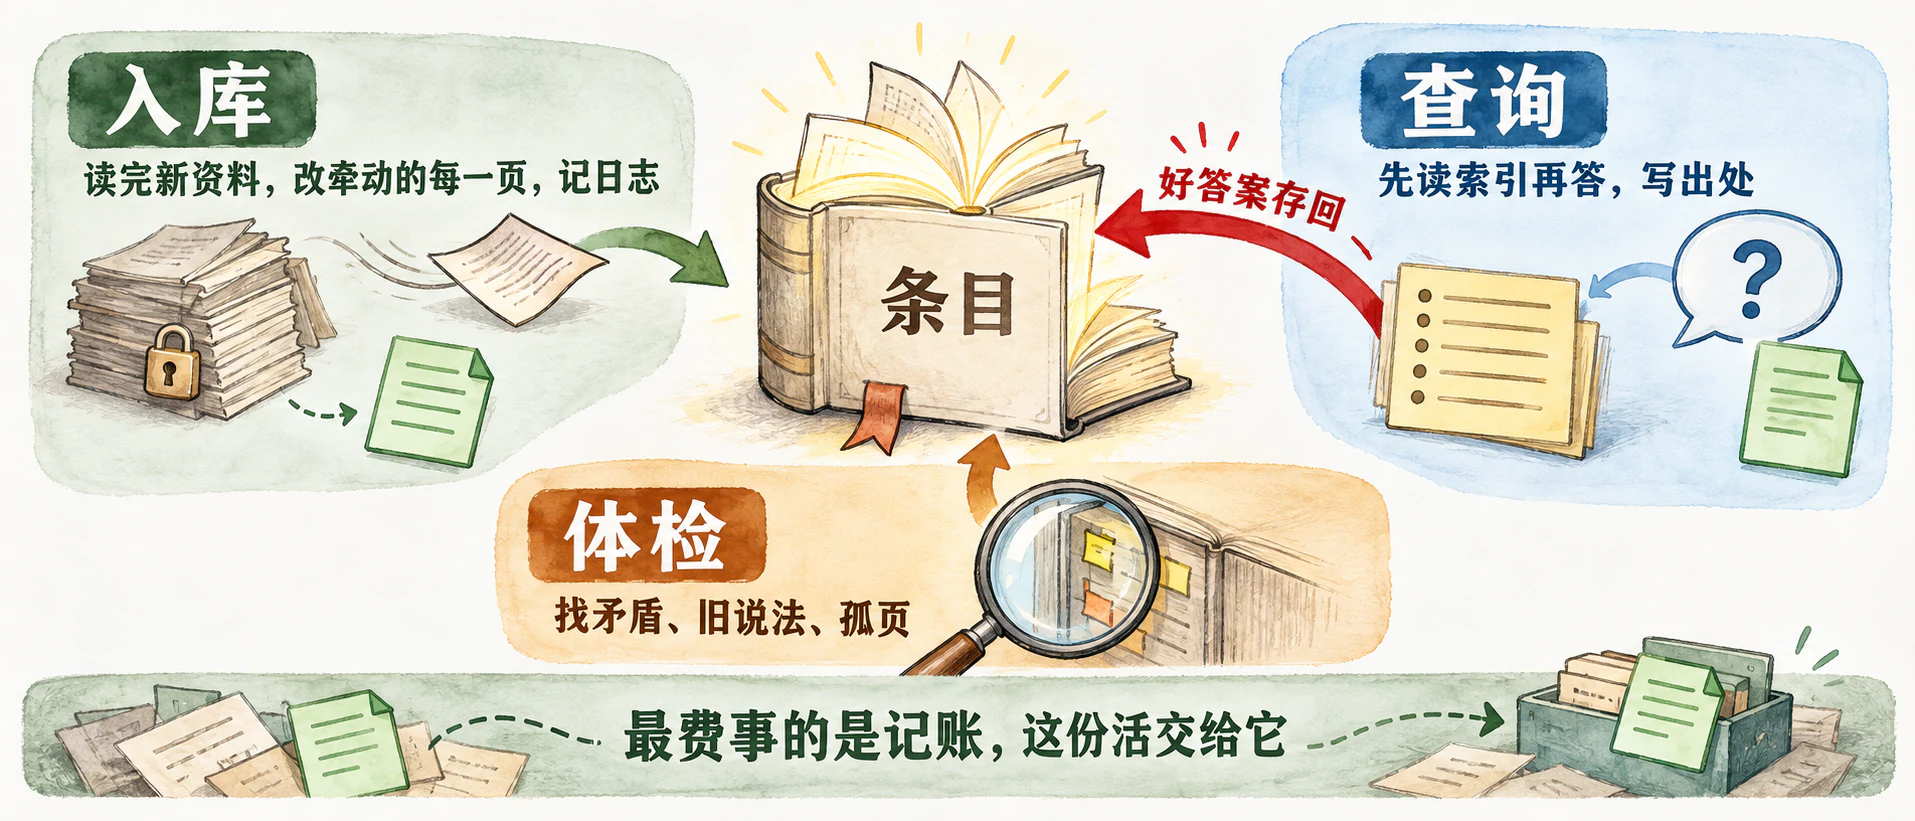
日常三个动作:入库、查询、体检
“The tedious part of maintaining a knowledge base is not the reading or the thinking — it’s the bookkeeping.” 维护一个知识库最费事的不是读和想,是记账。
入库 :读完新资料,改它牵动的每一页,和旧说法对不上的标出来,改索引,记日志。查询 :先读索引、找到相关页再答,写出处;答得好的对比和结论,存回成新的一页 。体检 :隔一阵扫一遍,找矛盾、被推翻的旧说法、没人链接的孤页。
Andrej Karpathy, LLM Wiki (GitHub Gist,2026 年 4 月)
IV 演示 C
演示 C:问文献维基一个问题
任务
13 篇关于自动化与劳动市场的论文,已经编成概念页、机制页、争议页。用
/wiki-query 问:“自动化为什么不一定减少劳动需求?哪几篇论文怎么说?”
要看到
工具记录里:先读
wiki/_index.md → 进概念页或综合页 → 要细节时才打开原文。答案不是现场从 13 篇 PDF 里拼的,是从编好的页面里取的
怎么验收
答案提到
替代效应 与
恢复效应 两条机制;至少两处出处能在原文里找到对应段落
WorkBuddy 怎么做 WorkBuddy 读技能的位置是 .workbuddy/skills/;这个库目前只在 Claude Code 上跑过
literature-wiki/13 篇论文
raw_pdfs/PDF 原件 13
raw_markdown/转成的文本 13
wiki/
_index.md总索引
sources/每篇一页 13
concepts/概念 7
mechanisms/机制 5
debates/争议 3
synthesis/综合 3
log.md日志
文献维基 literature-wiki 的演示实例:Acemoglu 及合作者关于自动化与劳动市场的 13 篇论文
IV LLM-wiki
一页条目长什么样
wiki/concepts/displacement-effect.md
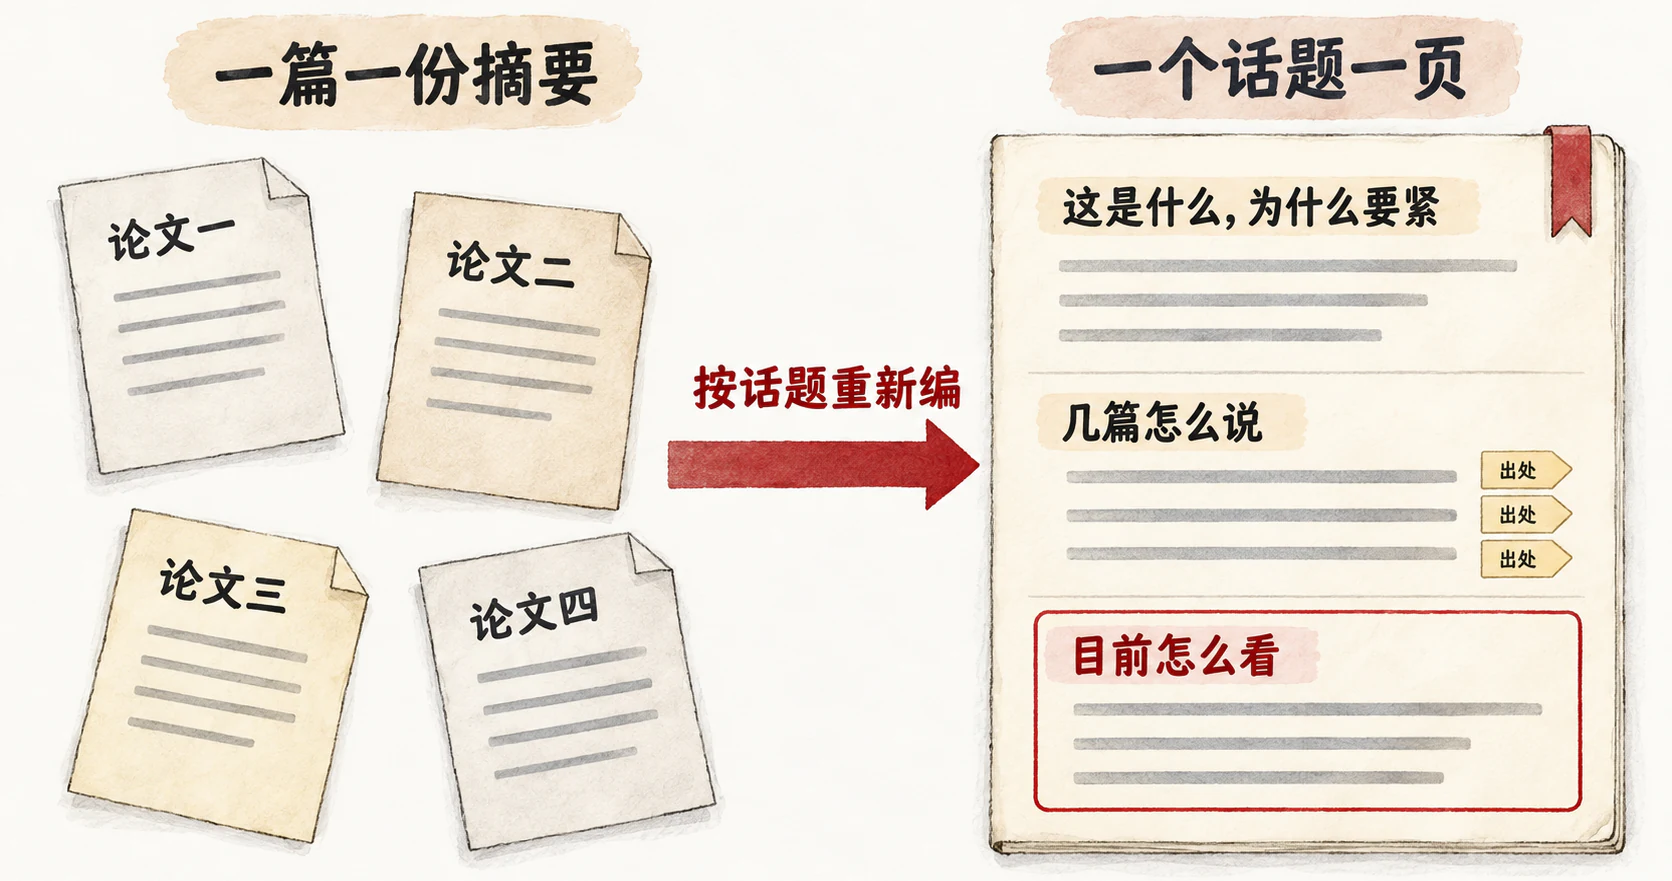
Displacement Effect(替代效应) 开头一段:它是什么、为什么要紧
Definition and Formal Mechanism Displacement and the Labor Share Displacement vs. Productivity Effect Empirical Evidence: US Wage Bill 1947–2017 … 共 10 个小节,引自 6 篇论文 Current assessment (2026-06) 目前怎么看:替代效应是任务框架里证据最扎实的机制之一……
每个说法后面带出处(作者,年份)
不是一篇论文一份摘要,而是一个话题一页 :几篇论文的说法放在一起比,每个说法带出处,最后一个框写“目前怎么看”。
右栏摘自文献维基演示实例的概念页 displacement-effect
IV LLM-wiki
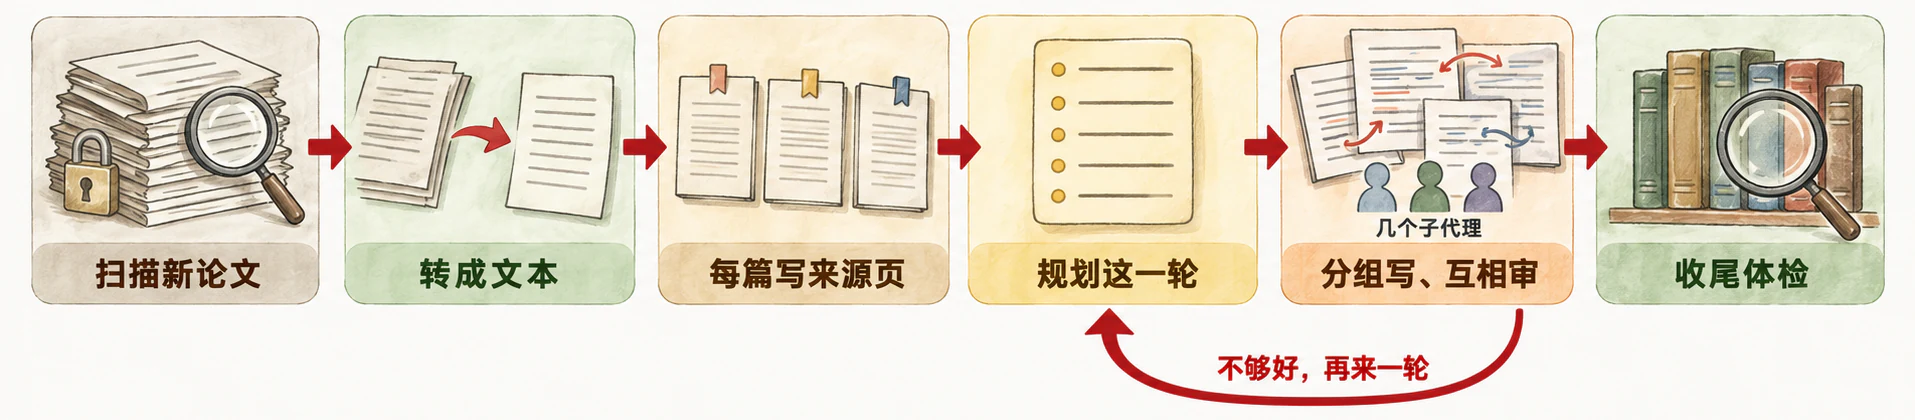
编一页要读完所有相关论文:分几轮、几个子代理分头写
第五站:几个子代理 分组写、互相审;写得不够好,回到第四站再来一轮
建库是一条流水线:扫描新论文 → 转成文本 → 每篇写一页来源页 → 规划这一轮要写哪些页 → 分组写、互相审 → 不够好再来一轮 → 收尾体检。分组写、互相审,就是 W06 学的多智能体分工。13 篇论文建一次库,要派几个子代理跑好几轮。
文献维基 literature-wiki 的建库技能 wiki-build
IV LLM-wiki · 看建库
演示:七篇论文,建一个多层维基文献库
IV LLM-wiki
编出来的东西也会错
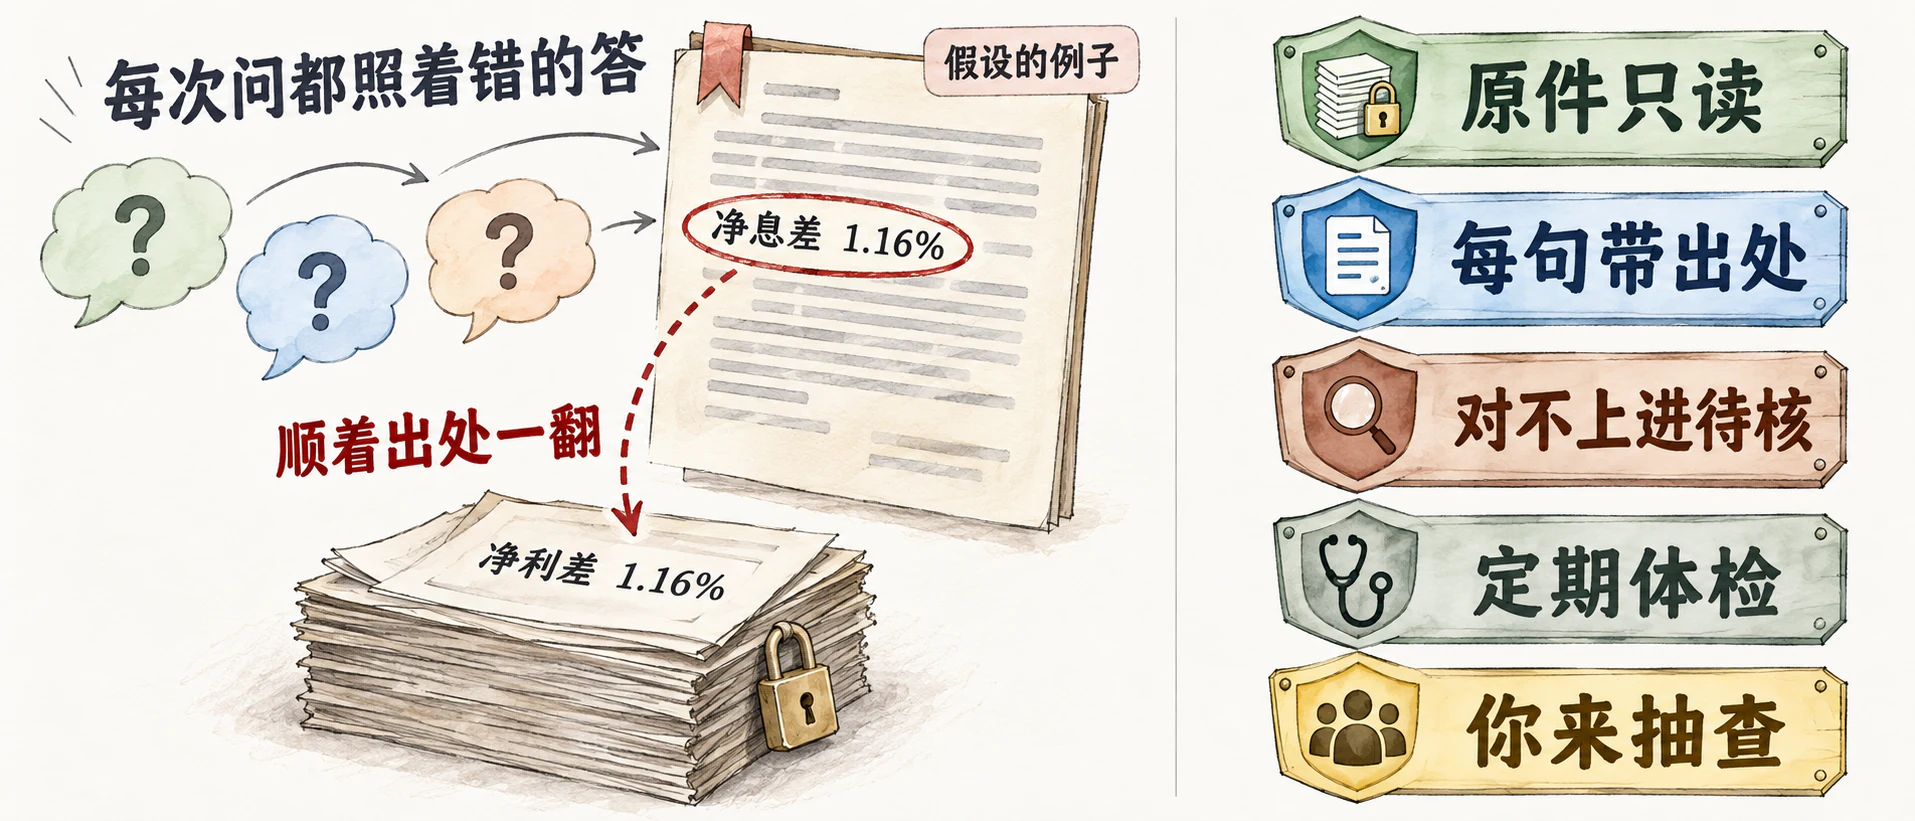
微软研究院 2026 年的实验:让前沿模型连着多轮改文档,20 轮下来平均改坏约四分之一的内容,错误少但严重,悄悄累积
编错一句,以后每次问都照着错的答。对策五条:原件只读 ,出了事有底可查;每句带出处 ,一翻就知道错在哪;对不上进“待核” ,不替你挑;定期体检 ;你来抽查 ,越笃定越要核。
Laban, Schnabel & Neville, LLMs Corrupt Your Documents When You Delegate , arXiv:2604.15597 (2026)
IV LLM-wiki
同一个模板,换一个领域
文献维基(小) 原文 13 篇
sources/13 concepts/7 mechanisms/5 debates/3 其他8 共 36 页
产权与组织经济学 原文 262 篇
sources/268 concepts/27 mechanisms/18 debates/7 其他11 共 331 页
叙事经济学 原文 62 篇
sources/47 concepts/13 mechanisms/6 synthesis/8 其他10 共 84 页
一本数学书 原文 1 本书
theorems/637 examples/28 methods/26 concepts/22 其他39 共 752 页
都是同一套三层和同一组建库、查询技能。换领域不用重写流程,换的是原件和规则 ;条目分几类,由模型读完原件后提议,你来改。
各库 raw_markdown/ 原文数与 wiki/ 下页面数(不含规则与模板文件),统计于 2026-10-25;sources/ 与原文数不完全相等:有的经典著作只写了来源页、没有原文,有的原文还没编进来
V 收束
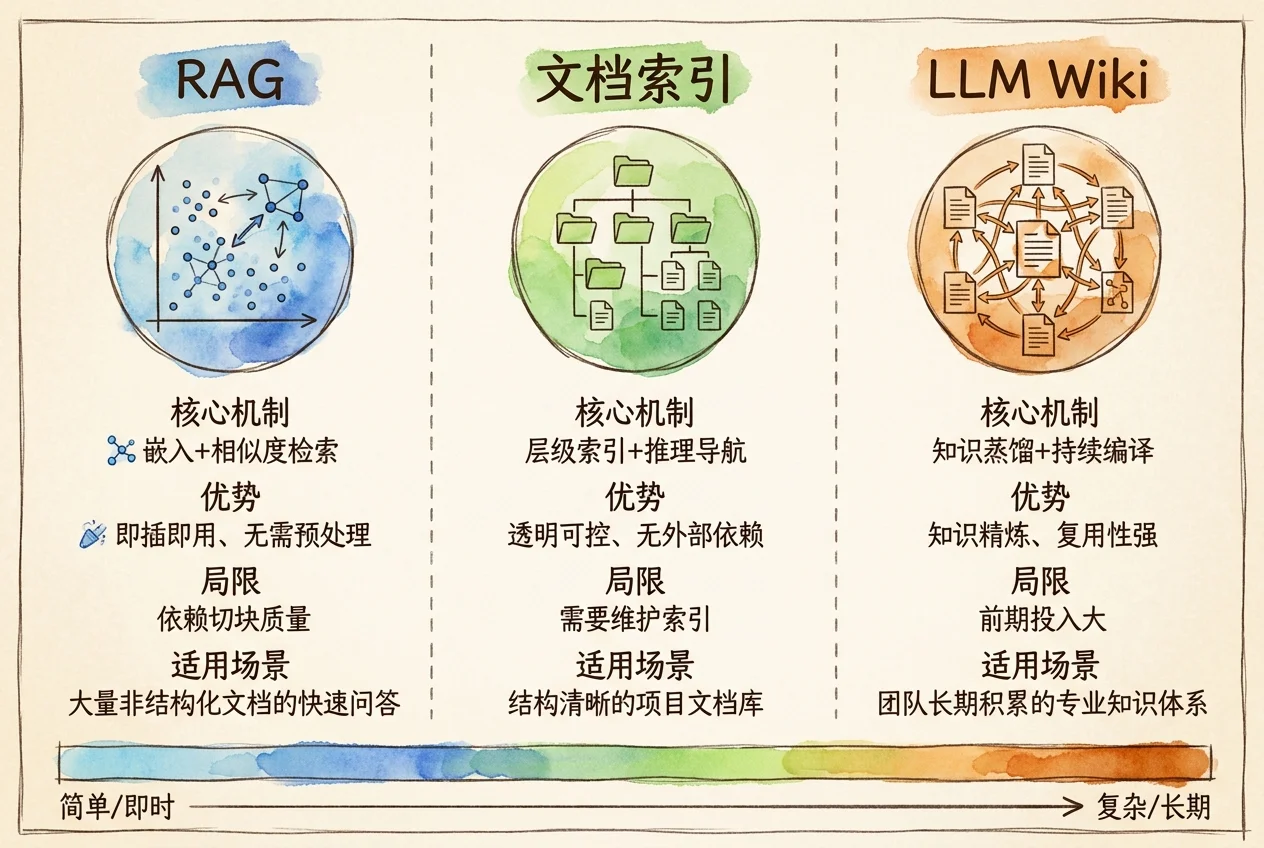
三种办法放在一起比
什么时候干活 RAG 和带索引的文件夹都在问的时候找,LLM-wiki 在资料来的时候就编好
谁来挑 RAG 是程序按像不像,文件夹是模型按目录推理,wiki 是模型事先编好
会错在哪 召回错段照着答;索引没更新被带偏;编错一句一直错
V 收束
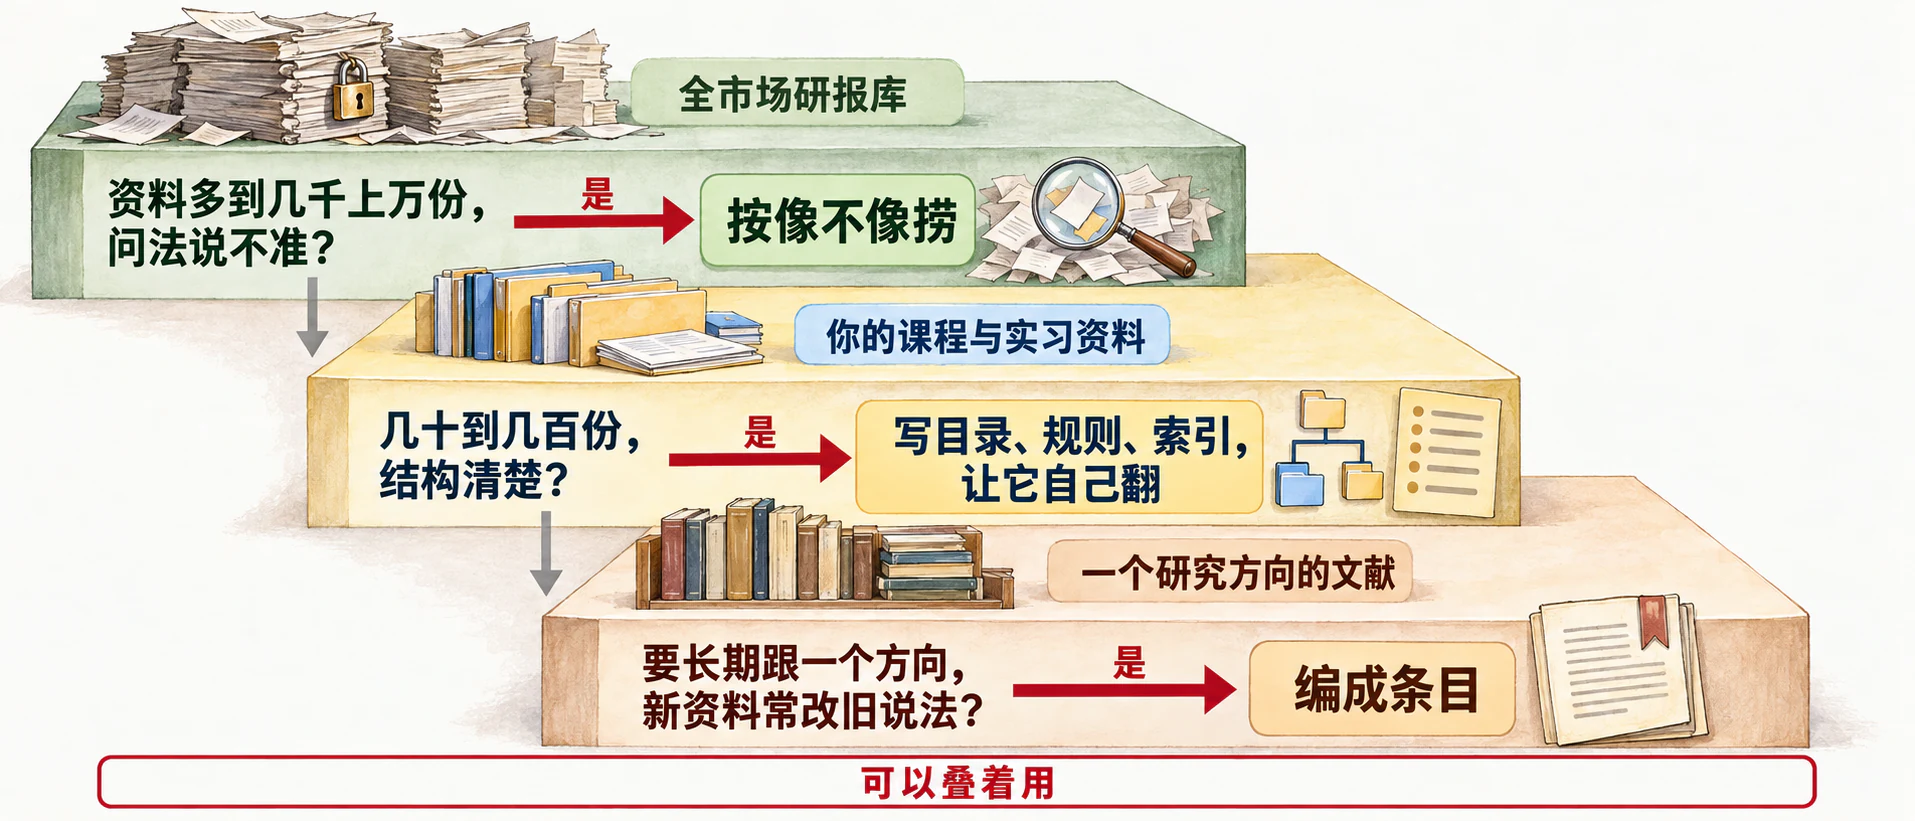
怎么选:三个问题挨个问
用 RAG 时,年份、公司这类条件先筛,再比像不像
① 资料多到几千上万份、谁也说不准会怎么问?选 RAG。② 几十到几百份、结构清楚?写目录、规则和索引,让它自己翻,什么都不用另装。③ 要长期跟一个方向、新资料常改旧说法、要知道哪里打架?编成 wiki。
V 收束
可以叠着用
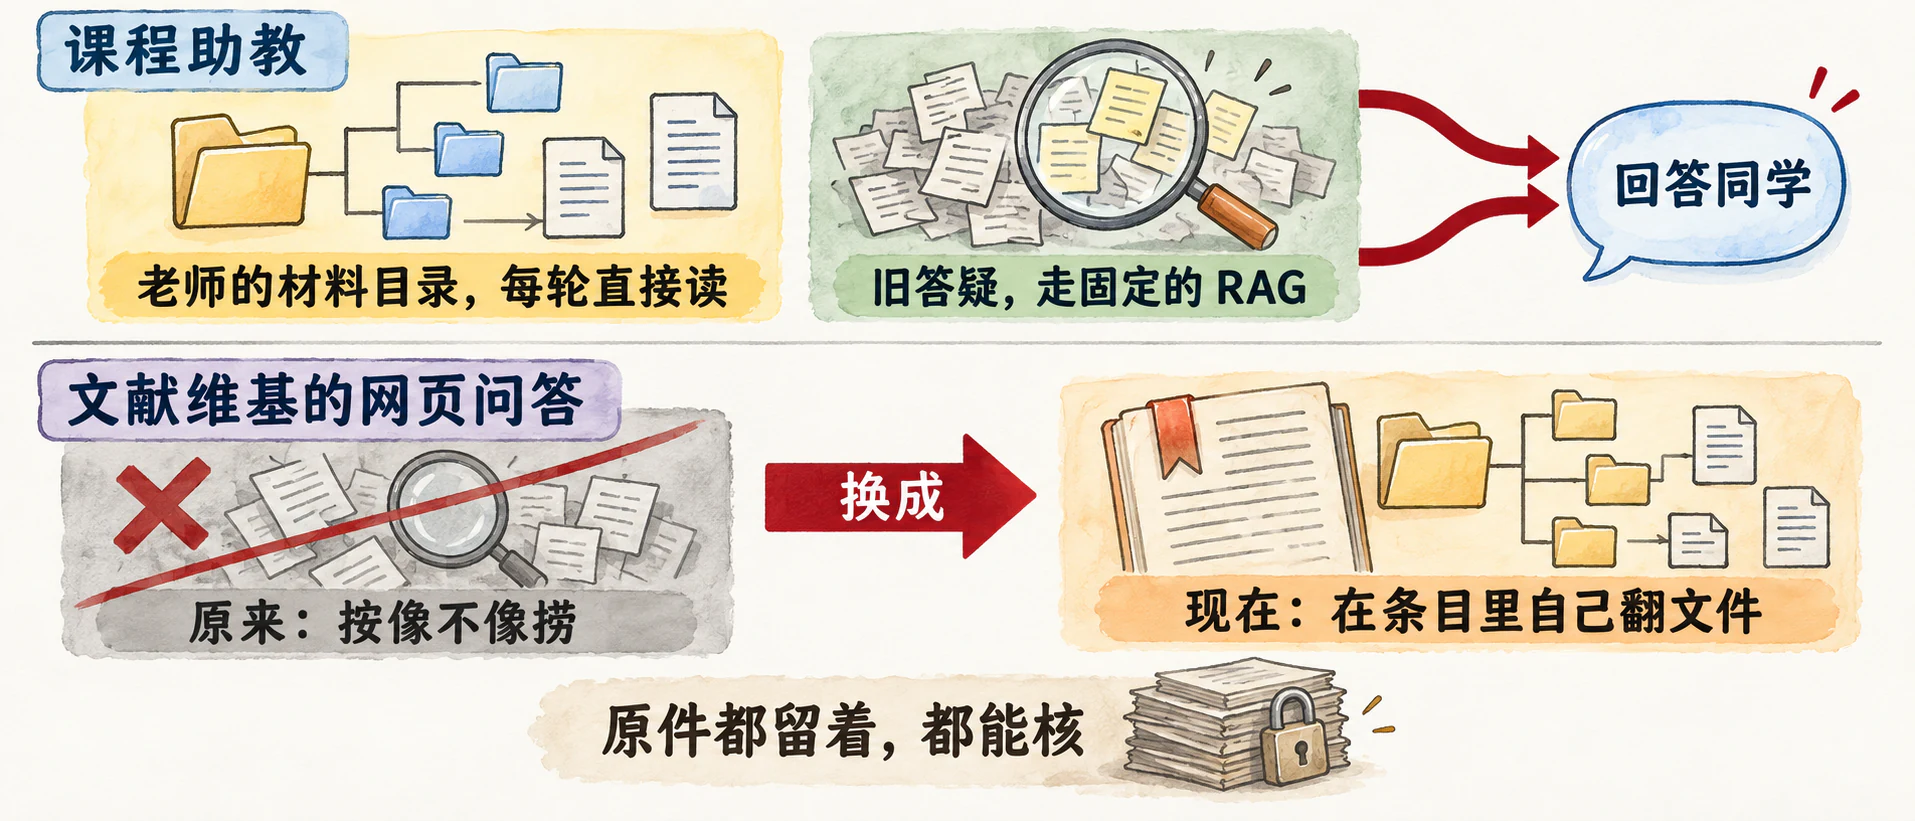
常被问的编成条目,量大、偶尔才查的原件放进 RAG。不管哪种,原件都要留着、都要能核。
课程助教与文献维基网页问答的资料架构
V 复盘
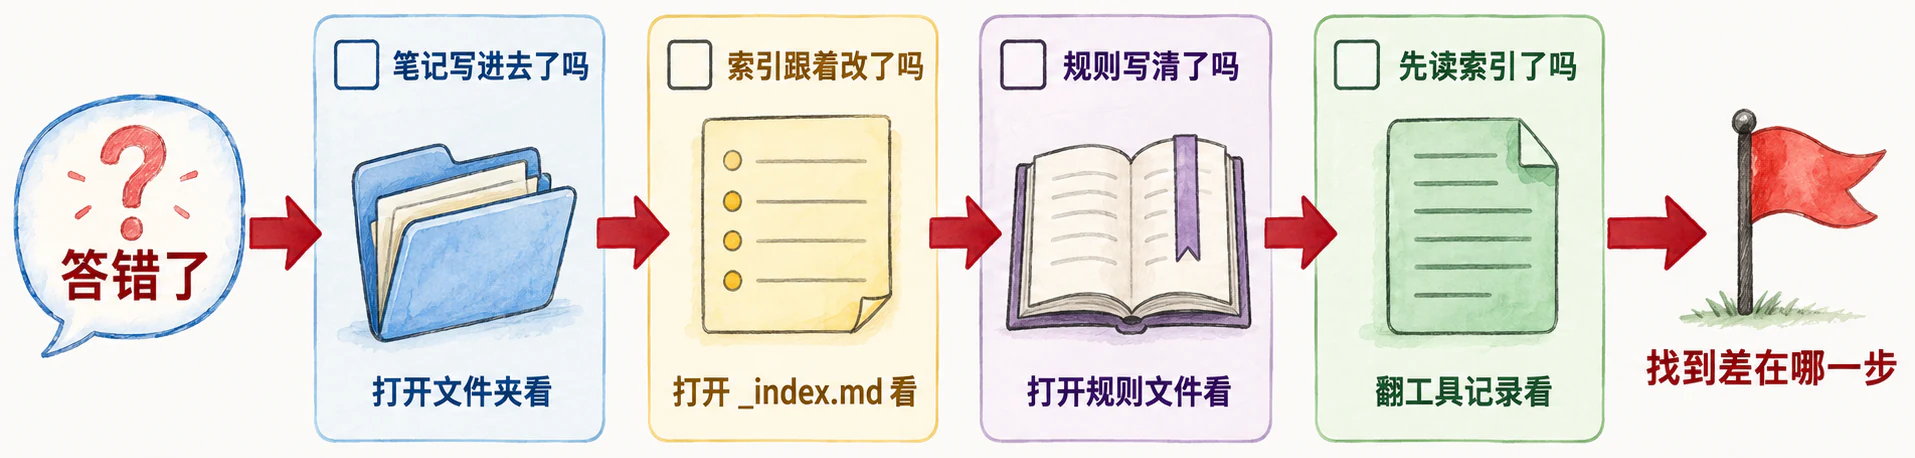
复盘:谁的库答错了
问题 预期答案 它的答案与出处 差在哪一站 小组项目下一步谁做什么? 许昊天交平台数据…… ……(出处:5_会议/…) 索引跟着改了吗?
同一个问题,答案或出处为什么不同?再对一对:哪种错是 RAG 会犯的,哪种是 wiki 会犯的。